¿Qué herramientas usan los forward-deployed engineers? Un stack abierto y ontología-first
Qué construye de verdad un forward-deployed engineer en un deployment de 60–180 días, los cinco dolores que definen el trabajo y por qué la ola de imitadores de 2026 copió el rol pero no el sustrato que hay debajo.
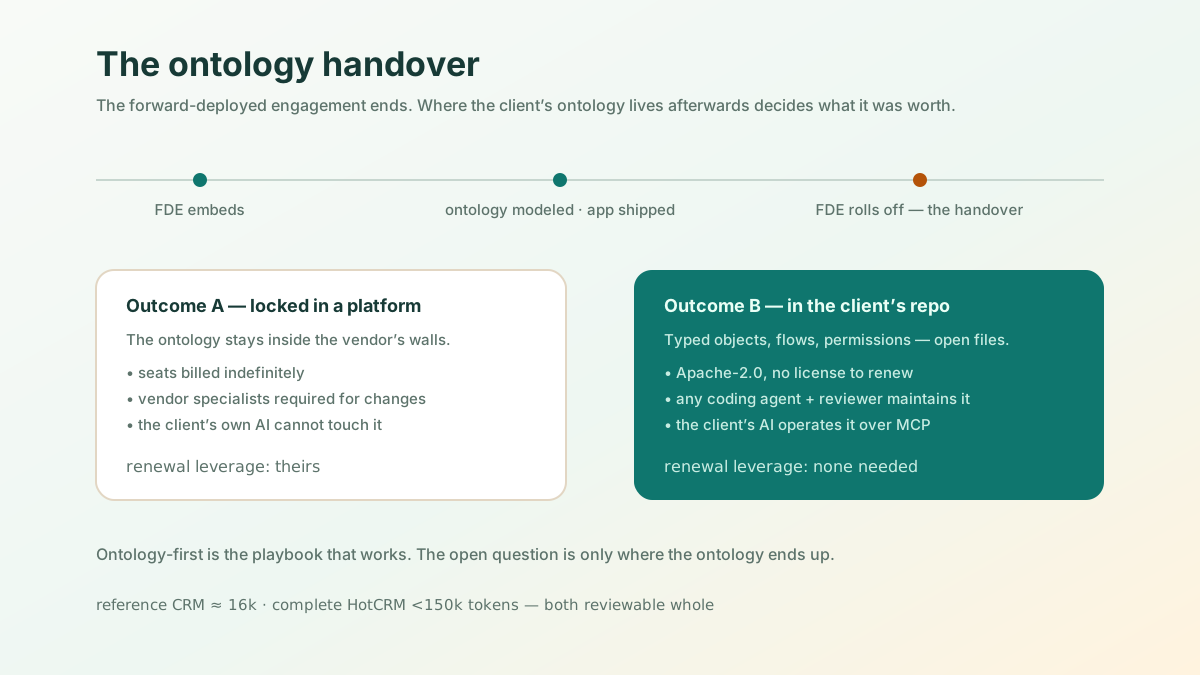
La versión corta: la ingeniería forward-deployed es el rol que más crece en la AI empresarial — las ofertas de empleo crecieron un 1.165 % interanual según el recuento de Live Data Technologies, difundido por el marketplace de reclutamiento Paraform — y en 2026 OpenAI, Anthropic, AWS y Microsoft montaron cada uno su propia organización forward-deployed. El playbook que todos copian es el método ontología-first de Palantir. Este artículo trata las dos cosas que el contenido de reclutamiento nunca cubre: qué construye de verdad un FDE a lo largo de un deployment de 60–180 días, y por qué la ola de imitadores copió el rol pero no el sustrato que hay debajo. En medio están los cinco dolores recurrentes de hacer este trabajo sobre un stack artesanal — la fontanería devora el engagement, las demos mueren en la revisión de seguridad, los requisitos cambian más rápido que el código, los patrones nunca capitalizan entre clientes, la entrega envenena la relación — y cómo un stack abierto y ontología-first elimina cada uno. Termina con la pregunta que creemos que definirá la próxima ola del rol: la entrega de la ontología. ¿La ontología del cliente sale del engagement como archivos abiertos y tipados en su repo, o como palanca de renovación en la plataforma de otro?
El trabajo que nadie describe con honestidad
Las ofertas hablan de «ambigüedad 0→1» y bandas de 300–550K $ (Perspective AI, TechTarget). El trabajo real es hacer que la AI funcione dentro de los muros de otro: sus datos, sus permisos, su oficina de cumplimiento, su definición de «suficiente». Palantir codificó el método hace años: sus AI FDEs construyen primero una ontología específica del cliente antes de entregar cualquier aplicación LLM y dedican el 30–40 % de la semana al discovery (guía AI FDE de Palantir). El método es correcto. Dónde se va la semana de verdad lo decide la herramienta que hay debajo.
Qué construye de verdad un forward deployed engineer
Un deployment dura unos 60–180 días y produce cuatro artefactos antes de la entrega, en un orden fijo, porque cada uno es la entrada del siguiente. Esta es justo la parte que ninguna oferta de empleo describe:
| Día del deployment | Lo que realmente se escribe | Terminado cuando |
|---|---|---|
| 0–15 · Adaptadores de ingesta | Un adaptador por sistema origen — su ERP, su herramienta de tickets, la hoja de cálculo que en secreto es la fuente de verdad. Primero las rutas de lectura: conectar, no migrar. | Un objeto de negocio en pantalla muestra una fila real que salió de su sistema esta mañana. |
| 15–45 · Resolución de entidades | La mitad sin glamour que nadie enseña en una demo. «Cliente» son cuatro claves distintas en cuatro sistemas: escribes las reglas de match, las de supervivencia y el identificador que la ontología trata como canónico. | Dos registros de la misma empresa se fusionan — y el responsable de operaciones del cliente coincide en que debían hacerlo. |
| 30–60 · Mapeo de permisos | Su organigrama traducido a roles, conjuntos de permisos, compartición por filas y reglas de campo, incluidos los campos que solo tres personas pueden ver. | La revisión de seguridad es leer un archivo en vez de una reunión: un revisor puede señalar quién ve qué. |
| 45–90 · Los primeros flujos | Dos o tres procesos de punta a punta — una cadena de aprobación, una cola de triaje, una renovación — con las acciones, vistas y notificaciones alrededor. | Alguien que no trabaja para ti termina un día real de trabajo en la app. |
| 90–180 · Entrega | Datos semilla, fixtures de aceptación, etiquetas traducidas, la app empaquetada y una checklist de revisión que su equipo pueda ejecutar de verdad. | Sus propios ingenieros publican un cambio sin llamarte. |
Fíjate en lo que comparten las primeras cuatro filas: ninguna es código de aplicación en el sentido habitual. Son definiciones — qué existe, qué cuenta como la misma cosa, quién puede hacer qué, cómo fluye el trabajo. Sobre un stack artesanal cada una se expresa igualmente como código, y por eso muerden los dolores de abajo.
El deployment número dos es donde el modelo paga o falla. Nada de esa tabla es tan específico del cliente como parece mientras lo haces. La resolución de entidades de «cliente» es estructuralmente el mismo problema en el siguiente cliente con otras claves; una cadena de aprobación tiene la misma forma con otros umbrales y otro rol aprobador. Así que el segundo engagement tiene una sola cifra que merece medirse — llámala ratio de renombrado: la proporción del deployment dos que es un renombrado de definiciones tipadas que ya posees, frente a una reescritura. En una base de código artesanal ese ratio es casi cero y nadie lo nota, porque el deployment dos igual se entrega; simplemente cuesta lo que costó el uno. En metadatos tipados es contable, porque la superficie es finita: un engagement del tamaño de HotCRM son 15 objetos, 17 flujos, 10 acciones, 6 perfiles de permisos y 5 reglas de compartición. Literalmente puedes listar lo que hereda el siguiente cliente.
Ese es el trabajo. El resto del artículo son los cinco dolores recurrentes que hacen cada fila de esa tabla más dura de lo que debería ser — y qué los elimina.
Dolor 1 — La semana uno siempre es fontanería
Todo engagement empieza igual: antes de mostrar un solo objeto de negocio en pantalla necesitas auth, SSO, roles, APIs CRUD, una UI de administración, almacenamiento de archivos y una tabla de auditoría. Nada de eso es la razón por la que el cliente te contrató. Tu diferenciador — el 30–40 % del tiempo dedicado a entender su negocio — queda aplastado por el 60 % dedicado a reconstruir el mismo sustrato indiferenciado que ya construiste para el cliente anterior.
Lo que cambia el stack: el sustrato ya está. Un comando y, antes de comer, están corriendo la Console, el login con SSO, los permisos de rol/fila/campo, el log de auditoría, las APIs REST y un servidor MCP:
npm create objectstack@latest client-app && cd client-app
npx os dev --ui   # Console en :3000 — auth, RBAC y auditoría ya aplicados
Todo lo derivable lo deriva el runtime. Lo único que queda por escribir es lo único que solo tú puedes escribir: los objetos, flujos y reglas de permisos del cliente. La semana uno se convierte en discovery y modelado — el trabajo en el que de verdad te diferencias.
Dolor 2 — La demo que muere en la revisión de seguridad
Conoces el arco. Viernes de la semana uno: una demo pegada con cinta — una UI improvisada sobre un CSV copiado — y la sala aplaude. Mes dos: infosec entra con tres preguntas. ¿Qué puede ver exactamente la AI? ¿Con permisos de quién actúa? ¿Dónde está el registro de auditoría? Para un stack de demo, la respuesta honesta es una reconstrucción, y la reconstrucción es donde mueren los engagements.
Lo que cambia el stack: la gobernanza es el sustrato, no un parche posterior. La puerta de validación ni siquiera acepta un objeto sin modelo de compartición declarado:
export const Ticket = ObjectSchema.create({
  name: 'support_ticket',
  label: 'Ticket',
  sharingModel: 'private',        // obligatorio — sin él, la puerta lo rechaza
  fields: {
    subject:  Field.text({ label: 'Subject', required: true }),
    status:   Field.select({ label: 'Status', options: [/* los estados reales del cliente */] }),
    approver: Field.lookup('sys_user'),
  },
});
En runtime, cada llamada — UI humana, REST o un agente de AI por MCP — pasa por el mismo RBAC, la misma seguridad de fila y de campo, y aterriza en el mismo log de auditoría. Cuando infosec pregunta «¿qué puede ver la AI?», la respuesta es un archivo que pueden leer: metadatos de permisos aplicados por el runtime, no una promesa en una diapositiva. Tu demo del viernes y tu despliegue de producción son el mismo artefacto. No hay reconstrucción, porque nunca existió una versión sin gobernanza.
Dolor 3 — Los requisitos cambian más rápido que el código
A mitad de reunión, el líder de operaciones dice: «por cierto, los descuentos de más del 20 % pasan primero por los gerentes regionales». En una base de código artesanal eso es una migración de esquema, tres cambios de API, un cambio de UI y una semana — y a ojos del cliente, te volviste lento justo cuando él se volvió concreto. El trabajo forward-deployed vive o muere por la velocidad de iteración dentro de la sala.
Lo que cambia el stack: toda la aplicación es metadato tipado y compacto. La referencia CRM incluida tiene 1.792 líneas, unos 16k tokens (cuéntalo: find examples/app-crm/src -name '*.ts' | xargs cat | wc -l); el HotCRM completo se mantiene por debajo de 150k tokens en total — lógica de negocio bajo 100k y unos 50k más para la UI. A cualquier escala, tu agente de código sostiene el sistema entero en contexto: el cambio de la cadena de aprobación es un diff coherente que cruza flujo, permisos y UI, escrito antes de que acabe la reunión, validado por os validate, previsualizado en vivo en la Console. «¿Qué se rompe si cambiamos esto?» es una pregunta que el agente puede responder de verdad, porque lo ve todo. Los cambios de requisitos dejan de amenazar el calendario y se convierten en la demo.
Dolor 4 — Tus patrones nunca capitalizan
El código de la cadena de aprobación del cliente A no se puede levantar hacia la base de código del cliente B — versiones de framework distintas, auth distinta, todo distinto. Así que cada engagement empieza de cero, y una boutique de tres personas nunca puede construir la palanca que hace funcionar la economía del modelo de Palantir. Esta es la razón silenciosa por la que las consultoras forward-deployed siguen siendo pequeñas.
Lo que cambia el stack: los patrones son metadatos tipados, y los metadatos tipados son portables. La cadena de aprobación que modelaste para el cliente A es una definición de flujo que sueltas en el repo del cliente B y renombras. Con los engagements acumulas una biblioteca propia — objetos, flujos, conjuntos de permisos, datos semilla — que tu agente aplica al siguiente cliente en minutos. Y no empiezas la biblioteca de cero: HotCRM es una referencia completa y forkeable — 15 objetos, 17 flujos, 4 dashboards, 2 copilotos de AI, 4 idiomas — construida como ejemplo canónico de las convenciones. Haz fork, renombra el namespace, y tu engagement arranca desde un sistema que funciona en lugar de un repo vacío.
Dolor 5 — La entrega envenena la relación
Todo engagement termina, y hoy termina mal de una de dos maneras. Entrega una plataforma y el cliente alquila su propia ontología para siempre — te has convertido en canal de ventas de otro, y él ha aprendido a temer los pilotos exitosos: cuanto mejor la ontología, más profundo el lock-in. Entrega una base de código a medida y su equipo no puede mantenerla; se pudre, y dieciocho meses después esa podredumbre lleva tu nombre.
Lo que cambia el stack: esto es la entrega de la ontología — el final que el playbook FDE nunca resolvió. Lo que entregas es el repo del cliente: objetos, flujos y permisos tipados bajo Apache-2.0, más el artefacto compilado y una checklist de revisión. Su equipo de seguridad puede inspeccionar la definición entera — la referencia incluida son 16k tokens y hasta el HotCRM completo queda bajo 150k, no 300.000 líneas de código. Sus propios agentes de código lo mantienen con el mismo bucle que tú usaste, porque el formato nació para ser escrito por agentes. Si quieren la plataforma operada — AI Builder en el navegador, cloud o self-managed — está ObjectOS, sobre la misma definición abierta; pueden irse sin perder la ontología. Tu siguiente contrato se gana con trabajo nuevo, no se extrae con lock-in. Esa diferencia es tu reputación, capitalizando.
El kit completo de metadatos del FDE
La ontología no es solo el modelo de datos. Un engagement forward-deployed usa un tipo de metadato para cada fase, del discovery a la entrega — y todos son la misma clase de definición tipada, validable y portable:
| Fase | La pregunta del cliente que respondes | Tipos de metadatos que usas |
|---|---|---|
| 1 · Modelar los sustantivos | «¿Qué existe en nuestro negocio?» | Objetos y campos (relaciones, reglas de validación, fórmulas) · datasources (conectar bases de datos existentes, sin migración) · datos semilla (para demos y aceptación) |
| 2 · Modelar los verbos | «¿Cómo fluye realmente el trabajo?» | Flujos (cadenas de aprobación, máquinas de estados, triggers de registro, programaciones) · aprobaciones (multinivel, colas, bloqueo de registro) · acciones (botones y operaciones de servidor con permisos verificados) |
| 3 · Pantallas para personas | «¿Dónde trabaja nuestra gente?» | Apps y navegación · vistas (lista/kanban/calendario/gantt) · páginas y formularios · dashboards e informes (los KPI que piden los ejecutivos) |
| 4 · Pasar la revisión de seguridad | «¿Quién puede ver y hacer qué?» | Conjuntos de permisos y roles (RBAC) · seguridad de fila y de campo · reglas de compartición · auditoría (integrada en el runtime — declarada, entregada) |
| 5 · La AI que el cliente quiere de verdad | «¿Qué puede hacer la AI por nosotros?» | Agentes de AI (copilotos de ventas/soporte) · herramientas y skills de AI · exposición MCP (ai: { exposed: true }) |
| 6 · Entrega y capitalización | «¿Qué pasa cuando te vayas?» | Traducciones (etiquetas multiidioma para clientes globales) · manifiesto y empaquetado (compilar a un objectstack.json, instalable en cualquier entorno) |
La clave: las seis capas son la misma sustancia. Una cadena de aprobación es metadato tipado exactamente igual que el modelo de datos, y un agente de AI también — la misma puerta de validación los revisa, el mismo diff los evalúa, el mismo repo los entrega:
// The client's verbs: a discount approval — typed metadata, same as an object
export const DiscountApproval: Flow = {
  name: 'discount_approval',
  label: 'Discount Approval',
  type: 'record_change',
  status: 'active',
  nodes: [
    { id: 'start', type: 'start', label: 'Start',
      config: { objectName: 'crm_quote', triggerType: 'record-after-update',
                condition: 'record.discount > 0.20' } },
    { id: 'review', type: 'approval', label: 'Regional Manager Review',
      config: { approvers: [{ type: 'position', value: 'regional_manager' }], lockRecord: true } },
    { id: 'end', type: 'end', label: 'End' },
  ],
  edges: [/* start -> review -> end */],
};

// The AI the client actually wants: a service copilot — still metadata
export const ServiceCopilot = defineAgent({
  name: 'service_copilot',
  label: 'Service Copilot',
  instructions: 'Help support reps triage and resolve cases. Retrieve only within the user\'s permissions. Always cite case IDs.',
  skills: ['case_triage', 'customer_360'],
  knowledge: { topics: ['support_kb', 'sla_policies'] },
});
HotCRM es la demostración completa de este vocabulario en uso: 15 objetos, 17 flujos, 10 acciones, 4 dashboards, 2 copilotos de AI, 6 skills, 6 perfiles de permisos, 5 reglas de compartición y 4 idiomas — todas las capas presentes, menos de 150k tokens en total: lógica de negocio bajo 100k y unos 50k más para la UI. El conjunto cabe en una sola ventana de contexto de agente.
La ola de imitadores de 2026 copió el rol, no el sustrato
En un solo año el sector decidió que así es como se entrega la AI empresarial. Cada una de estas líneas es un compromiso fechado de la empresa que lo hizo, que es lo único que lo hace citable:
| 2026 | El compromiso | Anunciado por |
|---|---|---|
| Mayo | OpenAI lanza una compañía de deployment de propiedad mayoritaria con más de 4.000 M$ comprometidos, adquiriendo la consultora Tomoro y unos 150 forward-deployed engineers con ella | OpenAI |
| 11 de junio | Anthropic y DXC anuncian una alianza plurianual para formar a decenas de miles de ingenieros forward-deployed certificados en Claude, dentro de los sistemas que DXC ya opera para bancos, aerolíneas y aseguradoras | Anthropic |
| 30 de junio | AWS destina 1.000 M$ a una unidad de forward-deployed engineering, con pods de cinco o seis ingenieros embebidos en el cliente | CNBC |
| 2 de julio | Microsoft monta Frontier — 2.500 M$ y 6.000 empleados — para hacer el mismo trabajo | CNBC |
Otras dos cifras circulan con esta ola y merecen que se declare su procedencia en vez de repetirlas. El +1.165 % interanual en ofertas de FDE es el recuento de Live Data Technologies, difundido por Paraform — un marketplace de reclutamiento cuyo negocio es contratar FDEs — y cuenta ofertas, no puestos cubiertos. El «equipo de 1.000 FDEs» de Salesforce sale del blog de la propia Salesforce: una declaración de intenciones, no una plantilla divulgada. Ambas son reales en dirección y ninguna está auditada.
Y ahora la parte que importa para el trabajo. Cada compromiso de la tabla está denominado en ingenieros y dólares. Ninguno está denominado en lo que decide si el deployment dos cuesta menos que el uno: dónde acaba escrito el output del ingeniero. El método de Palantir funciona porque el FDE escribe en una ontología específica del cliente y la aplicación se deriva de ella — el sustrato es el producto, y los ingenieros son cómo llega al cliente. Contrata a la misma persona en una organización sin sustrato y el trabajo seguirá pareciendo idéntico desde fuera durante un año aproximadamente.
Por eso la pregunta útil para cualquier organización forward-deployed — aquella a la que te incorporas, a la que compras o la que estás montando — no es cuántos ingenieros tiene. Son tres preguntas sobre el sustrato:
- Cuando el ingeniero se va, ¿en qué archivo aterrizó el trabajo? Un ticket, un notebook y un servicio a medida no son respuesta; una definición tipada en el repositorio del cliente sí.
- ¿Puede el cliente leerla sin ti? Si la definición solo es legible dentro de la consola de un proveedor, el cliente está alquilando su propia ontología, y cuanto mejor sea tu trabajo, más hondo cala.
- ¿Qué heredó el deployment dos del uno? Pide la lista. Si nadie puede producirla, el ratio de renombrado es cero.
La respuesta de este artículo a las tres es la misma, y es la razón del enfoque ontología-first de todo lo anterior: el artefacto es una ontología de negocio abierta — objetos, flujos y permisos tipados en el propio repositorio del cliente bajo Apache-2.0 — que el cliente puede leer, conservar y entregar a sus propios agentes de código. Copiar el rol es un plan de contratación y lleva un trimestre. Copiar el sustrato significa hacerlo lo bastante abierto como para que un cliente quiera conservarlo, y esa es una decisión de producto que casi nadie en la ola de 2026 ha tomado.
Lo que este stack no arregla
Tratando con justicia a las alternativas: la federación de datos y los pipelines analíticos a escala Foundry son el terreno de Palantir — si el engagement va de fusionar petabytes entre cuarenta sistemas legacy, esa es otra clase de herramienta. La gestión del cambio organizacional no la arregla ningún stack. Y un cliente ya estandarizado por completo en una plataforma cerrada puede, racionalmente, quedarse. La afirmación es más estrecha: para la capa de aplicación del trabajo forward-deployed — modelar un negocio y entregar apps gobernadas sobre él — los cinco dolores de arriba ahora son eliminables, y la ontología puede entregarse en lugar de retenerse como rehén.
La checklist del FDE
- Modela los sustantivos y verbos del cliente como objetos y flujos antes de cualquier conversación de UI.
- Mantén la definición completa a escala de contexto para que tu agente pueda razonarla y refactorizarla entera.
- Permisos conservadores por defecto; todo cambio de autoridad explícito en el diff.
- Entrega el repo, el artefacto compilado y una checklist de revisión — no un login a tu tenant.
- Deja MCP habilitado para que la propia AI del cliente opere la app dentro de sus permisos.
- En el deployment dos, cuenta el ratio de renombrado. Si no se transfirió nada, el problema es el sustrato, no el engagement.
Prueba el bucle
Apunta tu agente de código al stack abierto — el scaffold trae AGENTS.md y el paquete de skills, así que el agente arranca con las reglas del formato cargadas:
npm create objectstack@latest client-app && cd client-app
npx os dev --ui   # la app funcionando — modela el primer objeto con tu agente
Para clientes que quieren la plataforma operada, ObjectOS es la plataforma comercial de producción y operación sobre ObjectStack — construye y pregunta online, con despliegue gestionado o privado y gobernanza incluida.