Quels outils utilisent les forward-deployed engineers ? Un stack ouvert, ontologie d’abord
Ce qu’un forward-deployed engineer construit réellement sur un déploiement de 60–180 jours, les cinq douleurs qui définissent le métier, et pourquoi la vague d’imitateurs de 2026 a copié le rôle mais pas le substrat.
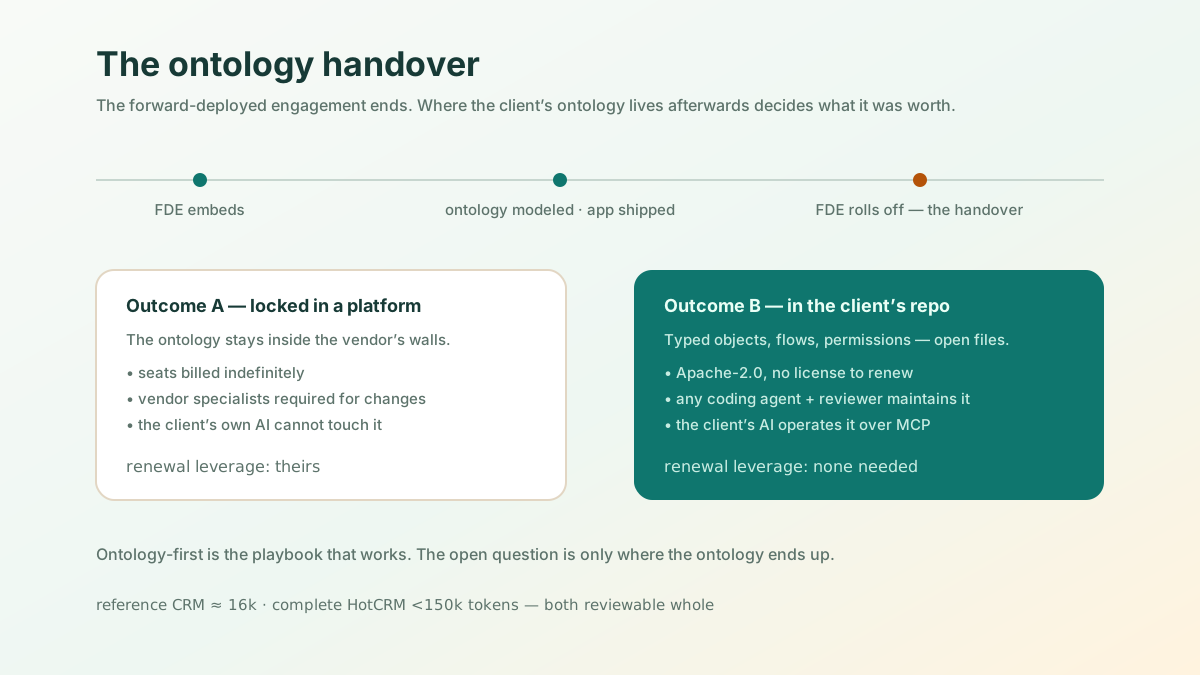
La version courte : l’ingénierie forward-deployed est le rôle qui croît le plus vite dans l’AI d’entreprise — offres d’emploi en hausse de 1 165 % sur un an selon le décompte de Live Data Technologies, relayé par la marketplace de recrutement Paraform — et en 2026, OpenAI, Anthropic, AWS et Microsoft ont chacun monté leur propre organisation forward-deployed. Le playbook qu’ils copient tous est la méthode ontologie d’abord de Palantir. Cet article traite les deux choses que les contenus de recrutement ne couvrent jamais : ce qu’un FDE construit réellement sur un déploiement de 60 à 180 jours, et pourquoi la vague d’imitateurs a copié le rôle mais pas le substrat en dessous. Entre les deux, les cinq douleurs récurrentes de ce métier sur un stack artisanal — la plomberie dévore l’engagement, les démos meurent en revue de sécurité, les besoins changent plus vite que le code, les patterns ne capitalisent jamais d’un client à l’autre, la passation empoisonne la relation — et comment un stack ouvert, ontologie d’abord, élimine chacune. Il finit sur la question qui, selon nous, définira la prochaine vague du rôle : la passation d’ontologie. L’ontologie du client sort-elle de l’engagement en fichiers ouverts et typés dans son dépôt — ou comme levier de renouvellement dans la plateforme d’un autre ?
Le métier que personne ne décrit honnêtement
Les offres d’emploi parlent d’« ambiguïté 0→1 » et de bandes de 300–550K $ (Perspective AI, TechTarget). Le vrai métier consiste à faire fonctionner l’AI à l’intérieur des murs de quelqu’un d’autre : ses données, ses permissions, son service conformité, sa définition du « suffisant ». Palantir a codifié la méthode il y a des années : ses AI FDE construisent d’abord une ontologie propre au client avant de livrer toute application LLM et consacrent 30 à 40 % de la semaine à la découverte (guide AI FDE de Palantir). La méthode est bonne. C’est l’outillage en dessous qui décide où part vraiment la semaine.
Ce qu’un forward deployed engineer construit réellement
Un déploiement dure environ 60 à 180 jours et produit quatre artefacts avant la passation, dans un ordre fixe, car chacun est l’entrée du suivant. C’est précisément la partie qu’aucune offre d’emploi ne décrit :
| Jour du déploiement | Ce qui s’écrit réellement | Terminé quand |
|---|---|---|
| 0–15 · Adaptateurs d’ingestion | Un adaptateur par système source — leur ERP, leur outil de ticketing, le tableur qui est secrètement la source de vérité. Les chemins de lecture d’abord : connecter, pas migrer. | Un objet métier à l’écran affiche une vraie ligne sortie de leur système ce matin. |
| 15–45 · Résolution d’entités | La moitié ingrate que personne ne montre en démo. « Client », ce sont quatre clés différentes dans quatre systèmes : vous écrivez les règles de rapprochement, les règles de survivance, et l’identifiant que l’ontologie considère comme canonique. | Deux enregistrements de la même société fusionnent — et le responsable des opérations du client est d’accord pour dire qu’ils le devaient. |
| 30–60 · Cartographie des permissions | Leur organigramme traduit en rôles, ensembles de permissions, partage au niveau ligne et règles de champ, y compris les champs que trois personnes seulement peuvent voir. | La revue de sécurité devient une lecture de fichier au lieu d’une réunion : un relecteur peut désigner qui voit quoi. |
| 45–90 · Les premiers flux | Deux ou trois processus de bout en bout — une chaîne d’approbation, une file de triage, un renouvellement — avec les actions, les vues et les notifications autour. | Quelqu’un qui ne travaille pas pour vous accomplit une vraie journée de travail dans l’app. |
| 90–180 · Passation | Données d’amorçage, fixtures de recette, libellés traduits, l’app packagée et une checklist de revue que leur équipe peut réellement dérouler. | Leurs propres ingénieurs livrent un changement sans vous appeler. |
Notez ce que les quatre premières lignes ont en commun : aucune n’est du code applicatif au sens habituel. Ce sont des définitions — ce qui existe, ce qui compte comme la même chose, qui a le droit de faire quoi, comment le travail circule. Sur un stack artisanal, chacune s’exprime pourtant en code, et c’est exactement pour cela que les douleurs ci-dessous mordent.
Le déploiement numéro deux est l’endroit où le modèle paie ou échoue. Rien dans ce tableau n’est aussi spécifique au client qu’on le ressent sur le moment. La résolution d’entités pour « client » est structurellement le même problème chez le client suivant avec d’autres clés ; une chaîne d’approbation a la même forme avec d’autres seuils et un autre rôle approbateur. Le deuxième engagement n’a donc qu’un seul chiffre à mesurer — appelons-le le taux de renommage : la part du déploiement deux qui est un renommage de définitions typées que vous possédez déjà, plutôt qu’une réécriture. Dans une base de code artisanale, ce taux est proche de zéro et personne ne le remarque, car le déploiement deux est livré quand même ; il coûte simplement ce qu’a coûté le premier. En métadonnées typées, il est dénombrable, parce que la surface est finie : un engagement de la taille de HotCRM, ce sont 15 objets, 17 flux, 10 actions, 6 profils de permissions et 5 règles de partage. Vous pouvez littéralement lister ce dont hérite le client suivant.
Voilà le métier. Le reste de cet article, ce sont les cinq douleurs récurrentes qui rendent chaque ligne de ce tableau plus difficile qu’elle ne devrait l’être — et ce qui les élimine.
Douleur 1 — La semaine une, c’est toujours la plomberie
Chaque engagement commence pareil : avant d’afficher un seul objet métier à l’écran, il faut l’auth, le SSO, les rôles, les API CRUD, une UI d’admin, du stockage de fichiers et une table d’audit. Rien de tout cela n’est la raison pour laquelle le client vous a engagé. Votre différenciateur — les 30–40 % du temps passés à comprendre son métier — se fait écraser par les 60 % passés à reconstruire le même socle indifférencié que vous aviez déjà construit chez le client précédent.
Ce que le stack change : le socle est déjà là. Une commande, et avant le déjeuner tournent la Console, la connexion avec SSO, les permissions rôle/ligne/champ, le journal d’audit, les API REST et un serveur MCP :
npm create objectstack@latest client-app && cd client-app
npx os dev --ui   # Console sur :3000 — auth, RBAC, audit déjà appliqués
Tout ce qui est dérivable est dérivé par le runtime. Il ne reste à écrire que ce que vous seul pouvez écrire : les objets, flux et règles de permissions du client. La semaine une devient découverte et modélisation — le travail sur lequel vous êtes réellement différencié.
Douleur 2 — La démo qui meurt en revue de sécurité
Vous connaissez la courbe. Vendredi de la semaine une : une démo bricolée — une UI improvisée sur un CSV copié — et la salle applaudit. Mois deux : l’infosec arrive avec trois questions. Que peut voir exactement l’AI ? Avec les permissions de qui agit-elle ? Où est la trace d’audit ? Pour un stack de démo, la réponse honnête est une reconstruction, et la reconstruction est l’endroit où meurent les engagements.
Ce que le stack change : la gouvernance est le socle, pas une rustine. La porte de validation n’accepte même pas un objet sans modèle de partage déclaré :
export const Ticket = ObjectSchema.create({
  name: 'support_ticket',
  label: 'Ticket',
  sharingModel: 'private',        // obligatoire — sans lui, la porte refuse
  fields: {
    subject:  Field.text({ label: 'Subject', required: true }),
    status:   Field.select({ label: 'Status', options: [/* les états réels du client */] }),
    approver: Field.lookup('sys_user'),
  },
});
À l’exécution, chaque appel — UI humaine, REST ou agent AI via MCP — passe par le même RBAC, la même sécurité de ligne et de champ, et atterrit dans le même journal d’audit. Quand l’infosec demande « que peut voir l’AI ? », la réponse est un fichier qu’elle peut lire : des métadonnées de permissions appliquées par le runtime, pas une promesse sur une diapositive. Votre démo du vendredi et votre déploiement de production sont le même artefact. Il n’y a pas de reconstruction, parce qu’il n’a jamais existé de version sans gouvernance.
Douleur 3 — Les besoins changent plus vite que le code
En pleine réunion, le responsable des opérations lâche : « au fait, les remises au-dessus de 20 % passent d’abord par les managers régionaux ». Dans une base de code artisanale, c’est une migration de schéma, trois changements d’API, un changement d’UI et une semaine — et aux yeux du client, vous êtes devenu lent au moment précis où il est devenu précis. Le travail forward-deployed vit ou meurt de la vitesse d’itération dans la salle.
Ce que le stack change : toute l’application est une métadonnée typée et compacte. La référence CRM fournie fait 1 792 lignes, environ 16k tokens (comptez : find examples/app-crm/src -name '*.ts' | xargs cat | wc -l) ; le HotCRM complet reste sous 150k tokens au total — logique métier sous 100k, plus environ 50k pour l’UI. À ces deux échelles, votre agent de code tient le système entier en contexte : le changement de chaîne de validation est un seul diff cohérent à travers flux, permissions et UI, écrit avant la fin de la réunion, validé par os validate, prévisualisé en direct dans la Console. « Qu’est-ce qui casse si on change ça ? » est une question à laquelle l’agent peut vraiment répondre, parce qu’il voit tout. Les changements de besoins cessent de menacer le planning — ils deviennent la démo.
Douleur 4 — Vos patterns ne capitalisent jamais
Le code de chaîne de validation du client A ne se transporte pas dans la base de code du client B — versions de framework différentes, auth différente, tout différent. Chaque engagement repart donc de zéro, et une boutique de trois personnes ne peut jamais construire le levier qui fait tenir l’économie du modèle Palantir. C’est la raison silencieuse pour laquelle les cabinets forward-deployed restent petits.
Ce que le stack change : les patterns sont des métadonnées typées, et les métadonnées typées sont portables. La chaîne de validation modélisée pour le client A est une définition de flux que vous déposez dans le dépôt du client B et renommez. Au fil des engagements, vous accumulez une bibliothèque maison — objets, flux, jeux de permissions, données d’amorçage — que votre agent applique au client suivant en quelques minutes. Et vous ne partez pas de zéro : HotCRM est une référence complète et forkable — 15 objets, 17 flux, 4 tableaux de bord, 2 copilotes AI, 4 langues — construite comme exemple canonique des conventions. Forkez, renommez le namespace, et votre engagement démarre d’un système qui tourne plutôt que d’un dépôt vide.
Douleur 5 — La passation empoisonne la relation
Tout engagement se termine, et aujourd’hui il se termine mal, d’une de deux façons. Livrez une plateforme, et le client loue sa propre ontologie pour toujours — vous êtes devenu le canal de vente d’un autre, et il a appris à craindre les pilotes réussis : meilleure est l’ontologie, plus profond est le verrouillage. Livrez une base de code sur mesure, et son équipe ne peut pas la maintenir ; elle pourrit, et dix-huit mois plus tard cette pourriture porte votre nom.
Ce que le stack change : c’est la passation d’ontologie — la fin que le playbook FDE n’a jamais résolue. Ce que vous transmettez, c’est le dépôt du client : objets, flux et permissions typés sous Apache-2.0, plus l’artefact compilé et une checklist de revue. Son équipe sécurité peut inspecter la définition entière — la référence fournie fait 16k tokens et même le HotCRM complet reste sous 150k, pas 300 000 lignes de code. Ses propres agents de code entretiennent le système avec la même boucle que vous, parce que le format est né pour être écrit par des agents. S’il veut la plateforme opérée — AI Builder dans le navigateur, cloud ou self-managed — il y a ObjectOS, sur la même définition ouverte ; il peut partir sans perdre l’ontologie. Votre prochain contrat se gagne par du travail nouveau, il ne s’extrait pas par le verrouillage. Cette différence, c’est votre réputation qui capitalise.
La boîte à outils métadonnées complète du FDE
L’ontologie n’est pas que le modèle de données. Un engagement forward-deployed utilise un type de métadonnée à chaque phase, de la découverte à la passation — et toutes relèvent de la même définition typée, validable et portable :
| Phase | La question du client à laquelle vous répondez | Types de métadonnées utilisés |
|---|---|---|
| 1 · Modéliser les noms | « Qu’existe-t-il dans notre métier ? » | Objets et champs (relations, règles de validation, formules) · datasources (connexion aux bases existantes, sans migration) · données d’amorçage (démos et recette) |
| 2 · Modéliser les verbes | « Comment le travail circule-t-il vraiment ? » | Flux (chaînes de validation, machines à états, déclencheurs, planifications) · validations (multi-niveaux, files, verrouillage d’enregistrement) · actions (boutons et opérations serveur à permissions vérifiées) |
| 3 · Des écrans pour les gens | « Où travaillent nos équipes ? » | Apps et navigation · vues (liste/kanban/calendrier/gantt) · pages et formulaires · tableaux de bord et rapports (les KPI que demande la direction) |
| 4 · Passer la revue de sécurité | « Qui peut voir et faire quoi ? » | Jeux de permissions et rôles (RBAC) · sécurité de ligne et de champ · règles de partage · audit (intégré au runtime — déclaré, livré) |
| 5 · L’AI que le client veut vraiment | « Que peut faire l’AI pour nous ? » | Agents AI (copilotes ventes/support) · outils et skills AI · exposition MCP (ai: { exposed: true }) |
| 6 · Passation et capitalisation | « Que se passe-t-il après votre départ ? » | Traductions (libellés multilingues pour clients internationaux) · manifeste et packaging (compilation en un objectstack.json, installable dans tout environnement) |
L’essentiel : les six couches sont la même matière. Une chaîne de validation est une métadonnée typée exactement comme le modèle de données, et un agent AI aussi — la même porte de validation les contrôle, le même diff les relit, le même dépôt les transmet :
// The client's verbs: a discount approval — typed metadata, same as an object
export const DiscountApproval: Flow = {
  name: 'discount_approval',
  label: 'Discount Approval',
  type: 'record_change',
  status: 'active',
  nodes: [
    { id: 'start', type: 'start', label: 'Start',
      config: { objectName: 'crm_quote', triggerType: 'record-after-update',
                condition: 'record.discount > 0.20' } },
    { id: 'review', type: 'approval', label: 'Regional Manager Review',
      config: { approvers: [{ type: 'position', value: 'regional_manager' }], lockRecord: true } },
    { id: 'end', type: 'end', label: 'End' },
  ],
  edges: [/* start -> review -> end */],
};

// The AI the client actually wants: a service copilot — still metadata
export const ServiceCopilot = defineAgent({
  name: 'service_copilot',
  label: 'Service Copilot',
  instructions: 'Help support reps triage and resolve cases. Retrieve only within the user\'s permissions. Always cite case IDs.',
  skills: ['case_triage', 'customer_360'],
  knowledge: { topics: ['support_kb', 'sla_policies'] },
});
HotCRM est la démonstration complète de ce vocabulaire à l’œuvre : 15 objets, 17 flux, 10 actions, 4 tableaux de bord, 2 copilotes AI, 6 skills, 6 profils de permissions, 5 règles de partage et 4 langues — chaque couche présente, moins de 150k tokens au total : logique métier sous 100k, plus environ 50k pour l’UI. L’ensemble tient dans une seule fenêtre de contexte d’agent.
La vague d’imitateurs de 2026 a copié le rôle, pas le substrat
En une seule année, le secteur a décidé que c’est ainsi que l’AI d’entreprise se livre. Chacune de ces lignes est un engagement daté, pris par l’entreprise elle-même — c’est ce qui le rend citable :
| 2026 | L’engagement | Annoncé par |
|---|---|---|
| Mai | OpenAI lance une société de déploiement détenue majoritairement, avec plus de 4 Md$ engagés, en acquérant au passage le cabinet Tomoro et environ 150 forward-deployed engineers | OpenAI |
| 11 juin | Anthropic et DXC annoncent une alliance pluriannuelle pour former des dizaines de milliers d’ingénieurs forward-deployed certifiés Claude, au sein des systèmes que DXC exploite déjà pour des banques, des compagnies aériennes et des assureurs | Anthropic |
| 30 juin | AWS engage 1 Md$ dans une unité de forward-deployed engineering, avec des pods de cinq à six ingénieurs installés chez le client | CNBC |
| 2 juillet | Microsoft monte Frontier — 2,5 Md$ et 6 000 employés — pour le même travail | CNBC |
Deux autres chiffres circulent avec cette vague et méritent que leur provenance soit énoncée plutôt que répétée. Les +1 165 % d’offres FDE sur un an sont le décompte de Live Data Technologies, relayé par Paraform — une marketplace de recrutement dont le métier est le recrutement de FDE — et il compte des offres, pas des postes pourvus. L’« équipe de 1 000 FDE » de Salesforce vient du blog de Salesforce : une déclaration d’intention, pas un effectif publié. Les deux sont vrais dans la direction, aucun n’est audité.
Vient maintenant la partie qui compte pour le travail. Chaque engagement du tableau est libellé en ingénieurs et en dollars. Aucun n’est libellé dans ce qui décide si le déploiement deux coûte moins cher que le premier : ce dans quoi la production de l’ingénieur atterrit. La méthode de Palantir fonctionne parce que le FDE écrit dans une ontologie propre au client et que l’application en est dérivée — le substrat est le produit, et les ingénieurs sont la façon dont il atteint un client. Recrutez la même personne dans une organisation sans substrat : de l’extérieur, le travail restera identique pendant environ un an.
La question utile à poser à toute organisation forward-deployed — celle que vous rejoignez, celle chez qui vous achetez, ou celle que vous montez — n’est donc pas combien d’ingénieurs elle compte. Ce sont trois questions sur le substrat :
- Quand l’ingénieur s’en va, dans quel fichier le travail a-t-il atterri ? Un ticket, un notebook et un service sur mesure ne sont pas une réponse ; une définition typée dans le dépôt du client, si.
- Le client peut-il la lire sans vous ? Si la définition n’est lisible que dans la console d’un éditeur, le client loue sa propre ontologie — et meilleur est votre travail, plus c’est profond.
- Qu’est-ce que le déploiement deux a hérité du premier ? Demandez la liste. Si personne ne peut la produire, le taux de renommage est nul.
La réponse de cet article aux trois questions est la même, et c’est la raison du cadrage ontologie d’abord de tout ce qui précède : l’artefact est une ontologie métier ouverte — objets, flux et permissions typés dans le dépôt du client, sous Apache-2.0 — que le client peut lire, garder et confier à ses propres agents de code. Copier le rôle est un plan de recrutement et prend un trimestre. Copier le substrat suppose de le rendre assez ouvert pour qu’un client veuille le garder : une décision produit que presque personne, dans la vague de 2026, n’a prise.
Ce que ce stack ne règle pas
Rendons justice aux alternatives : la fédération de données et les pipelines analytiques à l’échelle Foundry restent le terrain de Palantir — si l’engagement consiste à fusionner des pétaoctets entre quarante systèmes legacy, c’est une autre classe d’outil. La conduite du changement ne se règle avec aucun stack. Et un client déjà standardisé sur une plateforme fermée peut rationnellement y rester. L’affirmation est plus étroite : pour la couche applicative du travail forward-deployed — modéliser un métier et livrer des apps gouvernées dessus — les cinq douleurs ci-dessus sont désormais éliminables, et l’ontologie peut être transmise au lieu d’être retenue en otage.
La checklist du FDE
- Modéliser les noms et les verbes du client en objets et en flux avant toute discussion d’UI.
- Garder la définition entière à taille de contexte pour que l’agent puisse la raisonner et la refactoriser d’un bloc.
- Permissions prudentes par défaut ; tout changement d’autorité explicite dans le diff.
- Transmettre le dépôt, l’artefact compilé et une checklist de revue — pas un login vers votre tenant.
- Laisser MCP activé pour que l’AI du client opère l’app dans le cadre de ses permissions.
- Au déploiement deux, compter le taux de renommage. Si rien n’a été repris, le problème est le substrat, pas l’engagement.
Essayez la boucle
Pointez votre agent de code vers le stack ouvert — le scaffold embarque AGENTS.md et le bundle de skills, l’agent démarre donc avec les règles du format déjà chargées :
npm create objectstack@latest client-app && cd client-app
npx os dev --ui   # l’app tourne — modélisez le premier objet avec votre agent
Pour les clients qui veulent la plateforme opérée, ObjectOS est la plateforme commerciale de production et d’exploitation sur ObjectStack — construire et interroger en ligne, avec déploiement géré ou privé et gouvernance incluse.