Welche Tools nutzen Forward-Deployed Engineers? Ein Ontologie-first Open Stack
Was Forward-Deployed Engineers in einem 60–180-Tage-Deployment tatsächlich bauen, die fünf Schmerzen, die diese Arbeit definieren, und warum die Copycat-Welle 2026 die Rolle kopiert hat — nicht das Substrat darunter.
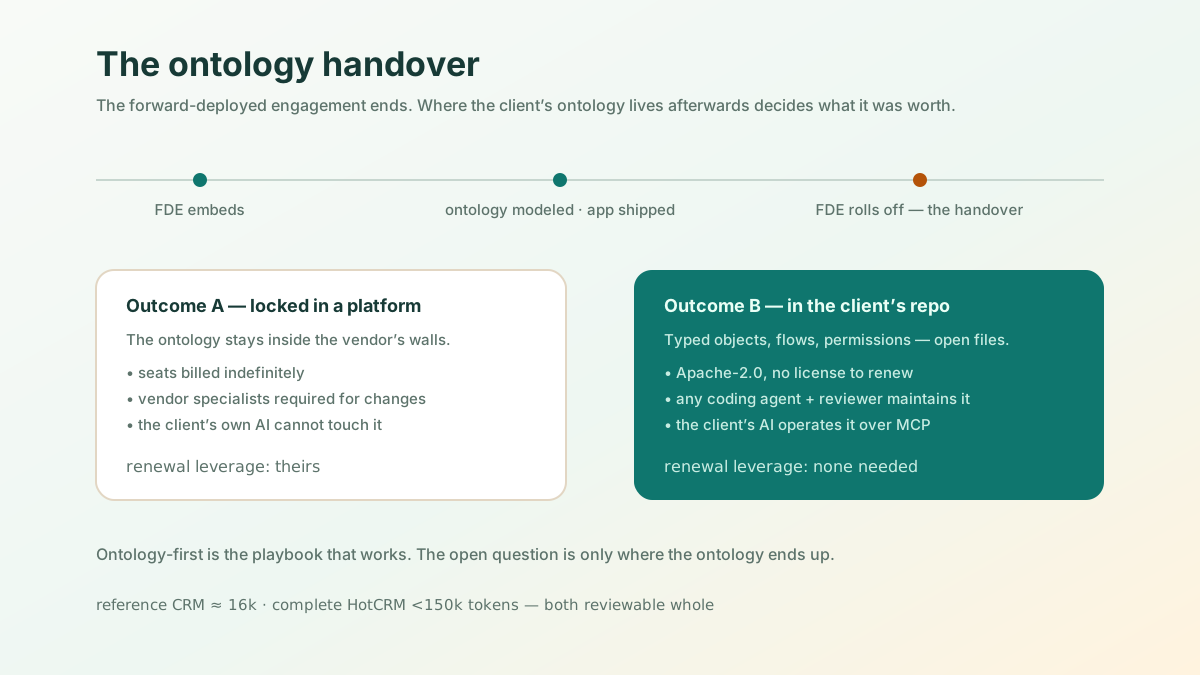
Kurzfassung: Forward-Deployed Engineering ist die am schnellsten wachsende Rolle in Enterprise AI — Stellenanzeigen plus 1.165 % im Jahresvergleich nach der Zählung von Live Data Technologies, weitergegeben vom Recruiting-Marktplatz Paraform — und 2026 haben OpenAI, Anthropic, AWS und Microsoft jeweils eine eigene Forward-Deployed-Organisation aufgebaut. Das Playbook, das sie alle kopieren, ist Palantirs Ontologie-first-Methode. Dieser Artikel behandelt die zwei Dinge, die in Recruiting-Texten nie vorkommen: was ein FDE tatsächlich baut, über ein Deployment von 60–180 Tagen hinweg, und warum die Copycat-Welle die Rolle kopiert hat, nicht das Substrat darunter. Dazwischen liegen die fünf wiederkehrenden Schmerzen dieser Arbeit auf einem handgebauten Stack — Klempnerei frisst das Engagement, Demos sterben im Security-Review, Anforderungen ändern sich schneller als Code, Muster verzinsen sich nie über Kunden hinweg, die Übergabe vergiftet die Beziehung — und wie ein offener, Ontologie-first Stack jeden einzelnen beseitigt. Am Ende steht die Frage, die aus unserer Sicht die nächste Welle dieser Rolle definiert: die Ontologie-Übergabe. Verlässt die Ontologie des Kunden das Engagement als typisierte, offene Dateien in seinem Repo — oder als Verlängerungshebel in der Plattform eines anderen?
Der Job, den niemand ehrlich beschreibt
Die Stellenanzeigen sprechen von „0→1-Ambiguität” und Gehaltsbändern von 300–550K $ (Perspective AI, TechTarget). Der tatsächliche Job: AI innerhalb fremder Mauern zum Laufen bringen — deren Daten, deren Berechtigungen, deren Compliance-Abteilung, deren Definition von „gut genug”. Palantir hat die Methode vor Jahren kodifiziert: AI FDEs bauen zuerst eine kundenspezifische Ontologie, bevor irgendeine LLM-Anwendung ausgeliefert wird, und verbringen 30–40 % der Woche mit Discovery (Palantirs AI-FDE-Leitfaden). Die Methode stimmt. Wohin die Woche wirklich geht, entscheidet das Werkzeug darunter.
Was ein Forward Deployed Engineer tatsächlich baut
Ein Deployment läuft rund 60–180 Tage und produziert vor der Übergabe vier Artefakte, in fester Reihenfolge — denn jedes ist der Input für das nächste. Genau dieser Teil steht in keiner Stellenanzeige:
| Deployment-Tag | Was tatsächlich geschrieben wird | Fertig, wenn |
|---|---|---|
| 0–15 · Ingestion-Adapter | Ein Adapter pro Quellsystem — deren ERP, deren Ticketing-Tool, die Tabelle, die heimlich die Source of Truth ist. Lesepfade zuerst: anbinden, nicht migrieren. | Ein Geschäftsobjekt auf dem Bildschirm zeigt eine echte Zeile, die heute Morgen aus deren System kam. |
| 15–45 · Entity Resolution | Die unglamouröse Hälfte, die niemand demonstriert. „Kunde” sind vier verschiedene Schlüssel in vier Systemen: Sie schreiben die Match-Regeln, die Survivorship-Regeln und den Identifier, den die Ontologie als kanonisch behandelt. | Zwei Datensätze derselben Firma verschmelzen — und der Ops-Lead des Kunden findet, dass sie das sollten. |
| 30–60 · Permission-Mapping | Das Organigramm übersetzt in Rollen, Permission Sets, zeilenbasiertes Sharing und Feldregeln — inklusive der Felder, die nur drei Personen je sehen dürfen. | Der Security-Review ist ein Dateilesen statt eines Meetings: Ein Prüfer kann zeigen, wer was sehen darf. |
| 45–90 · Die ersten Workflows | Zwei oder drei Prozesse Ende zu Ende — eine Freigabekette, eine Triage-Queue, eine Verlängerung — mit den Actions, Views und Benachrichtigungen drumherum. | Jemand, der nicht für Sie arbeitet, erledigt einen echten Arbeitstag in der App. |
| 90–180 · Übergabe | Seed-Daten, Abnahme-Fixtures, übersetzte Labels, die paketierte App und eine Review-Checkliste, die deren Team wirklich durchlaufen kann. | Deren eigene Engineers liefern eine Änderung aus, ohne Sie anzurufen. |
Beachten Sie, was die ersten vier Zeilen gemeinsam haben: Keine davon ist Anwendungscode im üblichen Sinn. Es sind Definitionen — was existiert, was als dasselbe Ding zählt, wer was darf, wie Arbeit fließt. Auf einem handgebauten Stack wird jede davon trotzdem als Code ausgedrückt, und genau deshalb beißen die Schmerzen unten.
Deployment Nummer zwei ist der Punkt, an dem sich das Modell auszahlt oder scheitert. Nichts in dieser Tabelle ist so kundenspezifisch, wie es sich währenddessen anfühlt. Entity Resolution für „Kunde” ist beim nächsten Kunden strukturell dasselbe Problem mit anderen Schlüsseln; eine Freigabekette hat dieselbe Form mit anderen Schwellenwerten und einer anderen Genehmigerrolle. Beim zweiten Engagement lohnt sich deshalb genau eine Kennzahl — nennen wir sie Rename-Ratio: der Anteil von Deployment zwei, der eine Umbenennung bereits vorhandener typisierter Definitionen ist, statt eine Neuschreibung. In einer handgebauten Codebasis liegt die Rename-Ratio nahe null, und niemand merkt es, weil Deployment zwei trotzdem ausliefert — es kostet nur so viel wie Deployment eins. In typisierten Metadaten ist sie zählbar, weil die Fläche endlich ist: Ein Engagement in HotCRM-Größe sind 15 Objekte, 17 Flows, 10 Actions, 6 Permission-Profile und 5 Sharing-Regeln. Sie können buchstäblich auflisten, was der nächste Kunde erbt.
Das ist der Job. Der Rest dieses Artikels sind die fünf wiederkehrenden Schmerzen, die jede Zeile dieser Tabelle schwerer machen, als sie sein müsste — und was sie beseitigt.
Schmerz 1 — Woche eins ist immer Klempnerei
Jedes Engagement beginnt gleich: Bevor auch nur ein Geschäftsobjekt auf einem Bildschirm erscheint, brauchen Sie Auth, SSO, Rollen, CRUD-APIs, eine Admin-UI, Dateispeicher und eine Audit-Tabelle. Nichts davon ist der Grund, warum der Kunde Sie engagiert hat. Ihr Differenzierungsmerkmal — die 30–40 % Zeit für das Verständnis seines Geschäfts — wird von den 60 % erdrückt, die in den Wiederaufbau desselben undifferenzierten Unterbaus fließen, den Sie beim letzten Kunden schon gebaut haben.
Was der Stack ändert: Der Unterbau ist schon da. Ein Befehl, und vor dem Mittagessen laufen Console, Sign-in und SSO, Rollen-/Zeilen-/Feld-Berechtigungen, Audit-Logging, REST-APIs und ein MCP-Server:
npm create objectstack@latest client-app && cd client-app
npx os dev --ui   # Console auf :3000 — Auth, RBAC, Audit bereits durchgesetzt
Alles Ableitbare leitet die Runtime ab. Zu schreiben bleibt nur, was nur Sie schreiben können: die Objekte, Flows und Berechtigungsregeln des Kunden. Woche eins wird zu Discovery und Modellierung — der Arbeit, in der Sie tatsächlich differenziert sind.
Schmerz 2 — Die Demo, die im Security-Review stirbt
Sie kennen den Bogen. Freitag der ersten Woche: eine zusammengeklebte Demo — eine schnell gebaute UI über einer kopierten CSV — und der Raum applaudiert. Monat zwei: Infosec kommt mit drei Fragen. Was genau kann die AI sehen? Wessen Berechtigungen gelten, wenn sie handelt? Wo ist der Audit-Eintrag? Für einen Demo-Stack lautet die ehrliche Antwort: Neubau. Und der Neubau ist der Ort, an dem Engagements sterben.
Was der Stack ändert: Governance ist der Unterbau, kein Nachrüstsatz. Das Validierungsgate akzeptiert nicht einmal ein Objekt ohne deklariertes Sharing-Modell:
export const Ticket = ObjectSchema.create({
  name: 'support_ticket',
  label: 'Ticket',
  sharingModel: 'private',        // Pflicht — ohne lehnt das Gate ab
  fields: {
    subject:  Field.text({ label: 'Subject', required: true }),
    status:   Field.select({ label: 'Status', options: [/* die echten Zustände des Kunden */] }),
    approver: Field.lookup('sys_user'),
  },
});
Zur Laufzeit durchläuft jeder Aufruf — menschliche UI, REST oder ein AI Agent über MCP — dieselbe RBAC-, Zeilen- und Feldsicherheit und landet im selben Audit-Log. Fragt Infosec „was kann die AI sehen?”, ist die Antwort eine Datei, die sie lesen können: Berechtigungs-Metadaten, von der Runtime durchgesetzt, nicht auf einer Folie versprochen. Ihre Freitags-Demo und Ihr Produktions-Deployment sind dasselbe Artefakt. Es gibt keinen Neubau, weil es nie eine governance-freie Version gab.
Schmerz 3 — Anforderungen ändern sich schneller als Code
Mitten im Meeting sagt der Ops-Lead: „Ach ja — Rabatte über 20 % gehen zuerst über die Regionalleiter.” In einer handgebauten Codebasis ist das eine Schema-Migration, drei API-Änderungen, eine UI-Änderung und eine Woche — und in den Augen des Kunden wurden Sie in dem Moment langsam, in dem er konkret wurde. Forward-Deployed-Arbeit lebt und stirbt mit der Iterationsgeschwindigkeit im Raum.
Was der Stack ändert: Die gesamte Anwendung ist kompakte typisierte Metadaten. Das mitgelieferte CRM-Referenzbeispiel umfasst 1.792 Zeilen, rund 16k Tokens (zählen Sie selbst: find examples/app-crm/src -name '*.ts' | xargs cat | wc -l); das vollständige HotCRM bleibt insgesamt unter 150k Tokens — Geschäftslogik unter 100k, dazu rund 50k für die UI. Auf beiden Größenstufen hält Ihr Coding-Agent das gesamte System im Kontext: Die Änderung an der Freigabekette ist ein kohärenter Diff über Flow, Berechtigungen und UI — geschrieben, während das Meeting noch läuft, von os validate geprüft, live in der Console voranschaubar. „Was geht kaputt, wenn wir das ändern?” ist eine Frage, die der Agent wirklich beantworten kann, weil er alles sieht. Anforderungsänderungen bedrohen den Zeitplan nicht mehr — sie werden zur Demo.
Schmerz 4 — Ihre Muster verzinsen sich nie
Der Freigabeketten-Code von Kunde A lässt sich nicht in die Codebasis von Kunde B heben — andere Framework-Versionen, andere Auth, alles anders. Also beginnt jedes Engagement bei null, und eine Drei-Personen-Boutique kann nie den Hebel aufbauen, der Palantirs Modellökonomie trägt. Das ist der stille Grund, warum Forward-Deployed-Beratungen klein bleiben.
Was der Stack ändert: Muster sind typisierte Metadaten, und typisierte Metadaten sind portabel. Die für Kunde A modellierte Freigabekette ist eine Flow-Definition, die Sie in das Repo von Kunde B legen und umbenennen. Über Engagements hinweg akkumulieren Sie eine Hausbibliothek — Objekte, Flows, Berechtigungssets, Seed-Daten — die Ihr Agent in Minuten auf den nächsten Kunden anwendet. Und Sie starten die Bibliothek nicht bei null: HotCRM ist eine vollständige, forkbare Referenz — 15 Objekte, 17 Flows, 4 Dashboards, 2 AI-Copiloten, 4 Sprachen — gebaut als kanonisches Beispiel der Konventionen. Forken, Namespace umbenennen, und Ihr Engagement beginnt mit einem laufenden System statt einem leeren Repo.
Schmerz 5 — Die Übergabe vergiftet die Beziehung
Jedes Engagement endet, und heute endet es schlecht — auf eine von zwei Arten. Übergeben Sie eine Plattform, mietet der Kunde seine eigene Ontologie für immer zurück — Sie sind zum Vertriebskanal geworden, und der Kunde hat gelernt, erfolgreiche Piloten zu fürchten: je besser die Ontologie, desto tiefer der Lock-in. Übergeben Sie eine Spezial-Codebasis, kann sein Team sie nicht warten; sie verrottet, und achtzehn Monate später trägt die Fäulnis Ihren Namen.
Was der Stack ändert: Das ist die Ontologie-Übergabe — das Ende, das das FDE-Playbook nie gelöst hat. Was Sie übergeben, ist das Repo des Kunden: typisierte Objekte, Flows und Berechtigungen unter Apache-2.0, dazu das kompilierte Artefakt und eine Review-Checkliste. Sein Security-Team kann die gesamte Definition prüfen — das mitgelieferte Referenzbeispiel hat 16k Tokens, selbst das vollständige HotCRM weniger als 150k, nicht 300.000 Codezeilen. Seine eigenen Coding-Agents warten das System mit derselben Schleife, die Sie benutzt haben, denn das Format wurde agentenschreibbar gebaut. Will der Kunde die Plattform betrieben haben — Browser-AI-Builder, Cloud oder Self-Managed — gibt es ObjectOS, auf derselben offenen Definition; er kann gehen, ohne die Ontologie zu verlieren. Ihren nächsten Vertrag verdienen Sie mit neuer Arbeit, nicht mit Lock-in. Dieser Unterschied ist Ihre Reputation — mit Zinseszins.
Das komplette Metadaten-Toolkit des FDE
Die Ontologie ist nicht nur das Datenmodell. Ein Forward-Deployed-Engagement nutzt für jede Phase — von Discovery bis Übergabe — einen Metadatentyp, und alle sind dieselbe Art typisierter, validierbarer, portabler Definition:
| Phase | Die Kundenfrage, die Sie beantworten | Genutzte Metadatentypen |
|---|---|---|
| 1 · Substantive modellieren | „Was existiert in unserem Geschäft?” | Objekte & Felder (Beziehungen, Validierungsregeln, Formeln) · Datenquellen (bestehende Datenbanken anbinden, keine Migration) · Seed-Daten (für Demos und Abnahme) |
| 2 · Verben modellieren | „Wie fließt die Arbeit wirklich?” | Flows (Freigabeketten, Zustandsmaschinen, Record-Trigger, Zeitpläne) · Freigaben (mehrstufig, Queues, Record-Locking) · Aktionen (rechtegeprüfte Buttons und Serveroperationen) |
| 3 · Oberflächen für Menschen | „Wo arbeiten unsere Leute?” | Apps & Navigation · Views (Liste/Kanban/Kalender/Gantt) · Seiten & Formulare · Dashboards & Berichte (die KPIs, nach denen das Management fragt) |
| 4 · Security-Review bestehen | „Wer darf was sehen und tun?” | Berechtigungssets & Rollen (RBAC) · Zeilen- und Feldsicherheit · Sharing-Regeln · Audit (in der Runtime eingebaut — deklariert, geliefert) |
| 5 · Die AI, die der Kunde wirklich will | „Was kann AI für uns tun?” | AI Agents (Sales-/Service-Copiloten) · AI-Tools & Skills · MCP-Exposition (ai: { exposed: true }) |
| 6 · Übergabe & Zinseszins | „Was passiert, wenn Sie gehen?” | Übersetzungen (mehrsprachige Labels für globale Kunden) · App-Manifest & Packaging (kompiliert zu einer objectstack.json, installierbar in jede Umgebung) |
Der Punkt: Alle sechs Schichten sind derselbe Stoff. Eine Freigabekette ist typisierte Metadaten genau wie das Datenmodell — und ein AI Agent auch. Dasselbe Validierungsgate prüft sie, derselbe Diff reviewt sie, dasselbe Repo übergibt sie:
// The client's verbs: a discount approval — typed metadata, same as an object
export const DiscountApproval: Flow = {
  name: 'discount_approval',
  label: 'Discount Approval',
  type: 'record_change',
  status: 'active',
  nodes: [
    { id: 'start', type: 'start', label: 'Start',
      config: { objectName: 'crm_quote', triggerType: 'record-after-update',
                condition: 'record.discount > 0.20' } },
    { id: 'review', type: 'approval', label: 'Regional Manager Review',
      config: { approvers: [{ type: 'position', value: 'regional_manager' }], lockRecord: true } },
    { id: 'end', type: 'end', label: 'End' },
  ],
  edges: [/* start -> review -> end */],
};

// The AI the client actually wants: a service copilot — still metadata
export const ServiceCopilot = defineAgent({
  name: 'service_copilot',
  label: 'Service Copilot',
  instructions: 'Help support reps triage and resolve cases. Retrieve only within the user\'s permissions. Always cite case IDs.',
  skills: ['case_triage', 'customer_360'],
  knowledge: { topics: ['support_kb', 'sla_policies'] },
});
HotCRM ist die vollständige Demonstration dieses Vokabulars: 15 Objekte, 17 Flows, 10 Aktionen, 4 Dashboards, 2 AI-Copiloten, 6 Skills, 6 Berechtigungsprofile, 5 Sharing-Regeln und 4 Sprachen — jede Schicht vorhanden, insgesamt unter 150k Tokens: Geschäftslogik unter 100k, dazu rund 50k für die UI. Das Ganze passt in ein einziges Agent-Kontextfenster.
Die Copycat-Welle 2026 kopierte die Rolle, nicht das Substrat
Innerhalb eines Jahres hat die Branche entschieden, dass Enterprise AI so ausgeliefert wird. Jede dieser Zeilen ist eine datierte Zusage des Unternehmens, das sie gemacht hat — und nur deshalb überhaupt zitierfähig:
| 2026 | Die Zusage | Angekündigt von |
|---|---|---|
| Mai | OpenAI gründet eine mehrheitlich eigene Deployment-Gesellschaft mit über 4 Mrd. $ und übernimmt dabei die Beratung Tomoro samt rund 150 Forward-Deployed Engineers | OpenAI |
| 11. Juni | Anthropic und DXC kündigen eine mehrjährige Allianz an: Zehntausende Claude-zertifizierte Forward-Deployed Engineers, ausgebildet für die Systeme, die DXC bereits für Banken, Airlines und Versicherer betreibt | Anthropic |
| 30. Juni | AWS steckt 1 Mrd. $ in eine Forward-Deployed-Engineering-Einheit und setzt Pods von fünf bis sechs Engineers direkt beim Kunden ein | CNBC |
| 2. Juli | Microsoft startet Frontier — 2,5 Mrd. $ und 6.000 Beschäftigte — für dieselbe Arbeit | CNBC |
Zwei weitere Zahlen kursieren mit dieser Welle und verdienen eine Herkunftsangabe statt einer Wiederholung. Das Plus von 1.165 % bei FDE-Stellenanzeigen im Jahresvergleich ist die Zählung von Live Data Technologies, weitergegeben von Paraform — einem Recruiting-Marktplatz, dessen Geschäft FDE-Hiring ist — und sie zählt Anzeigen, keine besetzten Stellen. Salesforces „Team aus 1.000 FDEs” stammt aus Salesforces eigenem Blog: eine Absichtserklärung, keine offengelegte Kopfzahl. Beide sind der Richtung nach real, und keine ist geprüft.
Jetzt der Teil, der für die Arbeit zählt. Jede Zusage in der Tabelle ist in Engineers und Dollar denominiert. Keine einzige ist in dem denominiert, was darüber entscheidet, ob Deployment zwei weniger kostet als Deployment eins: worin der Output des Engineers landet. Palantirs Methode funktioniert, weil der FDE in eine kundenspezifische Ontologie schreibt und die Anwendung daraus abgeleitet wird — das Substrat ist das Produkt, und die Engineers sind der Weg, auf dem es den Kunden erreicht. Stellen Sie dieselbe Person in einer Organisation ohne Substrat ein, und die Arbeit sieht von außen etwa ein Jahr lang identisch aus.
Die nützliche Frage an jede Forward-Deployed-Organisation — die, in die Sie eintreten, bei der Sie kaufen oder die Sie aufbauen — ist deshalb nicht, wie viele Engineers sie hat. Es sind drei Fragen zum Substrat:
- Wenn der Engineer abzieht, in welcher Datei ist die Arbeit gelandet? Ein Ticket, ein Notebook und ein maßgeschneiderter Service sind keine Antwort; eine typisierte Definition im Repository des Kunden schon.
- Kann der Kunde sie ohne Sie lesen? Ist die Definition nur in einer Anbieterkonsole lesbar, mietet der Kunde seine eigene Ontologie zurück — und je besser Ihre Arbeit, desto tiefer.
- Was hat Deployment zwei von Deployment eins geerbt? Verlangen Sie die Liste. Kann sie niemand vorlegen, ist die Rename-Ratio null.
Die Antwort dieses Artikels ist auf alle drei dieselbe, und sie ist der Grund für den Ontologie-first-Rahmen weiter oben: Das Artefakt ist eine offene Geschäftsontologie — typisierte Objekte, Flows und Berechtigungen im eigenen Repository des Kunden unter Apache-2.0 —, die der Kunde lesen, behalten und seinen eigenen Coding-Agenten übergeben kann. Die Rolle zu kopieren ist ein Einstellungsplan und dauert ein Quartal. Das Substrat zu kopieren heißt, es offen genug zu machen, dass ein Kunde es behalten würde — und das ist eine Produktentscheidung, die in der Welle von 2026 fast niemand getroffen hat.
Was dieser Stack nicht behebt
Die Gegenseite fair behandelt: Datenföderation und Analytics-Pipelines im Foundry-Maßstab sind Palantirs Heimspiel — geht es darum, Petabytes über vierzig Legacy-Systeme zu fusionieren, ist das eine andere Werkzeugklasse. Change Management behebt kein Stack. Und ein Kunde, der bereits vollständig auf eine geschlossene Plattform standardisiert ist, bleibt womöglich rational dort. Die Behauptung ist enger: Für die Anwendungsschicht der Forward-Deployed-Arbeit — ein Geschäft modellieren und darauf kontrollierte Apps ausliefern — sind die fünf Schmerzen oben jetzt beseitigbar, und die Ontologie kann übergeben statt als Geisel gehalten werden.
Die FDE-Checkliste
- Die Substantive und Verben des Kunden als Objekte und Flows modellieren, vor jedem UI-Gespräch.
- Die gesamte Definition kontextgroß halten, damit der Agent sie als Ganzes durchdenken und refaktorieren kann.
- Berechtigungen per Default konservativ; jede Autoritätsänderung explizit im Diff.
- Übergeben werden Repo, kompiliertes Artefakt und Review-Checkliste — kein Login in Ihren Tenant.
- MCP aktiviert lassen, damit die eigene AI des Kunden die App innerhalb seiner Berechtigungen bedient.
- Bei Deployment zwei die Rename-Ratio zählen. Wenn nichts übertragen wurde, liegt das Problem am Substrat, nicht am Engagement.
Die Schleife ausprobieren
Richten Sie Ihren Coding-Agent auf den offenen Stack — das Scaffold bringt AGENTS.md und das Skills-Bundle mit, der Agent startet also mit geladenen Formatregeln:
npm create objectstack@latest client-app && cd client-app
npx os dev --ui   # die App läuft — modellieren Sie das erste Objekt mit Ihrem Agent
Für Kunden, die die Plattform betrieben haben wollen, ist ObjectOS die kommerzielle Produktions- und Betriebsplattform auf ObjectStack — online bauen & fragen, mit verwaltetem oder privatem Deployment und integrierter Governance.