給現有系統加 AI:連線資料庫,而不是先遷移
在自管部署的 ObjectOS(企業版)裡,把已經執行的資料庫接入(預設只讀),讓 agent 把關鍵資料表建模為物件,再在你的權限邊界內疊加 AI 能力;原系統繼續執行,AI 走受控物件層。
先給結論:讓現有系統支援 AI,不必先遷移或重建——把 ObjectOS 連到你正在跑的資料庫,讓 agent 在你的權限之下讀懂真實資料、疊加 AI,優先連線,而不是先重建。
大多數“給你的業務加上 AI”的說辭,都悄悄假設了一次重建:把資料搬到新平臺、重新實現工作流、重新培訓團隊,然後祈禱遷移順利落地。而這正是沒人想做的部分。那套記錄系統 —— CRM、ERP、工單工具、自研的後辦公系統 —— 已經在運轉,資料也已經在那裡。
ObjectOS 採取相反的立場。你不遷移。你連線。
一句話
在自管部署的 ObjectOS(企業版,跑在你自己的基礎設施上、資料庫可達)裡,把 ObjectOS 指向你現有的資料庫——預設只讀——將你關心的資料表描述為物件,於是每一個 AI Agent、流程、API 和儀表盤都立刻在這些資料上工作 —— 自動路由到正確的系統,並受你的使用者已經擁有的同一套權限治理。
原有的應用不會改變。資料行不會移動。ObjectOS 成為你已執行系統之上那層原生支援 AI、感知權限的介面。
一個
假設你的銷售團隊跑在一個 40 張表的 Postgres CRM 上。客戶、聯絡人、商機、明細行、活動 —— 多年的真實資料,一個銷售每天都在用的生產應用。管理層想要兩件事:讓大家用自然語言向資料提問(“哪些企業級商機滑出了 Q2,分別是誰在負責?”),以及讓自動化安全地操作這些資料。
重建的答案可能是一個數月專案。ObjectOS 的路徑是先做一個低風險連線:
- 把 CRM 資料庫連線為一個只讀資料來源。
- 讓編碼 Agent 把你真正關心的那十來張表建模為物件。
- 向你的資料提問,並接上第一條自動化。
不用先替換 CRM,也不用先搬走資料。你在相同的資料行之上,得到一層支援 AI 的物件與權限邊界。
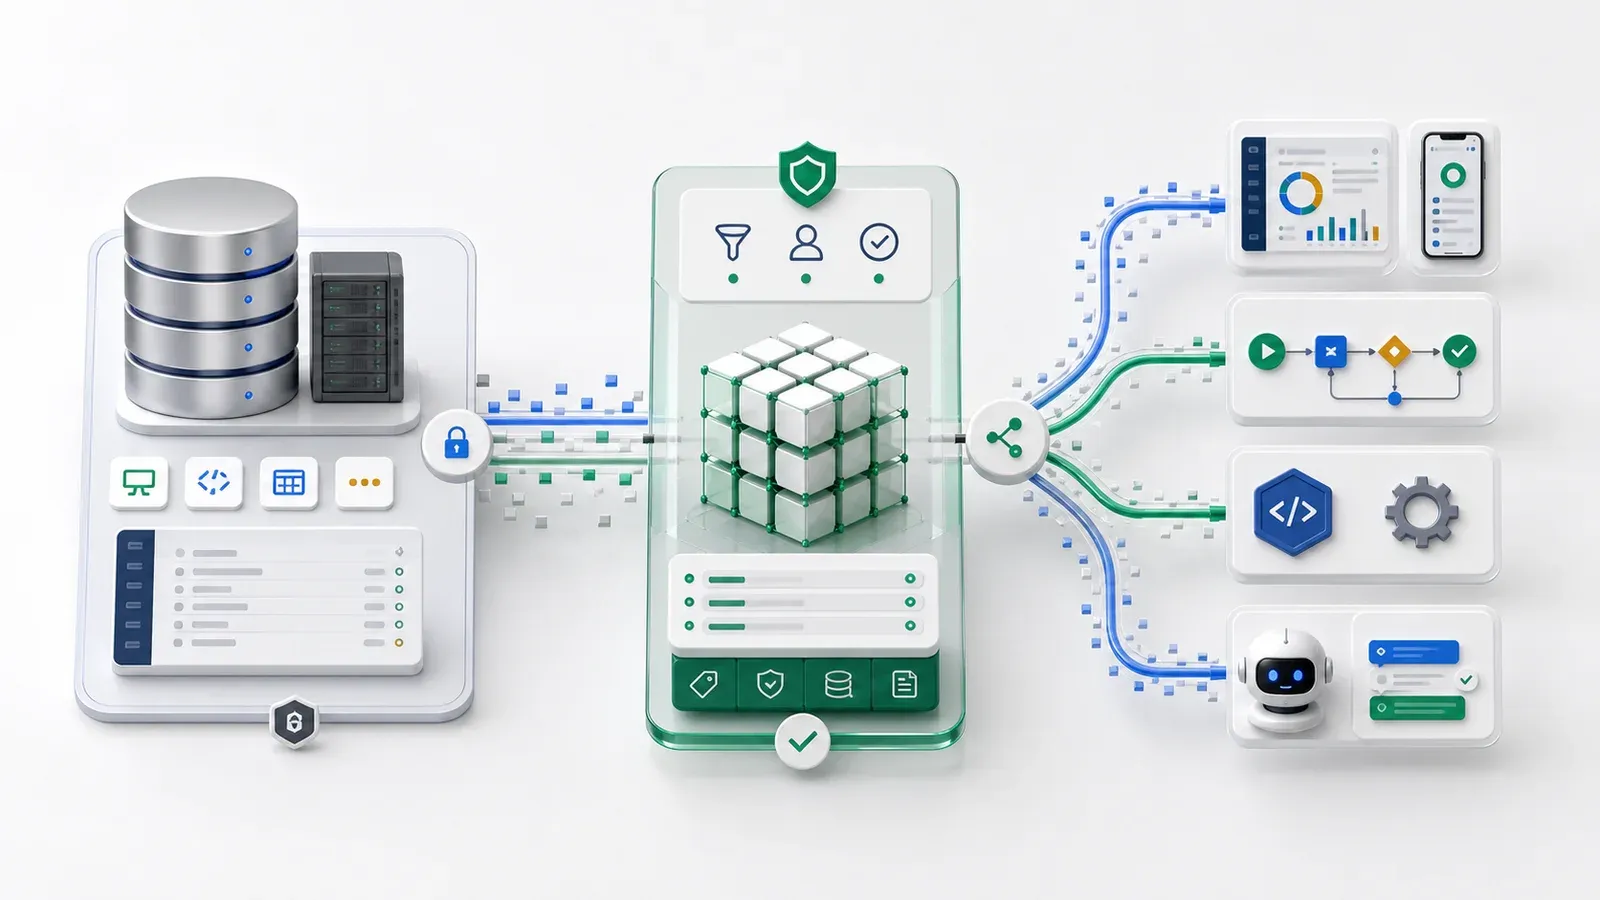
它今天
一共四步,而且沒有一步是“重建你的應用”。
1. 將資料庫
資料來源是一個具名連線 —— Postgres、MySQL、MongoDB、SQLite。憑據來自環境變數,絕不寫死在原始碼裡。如果你想先做分析,把它指向只讀副本或只讀資料庫使用者,寫入便根本無從發生。
import type { Datasource } from '@objectstack/spec';

export const BusinessDb: Datasource = {
  name: 'business_primary',
  label: 'Business System (Postgres)',
  driver: 'postgres',
  config: {
    connection: {
      host: process.env.BIZ_DB_HOST,
      user: process.env.BIZ_DB_USER,
      password: process.env.BIZ_DB_PASSWORD,
      database: process.env.BIZ_DB_NAME,
    },
  },
  pool: { min: 1, max: 10 },
  active: true,
};
2. 將資料
這一步人們以為會很慢,其實不然。你不必為每張表手工敲物件。把像 Claude Code 這樣的編碼 Agent 指向已連線的 schema,讓它完成內省與初稿。一句樸素的提示就夠了:
“連線到
business_primary資料來源。為這幾張表 ——accounts、contacts、opportunities、line_items—— 各生成一個src/objects/<name>.object.ts檔案,使用ObjectSchema.create。把 SQL 列對映到合適的Field.*型別,把外部索引鍵轉成Field.lookup(...),並在每個物件上設定datasource: 'business_primary'。”
Agent 會讀取真實的列、型別和外部索引鍵,寫出源級別的物件檔案。我們的
hotcrm 參考應用展示了輸出的確切形態:
import { ObjectSchema, Field } from '@objectstack/spec/data';

export const Opportunity = ObjectSchema.create({
  name: 'biz_opportunity',
  label: 'Opportunity',
  datasource: 'business_primary',
  fields: {
    name:      Field.text({ label: 'Name', required: true }),
    account:   Field.lookup({ label: 'Account', reference_to: 'biz_account' }),
    amount:    Field.currency({ label: 'Amount' }),
    stage:     Field.select({ label: 'Stage', options: [/* … */] }),
    close_date: Field.date({ label: 'Close Date' }),
  },
});因為產物是你擁有並提交的普通原始碼,你始終掌握控制權:保留重要的列、丟棄不想暴露的列,再疊加 label、校驗與權限。Agent 幾分鐘內把你帶到一份可審閱的初稿;你來讓它達到生產級別。
3. 將物件
每個物件都帶有 datasource。可以逐個物件設定,也可以為整個名稱空間宣告一條路由規則,讓其下每個物件繼承:
datasourceMapping: [
  { namespace: 'biz', datasource: 'business_primary' },
  { default: true,    datasource: 'default' },
]
規則按名稱空間、包名或物件名 glob 匹配;首個命中者生效。資料駐留的決策集中在一處,而不是散落在各個檔案裡。
4. 讓 AI 開始
一旦一張表成為物件,AI 層就能在它上面工作。ObjectOS 的 agent 與工具 ——
list_objects、describe_object、query_records、aggregate_data 以及
data-chat agent —— 都經由 ObjectQL,由它將每個物件路由到所繫結的資料來源,並在驅動支援時把過濾、排序與聚合下推進資料庫。
於是當用戶問:
“哪些企業級商機滑出了 Q2,分別是誰在負責?”
Agent 不會把整張表灌進提示詞。它會把這句話編譯成一條針對 biz_opportunity
的 ObjectQL 查詢 —— 對階段和關閉日期的 WHERE、對負責人的 join —— 在你的
Postgres 上以 SELECT … WHERE … 執行,並基於真實、當前的資料行作答。而且關鍵在於,它以已登入使用者的身份執行這條查詢:如果某個銷售在 CRM 裡看不到其他區域的商機,Agent 也同樣看不到。
為什麼
對“在我們的業務資料上跑 AI”的質疑總是關於治理,而這恰恰是執行時發揮作用的地方:
- AI 以使用者身份行動,絕不凌駕其上。 Agent 看到的,恰好是它背後那個人被允許看到的內容 —— 物件級、記錄級、欄位級權限由執行時強制,而非由提示詞約束。
- 如果你願意,預設只讀。 把物件繫結到只讀連線或只讀資料庫使用者。安全地分析生產資料;再有意識地、一個物件一個物件地開啟寫入。
- 一切皆有審計。 每一次讀取、寫入和提權 —— 無論來自人還是 Agent —— 都記錄下何人、何事、何時、何因。
- 你的資料留在你的網路裡。 自管部署時(ObjectOS Enterprise),ObjectOS 跑在你的環境中;運行同一份本體的開源 ObjectStack 執行時也是如此。業務資料留在你的資料庫裡;提示詞只會發給你配置的 AI 提供方(ObjectOS Cloud 則代為執行模型),模型能看到什麼由權限決定。
重建 vs. 連線
| 重建到新平臺 | 用 ObjectOS 連線 | |
|---|---|---|
| 首次見效時間 | 數月 | 從少量物件開始,逐步擴充 |
| 對記錄系統的風險 | 高 —— 資料遷移、雙寫、切換上線 | 低 —— 先只讀連線,源應用繼續執行 |
| 資料存放在哪 | 被搬走 | 原地不動 |
| 建模工作量 | 手工重新實現每個實體 | 編碼 Agent 從真實 schema 起草物件 |
| 權限 | 重建並重新審計 | 繼承;AI 遵守同一套模型 |
| 可逆性 | 難以撤銷 | 斷開資料來源 —— 什麼都沒變 |
第一
一旦幾張表被建模並繫結:
- 自然語言分析作用於即時記錄,經由 ObjectQL 計算 —— 而非一份過期的匯出。
- 受治理的自動化。 流程與動作讀取、並(在允許處)寫入同一批資料,每一步皆有審計。
- 生成式 API 與控制台。 REST/GraphQL 端點與管理介面源自同一份後設資料 —— 無需另建整合層。
- 同一套權限模型。 適用於人的邊界,同樣適用於 AI 流量。
已經
上面這套流程今天就能用,憑藉的是已交付的構建塊:資料來源、按物件路由、感知能力的 ObjectQL 下推,以及 AI Agent 層。物件的建模由一個編碼 Agent 針對你已連線的 schema 完成 —— 與 hotcrm 的物件被編寫出來的方式相同。
那套更豐富的開箱即用聯邦(turn-key federation)體驗 —— 一步式 schema 匯入、繫結到外部擁有的 schema、內建的寫入安全閘門 —— 已經交付。 ADR-0015 現在是 Accepted(後端、REST 與 CLI 均已實現), ADR-0062 則是其執行時那一半的規範決策。具體來說:
- schema 匯入是一條命令,而不是一個專案。
os datasource list-tables <name>列出遠端的表,os datasource introspect <name> --table <table>從活的表生成物件草稿 —— 列、型別、外部索引鍵。草稿依然是你自己評審並提交的普通原始碼。 - 繫結到你並不擁有的 schema,是一次宣告。 在資料來源上設定
schemaMode: 'external',ObjectStack 就不會對那個資料庫執行任何 DDL;每個物件通過external.remoteName/remoteSchema/columnMap指明自己的遠端表。宣告與真實的列不一致時,啟動會帶著 diff 失敗(validation: { onMismatch: 'fail' };起草階段可以用validate-only只告警),os datasource validate <name>則按需檢查。 - 寫入需要兩次分別開啟,落在兩個檔案裡。 資料來源上的
external.allowWrites: true,以及物件上的external.writable: true。任一道閘門關著,insert、update、delete 都會被拒絕。
這些閘門屬於聯邦:它們回答的是這個資料庫歸誰所有,因此只作用於外部資料來源,不作用於 ObjectStack 自己管理的資料來源。對於 ObjectStack 擁有的資料庫,只讀依然是資料庫層的 GRANT —— 與下面常見問題裡寫的完全一致。
ADR-0015 上仍未完成的,是聯邦的 Studio 介面,以及更多 SQL 方言的驅動。無論如何,本文走的這條路徑 —— 連線、建模、繫結、查詢 —— 沒有變化,也依然受支援。
常見
我必須把每張表都建模嗎? 不必。只建模你想讓 AI 和自動化觸及的表。資料庫其餘部分會被忽略。
這會寫入我的生產資料庫嗎? 只有你允許才會。繫結到只讀連線或只讀資料庫使用者,寫入便不可能發生;準備好後,再有意識地、按物件開啟寫入。
我的資料會發給模型廠商嗎? 自管部署(ObjectOS Enterprise)或開源 ObjectStack 執行時跑在你的環境中,查詢在你的資料庫上執行,AI 提供方由你配置;ObjectOS Cloud 則代為執行模型。無論哪個版本,模型能看到什麼都由權限決定。
如果我的 schema 變了怎麼辦? 針對更新後的 schema 重新執行編碼 Agent,重新生成或對受影響的物件做 diff —— 它們不過是你倉庫裡的原始碼檔案。
如果你已經有一個業務資料庫,那你已經走完了大半路程。連上它,建模幾張表,然後向你的資料提個問題。