既存の業務システムを移行せずに AI-native にする
セルフマネージドの ObjectOS(Enterprise)で、すでに動いているデータベースを既定の読み取り専用で接続し、コーディングエージェントでテーブルをオブジェクトとしてモデル化すれば、元のシステムを壊さず、権限の下で実データに AI を載せられます。
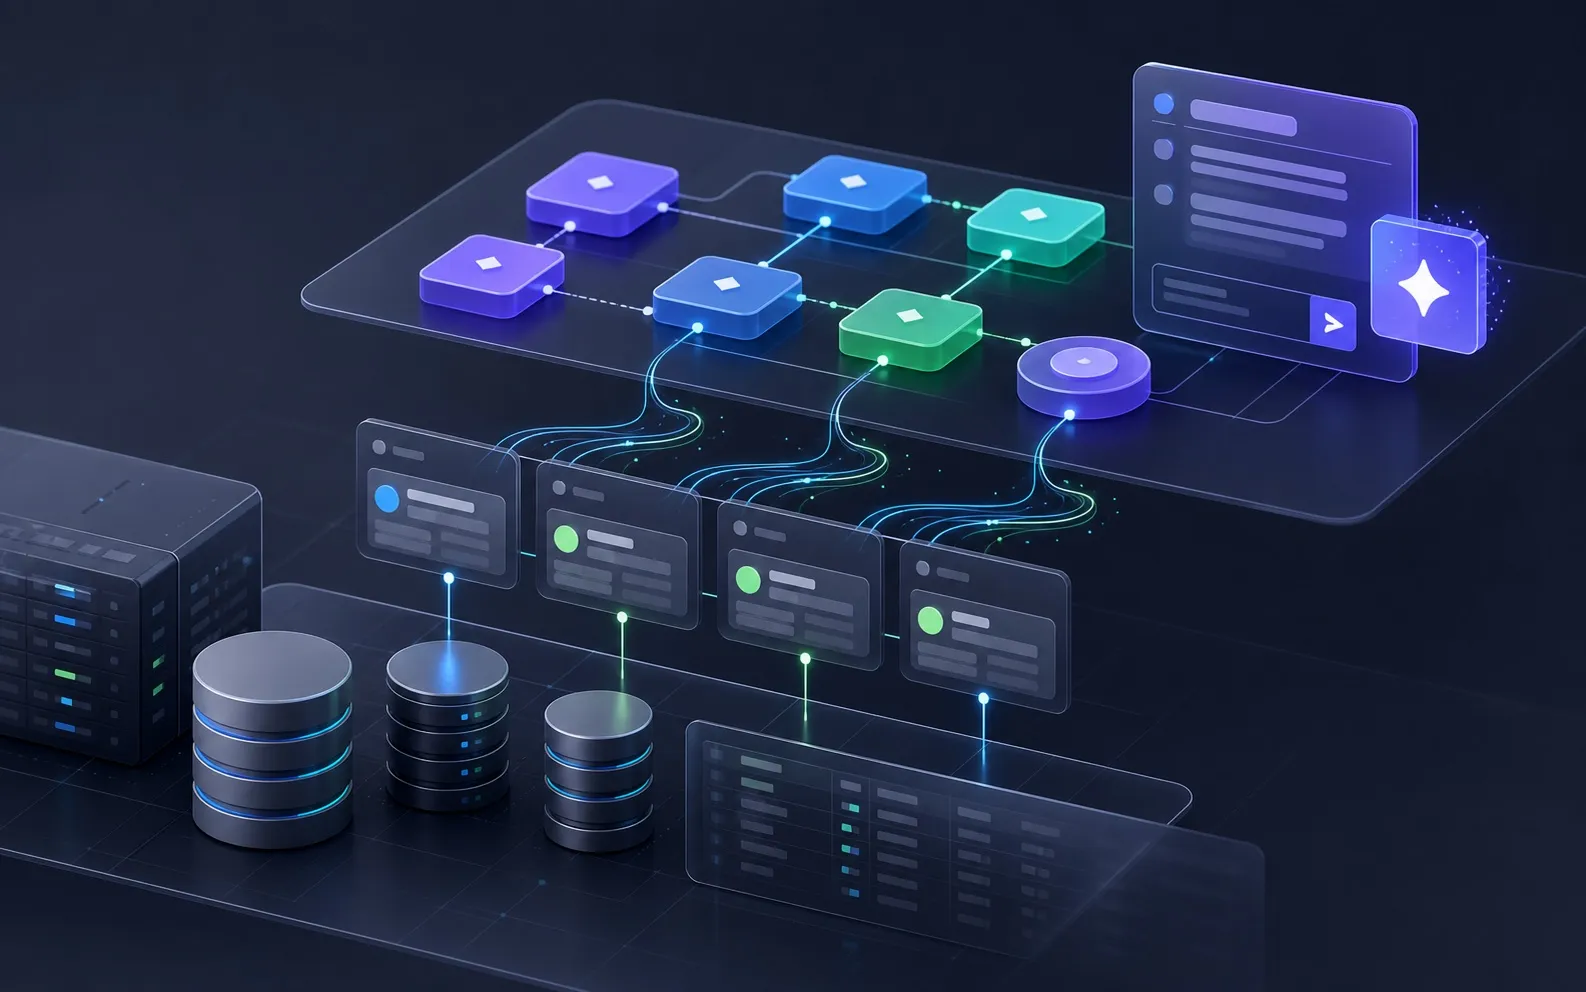
結論から言うと: 既存システムを AI-native にするのに、まず移行や作り直しは要らない——すでに動いているデータベースに ObjectOS を接続し、自分たちの権限の下でエージェントに実データを理解させればよい。作り直すのではなく、接続する。
「業務に AI を入れる」という提案の多くは、暗黙のうちに作り直しを前提にしています。データを新しい基盤へ移し、ワークフローを再実装し、チームを再教育し、移行がうまくいくことを祈る。誰も本当はそこをやりたくありません。CRM、ERP、チケット管理、社内の独自バックオフィスはすでに動いており、データもそこにあります。
ObjectOS の考え方は逆です。移行しない。接続する。
一文でいうと
セルフマネージドの ObjectOS(Enterprise。自社インフラで動き、データベースに到達できる構成)で、ObjectOS を既存データベースに既定の読み取り専用で向け、必要なテーブルをオブジェクトとして記述すると、AI エージェント、フロー、API、ダッシュボードがそのデータ上で動き始めます。データは適切なシステムへ自動的にルーティングされ、ユーザーがすでに持っている権限で統制されます。
元のアプリケーションは変わりません。行データも移動しません。ObjectOS は、既存システムの上に AI-native で権限を理解する表面を作ります。
具体例
40 テーブルほどある Postgres 製 CRM で営業チームを運営しているとします。取引先、担当者、商談、明細、活動履歴。何年分もの本番データがあり、営業担当は毎日そのアプリを使っています。経営層は、そのデータに自然言語で質問したいと考えています。
「Q2 から滑り落ちたエンタープライズ商談はどれで、誰が担当しているか?」
作り直すなら 6 か月のプロジェクトです。ObjectOS なら、最初の一歩は午後で始められます。
- CRM データベースを 読み取り専用 のデータソースとして接続する。
- 本当に必要な十数個のテーブルを、コーディングエージェントでオブジェクトとしてモデル化する。
- データに質問し、最初の自動化をつなぐ。
CRM には触りません。営業担当も気づきません。同じ行データの上に AI-native レイヤーができます。
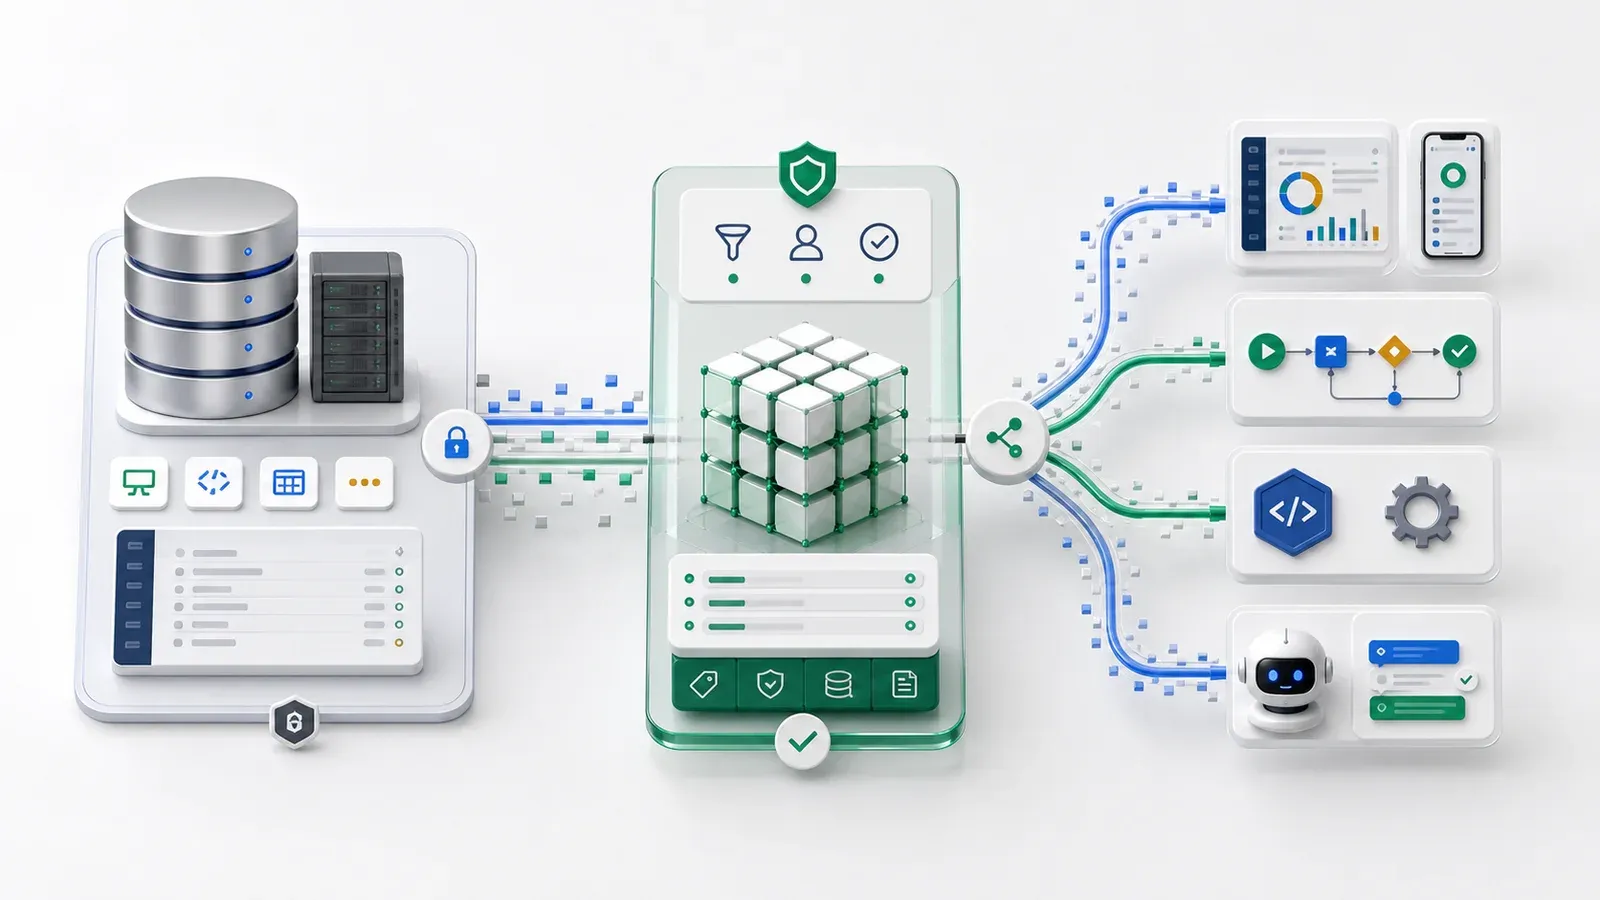
今日どう
1. データベースを
データソースは名前付き接続です。Postgres、MySQL、MongoDB、SQLite などを扱えます。認証情報は環境変数から読み、ソースに直書きしません。最初は分析だけなら、読み取りレプリカや読み取り専用 DB ユーザーを使えば、書き込みは物理的に起きません。
import type { Datasource } from '@objectstack/spec';

export const BusinessDb: Datasource = {
  name: 'business_primary',
  label: 'Business System (Postgres)',
  driver: 'postgres',
  config: {
    connection: {
      host: process.env.BIZ_DB_HOST,
      user: process.env.BIZ_DB_USER,
      password: process.env.BIZ_DB_PASSWORD,
      database: process.env.BIZ_DB_NAME,
    },
  },
  pool: { min: 1, max: 10 },
  active: true,
};
2. コーディングエージェントで
1 テーブルずつ手で書く必要はありません。Claude Code のようなコーディングエージェントを接続済み schema に向け、実カラム、型、外部キーを読ませ、最初のドラフトを書かせます。
「
business_primaryに接続し、accounts、contacts、opportunities、line_itemsからsrc/objects/<name>.object.tsを生成して。SQL カラムを適切なField.*型に対応させ、外部キーはField.lookup(...)にし、各オブジェクトへdatasource: 'business_primary'を設定して。」
出力はあなたが所有し commit する普通のソースコードです。必要な列を残し、AI に見せたくない列を落とし、ラベル、検証、権限を重ねられます。
3. オブジェクトを
各オブジェクトに datasource を持たせてもよいし、名前空間ごとにルーティングルールを宣言して継承させてもかまいません。
datasourceMapping: [
  { namespace: 'biz', datasource: 'business_primary' },
  { default: true,    datasource: 'default' },
]
データ所在の判断がファイルのあちこちに散らばらず、一か所で管理できます。
4. AI を
テーブルがオブジェクトになった瞬間、AI レイヤーはそれを扱えます。ObjectOS の list_objects、describe_object、query_records、aggregate_data、data-chat エージェントは ObjectQL を通り、各オブジェクトをバインド先データソースへルーティングします。
ユーザーが「Q2 から滑った商談」を聞くと、エージェントはテーブル全体をプロンプトへ詰めません。biz_opportunity への ObjectQL を作り、ステージやクローズ日の WHERE、担当者への join を使って Postgres 上で実行します。さらに、そのクエリはログイン中ユーザーとして動きます。営業担当が別地域の商談を見られないなら、エージェントも見られません。
なぜ
- AI はユーザーとして動き、ユーザーを超えない。 オブジェクト、レコード、フィールド単位の権限はプロンプトではなくランタイムで強制されます。
- 必要なら読み取り専用から始められる。 読み取り専用接続や DB ユーザーにバインドすれば、本番データを安全に分析できます。
- すべて監査される。 人でもエージェントでも、読み取り、書き込み、昇格は誰が、何を、いつ、なぜ行ったか記録されます。
- データはあなたのネットワーク内に残る。 セルフマネージド(ObjectOS Enterprise)なら ObjectOS はあなたの環境で動き、同じオントロジーを動かすオープンソースの ObjectStack ランタイムも同様です。業務データはあなたのデータベースに残り、プロンプトはあなたが設定した AI プロバイダーだけに送られます(ObjectOS Cloud ではモデルはホスト側で運用されます)。モデルに何を見せるかは権限が決めます。
作り
| 新基盤へ作り直す | ObjectOS で接続する | |
|---|---|---|
| 最初の価値まで | 数か月 | 午後 |
| 記録システムへのリスク | 高い | なし |
| データの場所 | 移動する | そのまま |
| モデリング | 手作業で再実装 | 実 schema からエージェントがドラフト |
| 権限 | 作り直し、再監査 | 継承 |
| 戻しやすさ | 難しい | データソースを外すだけ |
初日に
- ライブデータに対する自然言語分析。
- 監査つきの自動化。
- 同じメタデータから生成される API と Console。
- 人間と AI に共通する権限モデル。
すでにあるものと、これから
上の流れは、データソース、オブジェクト別ルーティング、ObjectQL のプッシュダウン、AI エージェント層で今日動きます。オブジェクトモデリングは、接続済み schema に対してコーディングエージェントが行います。
より豊かな turn-key federation、つまり一回の schema import、外部所有 schema へのバインド、組み込みの書き込み安全ゲートは、すでに出荷済みです。ADR-0015 は Accepted(バックエンド・REST・CLI 実装済み)、ランタイム側は ADR-0062 が規範です。
os datasource list-tables <name> がリモートのテーブルを列挙し、os datasource introspect <name> --table <table> が実テーブルからオブジェクトの下書きを生成します。データソースに schemaMode: 'external' を置けば ObjectStack はそのデータベースに DDL を実行せず、宣言が実際の列と食い違えば起動が diff とともに失敗します(validation: { onMismatch: 'fail' })。書き込みには 2 つのファイルでの 2 回のオプトインが要ります —— データソースの external.allowWrites: true と、オブジェクトの external.writable: true。どちらか一方でも閉じていれば insert・update・delete は拒否されます。これらのゲートは federation のものであり、ObjectStack が管理するデータベースでは read-only は今もデータベースの GRANT です。ADR-0015 に残っているのは federation の Studio UI と、SQL 方言ドライバの拡充です。
よくある
すべてのテーブルをモデル化する必要がありますか? いいえ。AI と自動化に触らせたいテーブルだけで十分です。
本番 DB に書き込みますか? 許可しない限り書き込みません。読み取り専用接続なら不可能です。
データはモデルプロバイダーへ送られますか? セルフマネージド(ObjectOS Enterprise)またはオープンソースの ObjectStack ランタイムなら、ランタイムはあなたの環境で動き、クエリはあなたの DB に対して実行され、AI プロバイダーはあなたが設定します。ObjectOS Cloud ではモデルはホスト側で運用されます。どのエディションでも、モデルに何を見せるかは権限が決めます。
schema が変わったら? 更新後の schema に対してコーディングエージェントを再実行し、影響を受けるオブジェクトを再生成または diff します。
すでに業務データベースがあるなら、道のりの大半は終わっています。接続し、いくつかのテーブルをモデル化し、データに質問してみてください。