旧システムのスプレッドシートを AI が作ったアプリに取り込むには? インポートマッピング、ドライラン、そして行が一致しない三つの結末
ObjectStack 18.3.0 で計測:名前付きインポートマッピングが他社のヘッダーとコードを一つのオブジェクトの項目に射影し、ドライランは何も保存せずに行ごとの完全なレポートを返し、一致しない行は作成・スキップ・失敗のいずれかになる。
要点。 旧システムから届くスプレッドシートは、ヘッダーがあなたの項目名ではなく、コードもあなたのコードではない。解決策はインポートマッピングだ。ファイルの列から一つのオブジェクトの項目への、名前とバージョンを持つ射影であり、map が相手システムのコードを翻訳し、upsertKey が「同じ行」とは何かを決める。マッピングは厳密で、そこに名前のない列は書き込み経路に決して届かない。dryRun: true は何も保存せずに行ごとの完全なレポートを返す。公開済みの @objectstack/cli 18.3.0 で計測した結果:3 行の CSV は、テーブルがまだ 0 行の状態でドライランから created: 3 を返し、本番実行後にテーブルは 3 行になり、同じファイルをもう一度送ると updated: 3 と答えた。ドライランこそがレビューである。何かが着地する前に承認する、前後の件数だ。
以下はすべて実行した結果であり、説明ではない。アプリは 18.3.0 上で npm create objectstack@latest が生成した新規スキャフォールドに、ObjectStack リポジトリ同梱の CRM サンプルの Lead オブジェクトを載せたもので、すべての件数はサーバー自身のレポートから引用している。
毎週
これがそのファイルだ。ページに収まるよう 3 行にしてあるが、仕組みは 3,000 行でも同じである。
Full Name,E-mail,Company,Channel,Legacy ID
Ada Lovelace,[email protected],Analytical Engines,Webform,L-1001
Alan Turing,[email protected],NPL,Partner Referral,L-1002
Grace Hopper,[email protected],Eckert-Mauchly,Webform,L-1003
そして、これが着地先のオブジェクトだ。CRM サンプルの crm_lead は name、email、company、そして保存値が web、referral、event、social、cold_outreach、partner である source 選択項目を宣言している。
このファイルには三つの問題があり、それは他システムからのエクスポートが必ず抱える三つの問題でもある。
- ヘッダーが相手のものである。
Full Nameはこちらのname、E-mailはこちらのemailだ。 - コードが相手のものである。 相手の
Webformはこちらのweb、相手のPartner Referralはこちらのpartnerだ。どちらの綴りもこちら側には存在しない。 - 着地してはいけない列がある。
Legacy IDは旧システムの主キーだ。ここに対応する項目はなく、うっかり生えてもいけない。
インポートウィザードの一回限りのリネームは一つ目の問題を解決するが、それ以上は何もしない。残り二つには、一度書き留めて毎週適用される何かが必要だ。
インポートマッピングは
ObjectStack のドキュメントはこの成果物を一文で定義している。「インポートマッピングは、ソースファイルの列から一つのオブジェクトの項目への、名前付きで再利用可能な射影である。」第一級のメタデータ種別なので、パッケージに同梱することも実行時に保存することもでき、POST /api/v1/data/:object/import が名前で適用する。以下の計測で使ったのがこれで、アプリのソースにオブジェクトと並べて宣言してある。
import { defineMapping } from '@objectstack/spec/data';

export const LeadFeedMapping = defineMapping({
  name: 'crm_lead_feed',
  label: 'Lead feed (legacy CRM export)',
  sourceFormat: 'csv',
  targetObject: 'crm_lead',
  fieldMapping: [
    { source: 'Full Name', target: 'name' },
    { source: 'E-mail', target: 'email' },
    { source: 'Company', target: 'company' },
    {
      source: 'Channel',
      target: 'source',
      transform: 'map',
      params: { valueMap: { Webform: 'web', 'Partner Referral': 'partner' } },
    },
  ],
  mode: 'upsert',
  upsertKey: ['email'],
});
これは mappings: [LeadFeedMapping] でスタックに登録され、defineStack() は初回利用時ではなくビルド時に検証する。スタックが定義していない targetObject はビルドを失敗させ、javascript 変換も同様だ(後述)。defineMapping() は import 時に設定をパースするため、キーの綴り間違いは書いたその場所で、正しい綴りをエラーに示して拒否される。これがマッピングを設定ファイルではなく型付きメタデータたらしめる理由であり、レビュアーは 20 行を読めば、どの行も読まれる前にこの射影が正しく構成されていると分かる。
| キー | 決めること |
|---|---|
fieldMapping[] | 対象項目ごとに一項目:どのソース列が供給し、どの変換を通るか |
transform: 'map' + valueMap | ソースシステムのコードをこちらのコードに翻訳する。表にない値はそのまま通過する |
mode | リクエストが writeMode を省略したときに補う:insert、update、upsert |
upsertKey | リクエストが matchFields を省略したときに補う:行が保存済みレコードと「同じ行」かどうかを決める項目 |
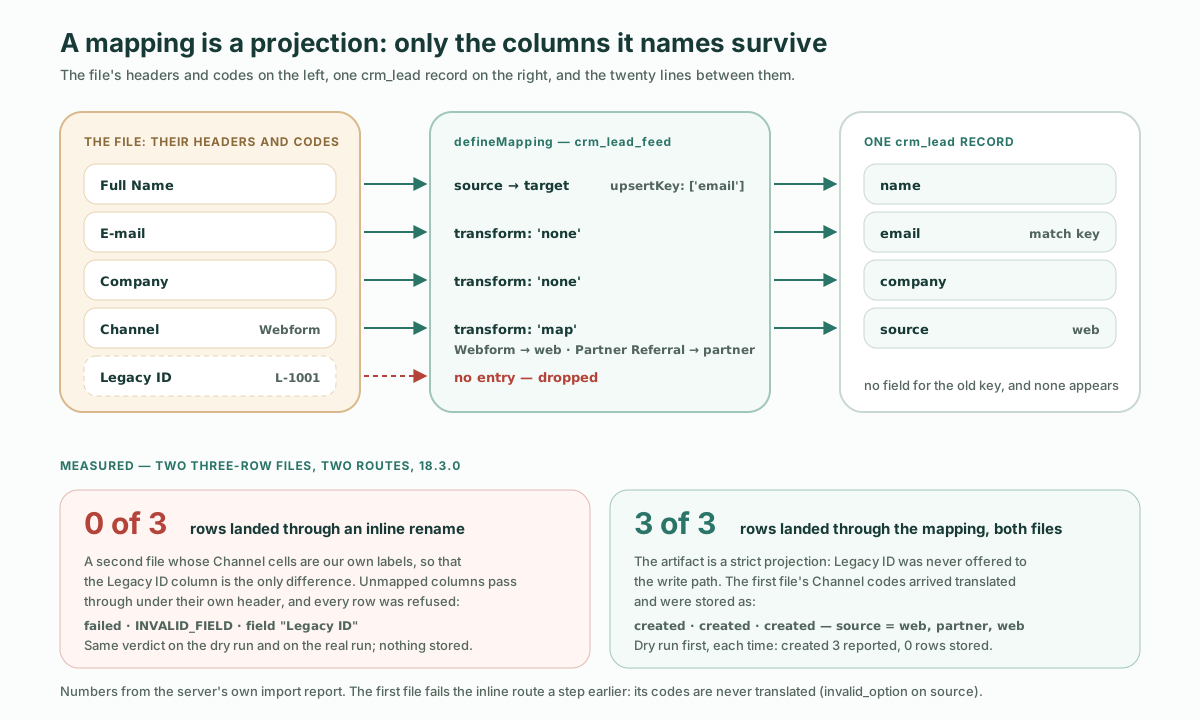
定義の中で重要な言葉は射影だ。インポートエンドポイントは二つのマッピング機構を受け付け、両者はちょうど上の三つ目の問題で分かれる。リクエスト上のインライン mapping はリネームだ。その配列形式はセルのトリム、大文字小文字の変換、空セルの補完はできるがコード表は持たない。そして、そこに名前のない列は「自身のヘッダーのまま書き込み経路に通過する」。名前付きマッピングはその逆で、マッピングされない列は「捨てられる。成果物は厳密な射影であり、マッピングされた対象だけが生き残る。」
この違いは計測できるので、計測した。使ったのは二つ目の 3 行ファイルで、余分な列だけが二つの経路の唯一の相違点になるよう作ってある。Channel セルにはこちらの選択肢ラベル(Website、Partner)が入っていて、マッピングなしで解決され、そして Legacy ID 列を持つ。これを既知の 4 列のインラインリネームでドライランと本番実行を一度ずつ、mappingName: "crm_lead_feed" でドライランを一度送った:
| 経路 | 着地した行 | レポートが各行について述べたこと |
|---|---|---|
インライン mapping、ドライラン | 3 行中 0 行 | failed、code: "INVALID_FIELD"、field: "Legacy ID"、“Unknown field ‘Legacy ID’ on object ‘crm_lead’” |
インライン mapping、本番実行 | 3 行中 0 行 | 同じ三つの判定。何も保存されない |
mappingName、ドライラン | 3 行中 3 行 | created |
インライン経路が壊れているわけではない。リネームがすることをしただけだ。Legacy ID を自身のヘッダーのまま通し、書き込み経路がオブジェクトの宣言にない項目を拒否した。マッピングはその列を書き込み経路に近づけることすらしなかった。Webform と Partner Referral のコードを持つ最初のファイルは、インライン経路では一歩手前で失敗する。どの行も source の invalid_option で拒否され、“Lead Source: ”Webform“ is not a known option” となる。コードを翻訳するものが何もないからだ。制御できないシステムから毎週届くファイルにとって、この二つの保証こそが 20 行を書く理由である。
マッピングはパッケージに同梱する代わりに実行時に保存することもできる。同じ形を別の名前で PUT /api/v1/meta/mapping/crm_lead_feed_saved に送ると Saved mapping 'crm_lead_feed_saved' (env-wide, state=active) [seq=1] と答え、その名前を指定したドライランは created 3 を報告した。どちらであれインポートリクエストはマッピングを名前で解決し、ランタイムは保存されたマッピングを先に読み、パッケージ同梱のものにフォールバックする。パッケージ側の名前そのものはロックされている。同じ PUT を crm_lead_feed に送ると 403 NOT_OVERRIDABLE で拒否された。
ドライランこそが
マッピングを持つ価値を生むリクエストは短い。書き込みモードと一致項目を成果物が供給するからだ。
POST /api/v1/data/crm_lead/import
{
  "format": "csv",
  "csv": "Full Name,E-mail,Company,Channel,Legacy ID\nAda Lovelace,...",
  "mappingName": "crm_lead_feed",
  "dryRun": true
}
ドライランはレポート全体、すなわち集計カウンターと行ごとの判定を返した。
{ "object": "crm_lead", "dryRun": true, "writeMode": "upsert",
  "total": 3, "ok": 3, "errors": 0, "created": 3, "updated": 0, "skipped": 0,
  "results": [
    { "row": 1, "ok": true, "action": "created" },
    { "row": 2, "ok": true, "action": "created" },
{ "row": 3, "ok": true, "action": "created" } ] }そしてテーブルを読んだ:"total": 0。何も保存されていない。dryRun を外した同じボディは各行に id を付けて "created": 3 と答え、テーブルは "total": 3、source にはファイルのコードではなく翻訳後の web、partner、web が入っていた。同じファイルを三度目に送ると "created": 0, "updated": 3 と答え、テーブルはやはり 3 のままだった。これが前後の全体像で、三つの数字に収まる。
| ステップ | レポート | 直後のテーブルの行数 |
|---|---|---|
| ドライラン | total 3 · created 3 · updated 0 | 0 |
| 本番実行 | created 3 | 3 |
| 同じファイルをもう一度 | created 0 · updated 3 | 3 |
なぜプレビューではなくレビューと呼ぶのか。それが、レビュアーが実際に承認できる成果物だからだ。ドキュメントは正確に述べている。"dryRun": true は「何も永続化せずに同じレポートを返す。判定はエンジン自身の書き込み経路の検証から来る」。書き込みが何をするかの推測ではなく、行ごとに書き込み経路へ判定を求め、永続化の手前で止まる。したがって、月曜のインポートが走る前に事業責任者が承認するのは二つの小さなものだ。マッピング(20 行の型付きメタデータ、バージョン管理下にあり、差分として読める)と、ドライランレポート(何行が作成され、何行が更新され、どの行がどの列で失敗するか)。署名の時点では何も起きておらず、二度目の実行が一度目の言葉どおりだったことの証明になる。
このプレビューは、更新される行についても成り立つ。3 行が存在した後でもう一度送ると、ドライランは created 0 · updated 3 と答え、続く本番実行も同じ判定を返した。更新は、保存済みレコードにファイルのセルをマージしたものに対してプレビューされる。だから Lead オブジェクトの lead_score_range チェックが lead_score を読むように、ファイルにない項目を読むルールも、書き込みが実際に保存するレコードを判定する。18.0 より前のプレビューは到着したセルだけで判定し、書き込みが受け付ける行を拒否することがあった。勧告レベルの指摘があっても書き込みが受け入れる行は、ok のまま warnings リストを添えて返るので、その指摘は黙殺されずにレポートに見える。ここでの実行では一度も出なかった。
行が
upsertKey: ['email'] が「同じ行」の意味を定める。興味深いのは、その検索がちょうど一件を見つけられない場合だ。ドキュメントはこの点に率直で、「一致しない行」は一つの振る舞いではなく三つであり、writeMode と一致したレコード数によって選ばれる、と述べている。
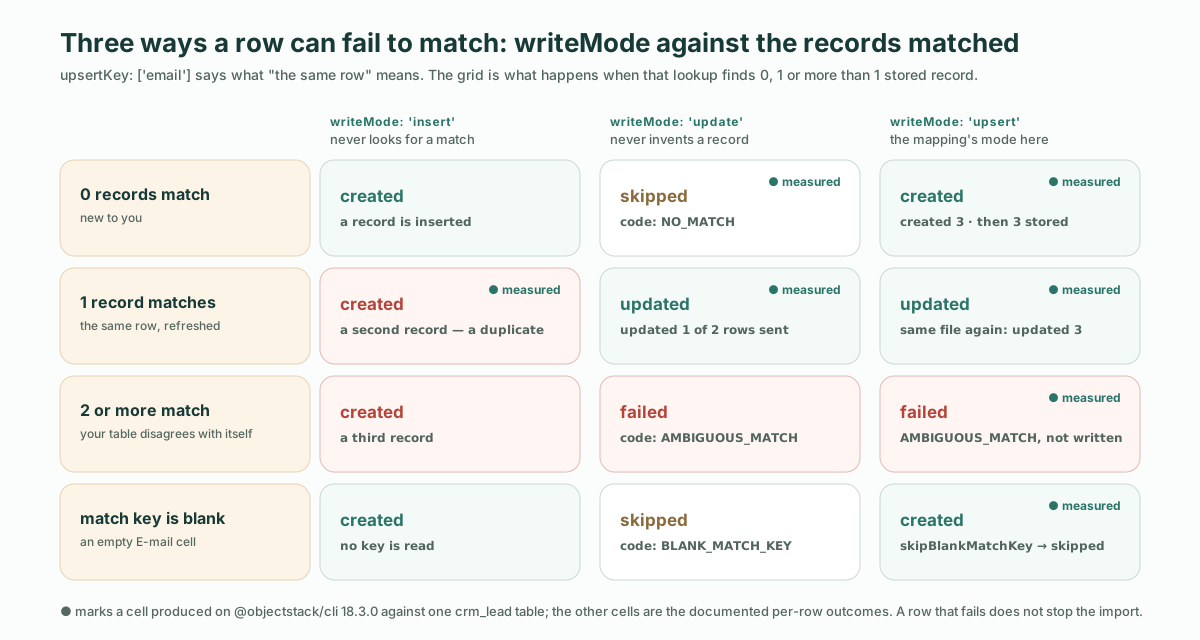
三つすべてを同じテーブルに対して作り出し、それぞれが異なる種類の答えだった。
| 一致した行数 | writeMode: 'upsert' | writeMode: 'update' | ファイルにとっての意味 |
|---|---|---|---|
| 0 | created | skipped、code: "NO_MATCH" | あなたにとって新しい行。upsert は受け入れ、update はレコードの捏造を拒む |
| 1 | updated | updated | 同じ行の更新 |
| 2 以上 | failed、code: "AMBIGUOUS_MATCH" | failed、code: "AMBIGUOUS_MATCH" | テーブル自身がすでに矛盾している。その行には何も書かれない |
計測した実行:2 行のファイルを writeMode: "update" で送ると updated 1, skipped 1 と答え、未知の人物の行は "action": "skipped", "code": "NO_MATCH" と読めた。次に 1 行を writeMode: "insert" で二度ロードした。insert は一致を探さないので、テーブルには同じメールの 2 レコードが残り、同じ行を upsert で送ると "action": "failed", "code": "AMBIGUOUS_MATCH"、メッセージは “matchFields matched more than one crm_lead record” だった。重複はテーブルについての事実であり、インポートは一方を選ぶ代わりにそれを報告する。
知っておく価値のある四つ目の行がある。一致項目が空の行だ。E-mail セルが空の行は upsert によって作成された。upsert は既定でそのような行を作成するからだ。リクエストに "skipBlankMatchKey": true を付けると、同じ行は "action": "skipped", "code": "BLANK_MATCH_KEY" で返ってきた。どちらを望むかは、メールのないリードがリードなのか誤記なのかによる。そしてそれはマッピングではなくリクエストが運ぶ決定だ。
18.2 でもう一つのケースが加わった。ファイル自体が矛盾している場合だ。一回の upsert または update の中で 2 行が同じ一致キーを持つと、どちらも書き込まれない。ドライランでも本番実行でも同じだ。[email protected] を二度含む 3 行のファイルは ok 1 · errors 2 と答え、3 行目は作成され、重複した 2 行は "action": "failed", "code": "DUPLICATE_MATCH_KEY" と次のメッセージで返ってきた。
Rows 1, 2 of this import have the same match key (email), so none of them was written: keep one row per key and import again直す場所はスプレッドシートだ。正しい方の行を残して、ファイルをもう一度送る。
マッピングの
マッピングはどの値がどの項目に着地するかを決める。その値をストレージが受け付けるものに変換するのは別のステップで、マッピングの後に対象オブジェクト自身の項目メタデータから実行され、二つのステップは異なる失敗の仕方をする。4 行のファイルで一度のリクエストにそれらを試した。
| セル | 起きたこと | 行の判定 |
|---|---|---|
Channel = Trade Show、valueMap の知らないコード | map はドキュメントどおりそのまま通し、選択項目の変換が Trade Show という選択肢を見つけられなかった | failed、field: "source"、code: "invalid_option"、“Lead Source: ”Trade Show“ is not a known option” |
Channel = Event、valueMap にはないが既存の選択肢のラベル | そのまま通過し、ラベルによって保存値 event に解決された。マッピング項目は関与していない | created |
E-mail = not-an-email | email 項目自身の変換が拒否した | failed、field: "email"、code: "invalid_email" |
E-mail が空 | 上述のとおり upsert が受け入れた | created |
4 行のうち 2 行が着地し 2 行が着地せず、レポートは "ok": 2, "errors": 2 と読めた。失敗した行はインポートを止めず、問題の列を名指しした自分の行を得る。それが来週の月曜までに誰かがスプレッドシートで直す行だ。
二つ目のケースは map の用途を画定するので一言に値する。選択項目のラベルは、アプリ自身の言語でも翻訳でも、マッピングなしで保存値に解決される。したがって valueMap はインポートにあなたの選択肢ラベルを教えるためのものではなく、相手システムのコード、つまりあなたの値でもラベルでもない綴りのためのものだ。Webform には map が要る。Event には最初から要らなかった。
どの
行ごとに答えるとリクエスト自体の誤りが隠れてしまうため、行ごとのレポートなしに丸ごと拒否されるリクエストがある。そのうち三つを計測し、残りは文書化された表からだ。
| ステータス | code | 原因 |
|---|---|---|
| 404 | MAPPING_NOT_FOUND | その名前で登録されたマッピングがない。計測値:“No mapping artifact named ”crm_lead_feed_nope“ is registered” |
| 400 | CONFLICTING_MAPPING | 一つのリクエストに mappingName とインライン mapping の両方。計測値:“Provide either mappingName or an inline mapping, not both” |
| 400 | MAPPING_TARGET_MISMATCH | 成果物の targetObject が URL のオブジェクトではない |
| 400 | UNSUPPORTED_TRANSFORM | ある項目が javascript を、あるいはパイプラインが実装しない変換を宣言している |
| 413 | PAYLOAD_TOO_LARGE | 同期経路で 5,000 行を超える |
上限は正確だ。5,001 行のファイルは “Import limit is 5000 rows per request (got 5001). Use an async import job for larger files.” で拒否された。5,000 行のファイルはドライランとして一度の応答で "total": 5000, "ok": 5000, "created": 5000 を返した。それを超えると POST /api/v1/data/:object/import/jobs が同一のボディをパースし、最大 50,000 行を受け付けてポーリング用のジョブ id を返す。その経路はここでは実行していない。
これが
マッピング内のカスタムコード。 TransformType は七つの値を宣言している:none、constant、map、split、join、lookup、javascript。最初の五つは行ごとに実行され、lookup はインポート自身の参照解決への意図的なパススルーで、javascript は拒否される。「サーバー側のサンドボックスがなく、宣言された変換を黙って飛ばせばデータが壊れる」からだ。この拒否の両面を 18.3.0 で計測した。パッケージ内マッピングの一項目を transform: 'javascript' に変えると objectstack build は “Mapping ‘crm_lead_feed’ uses transform ‘javascript’, which the import path does not execute (no server-side sandbox). Use none/constant/map/split/join/lookup, or model the logic as a flow.” で失敗した。同じものを PUT /api/v1/meta/mapping/... で実行時に保存すると保存は受け付けられ、それを名指しした最初のインポートが 400 UNSUPPORTED_TRANSFORM で拒否された。五つの変換を超えるロジックについてのドキュメントの答えは、送信前にデータを変換するか、対象オブジェクト上のフローとしてモデル化することだ。レビュアーにとってもそれが正しい境界である。通して読めるマッピングだけが、承認できるマッピングだ。
旧い列の意味を決めること。 マッピングは Partner Referral が partner を意味するという決定を記録するが、決定そのものはしない。Trade Show のリードが六つの source 値のどれなのか、メールのないリードがリードなのかは、両方のシステムを知る誰かが言わなければならない。
インポートウィザード、自動化、非同期経路。 ユーザーが選んだ列からマッピングを保存するウィザードは製品の画面であり、本稿では扱わない。ここでのすべては、エージェントやスクリプトが使う REST 経路に留めた。リクエストは runAutomations キーを受け付けるが、行が入ってくる途中で何をトリガーするかは別のテーマだ。そして 50,000 行のジョブ経路は名前を挙げただけで、実行していない。
移行の
これはロードのステップであり、意図的に小さい。旧システムをそもそも移すべきかが問いなら、レガシーな社内システムから段階的に離れる道筋が戦略だ。読み取り専用で接続し、宣言したルールを履歴に照らして測り、オブジェクトごとに書き込みを有効にする。旧システムを残したまま何も動かさずに AI をそのデータに載せたいなら、すでに運用しているデータベースへの接続が仕組みであり、製造業向けの版はシステムが ERP のときにどこから始めるかを示す。インポートマッピングはその中間のケース、つまりシステムが廃止される、あるいは API を持ったことがなく、手元にあるのがファイルだけという場合のためのものだ。
ホスト型で、あるいは
上のすべては、スキャフォールドがインストールするオープンソースのランタイムで実行した。ObjectOS には 3 つのエディションがあります。オープンソースで無料でセルフホストできる ObjectOS Community、ブラウザ上でホストされインストール不要の ObjectOS Cloud、自社インフラでセルフマネージドの ObjectOS Enterprise です。オントロジーは通常の ObjectStack メタデータです。ObjectOS Cloud または ObjectOS Enterprise からエクスポートしてオープンソースの ObjectStack ランタイムで実行する機能は、計画中です。マッピングはそのオントロジーの一部であり、パッケージとともに移動する。
エージェントの
npm create objectstack@latest crm && cd crm次に、コーディングエージェントにファイルとインポートマッピングのドキュメントページ(objectstack.ai/docs/data-modeling/import-mappings)を渡し、三つを頼む。行が属するオブジェクト、ファイルが使うすべてのコードを valueMap が翻訳する defineMapping、そして実際のファイルのドライラン。返ってくるのがレビューだ。一度で読み切れる長さのマッピングと、何行が作成され、何行が更新され、どのセルを誰かが直さなければならないかを述べたレポート。それに署名して、インポートを実行する。来週の月曜にもう一度実行し、期待どおりの場所で updated を読む。