Wie importiert man eine Tabelle aus einem Altsystem in eine KI-gebaute App? Import-Mappings, Dry Runs und die drei Arten, wie eine Zeile nicht matcht
Gemessen auf ObjectStack 18.3.0: Ein Import-Mapping projiziert fremde Spalten und Codes auf ein Objekt, ein Dry Run liefert den Zeilenbericht ohne zu speichern, eine Zeile ohne Treffer wird erstellt, übersprungen oder abgelehnt.
Die Kurzfassung. Die Tabelle aus dem Altsystem hat Spaltenköpfe, die nicht Ihre Feldnamen sind, und Codes, die nicht Ihre Codes sind. Die Lösung ist ein Import-Mapping: eine benannte, versionierte Projektion von den Spalten der Datei auf die Felder eines Objekts, in der map die Codes des anderen Systems übersetzt und upsertKey festlegt, was „dieselbe Zeile“ bedeutet. Das Mapping ist strikt: Eine Spalte, die es nicht benennt, erreicht den Schreibpfad nie. dryRun: true liefert den vollständigen Bericht pro Zeile, ohne etwas zu speichern. Gemessen auf der veröffentlichten @objectstack/cli 18.3.0: Eine CSV mit 3 Zeilen kam aus dem Dry Run mit created: 3 zurück, während die Tabelle noch 0 Zeilen hielt, hielt nach dem echten Lauf 3 Zeilen und antwortete mit updated: 3, als dieselbe Datei erneut gesendet wurde. Der Dry Run ist das Review: ein Vorher-nachher-Zählwert, den Sie freigeben, bevor irgendetwas landet.
Alles unten wurde ausgeführt, nicht beschrieben. Die App ist ein frisches npm create objectstack@latest-Gerüst auf 18.3.0 mit dem Lead-Objekt aus dem CRM-Beispiel, das im ObjectStack-Repository mitgeliefert wird, und jede Zahl ist aus dem Bericht des Servers selbst zitiert.
Die Datei, die jeden Montag kommt
Hier ist die Datei. Sie hat drei Zeilen, damit sie ganz auf die Seite passt; die Mechanik ist bei dreitausend dieselbe.
Full Name,E-mail,Company,Channel,Legacy ID
Ada Lovelace,[email protected],Analytical Engines,Webform,L-1001
Alan Turing,[email protected],NPL,Partner Referral,L-1002
Grace Hopper,[email protected],Eckert-Mauchly,Webform,L-1003
Und hier ist das Objekt, in dem sie landen muss. Das crm_lead des CRM-Beispiels deklariert name, email, company und ein Auswahlfeld source, dessen gespeicherte Werte web, referral, event, social, cold_outreach und partner sind.
Drei Dinge stimmen an der Datei nicht, und es sind die drei Dinge, die jeder Export aus einem anderen System falsch macht:
- Die Spaltenköpfe sind ihre.
Full Nameist unsername;E-mailist unseremail. - Die Codes sind ihre. Ihr
Webformist unserweb; ihrPartner Referralist unserpartner. Keine der beiden Schreibweisen existiert auf unserer Seite. - Eine Spalte darf nicht landen.
Legacy IDist der Primärschlüssel des Altsystems. Hier gibt es kein Feld dafür, und es soll auch keines aus Versehen entstehen.
Ein einmaliges Umbenennen im Import-Assistenten löst das erste Problem und sonst nichts. Die anderen beiden brauchen etwas, das einmal aufgeschrieben und jede Woche angewendet wird.
Ein Import-Mapping ist eine Projektion, keine Umbenennung
Die ObjectStack-Dokumentation definiert das Artefakt in einem Satz: „Ein Import-Mapping ist eine benannte, wiederverwendbare Projektion von den Spalten einer Quelldatei auf die Felder eines Objekts.“ Es ist eine Metadaten-Art erster Klasse, wird also in einem Paket ausgeliefert oder zur Laufzeit gespeichert, und POST /api/v1/data/:object/import wendet es per Name an. Dies ist das Mapping, das die Messungen unten benutzt haben, im Quellcode der App neben den Objekten deklariert:
import { defineMapping } from '@objectstack/spec/data';

export const LeadFeedMapping = defineMapping({
  name: 'crm_lead_feed',
  label: 'Lead feed (legacy CRM export)',
  sourceFormat: 'csv',
  targetObject: 'crm_lead',
  fieldMapping: [
    { source: 'Full Name', target: 'name' },
    { source: 'E-mail', target: 'email' },
    { source: 'Company', target: 'company' },
    {
      source: 'Channel',
      target: 'source',
      transform: 'map',
      params: { valueMap: { Webform: 'web', 'Partner Referral': 'partner' } },
    },
  ],
  mode: 'upsert',
  upsertKey: ['email'],
});
Es wird mit mappings: [LeadFeedMapping] am Stack registriert, und defineStack() validiert es beim Build statt bei der ersten Verwendung: Ein targetObject, das der Stack nicht definiert, lässt den Build fehlschlagen, ebenso ein javascript-Transform (dazu unten mehr). Weil defineMapping() die Konfiguration beim Import parst, wird ein falsch geschriebener Schlüssel dort abgelehnt, wo Sie ihn geschrieben haben, mit der kanonischen Schreibweise in der Fehlermeldung. Das macht das Mapping zu typisierten Metadaten statt zu einer Konfigurationsdatei: Ein Reviewer liest zwanzig Zeilen und weiß, dass die Projektion wohlgeformt ist, bevor eine Zeile gelesen wird.
| Schlüssel | Was er entscheidet |
|---|---|
fieldMapping[] | Ein Eintrag pro Zielfeld: welche Quellspalte es speist, und durch welchen Transform |
transform: 'map' + valueMap | Übersetzt die Codes des Quellsystems in Ihre. Ein Wert ohne Eintrag in der Tabelle geht unverändert durch |
mode | Liefert den writeMode der Anfrage, wenn die Anfrage ihn weglässt: insert, update oder upsert |
upsertKey | Liefert die matchFields der Anfrage: die Felder, die entscheiden, ob eine Zeile „dieselbe Zeile“ wie ein gespeicherter Datensatz ist |
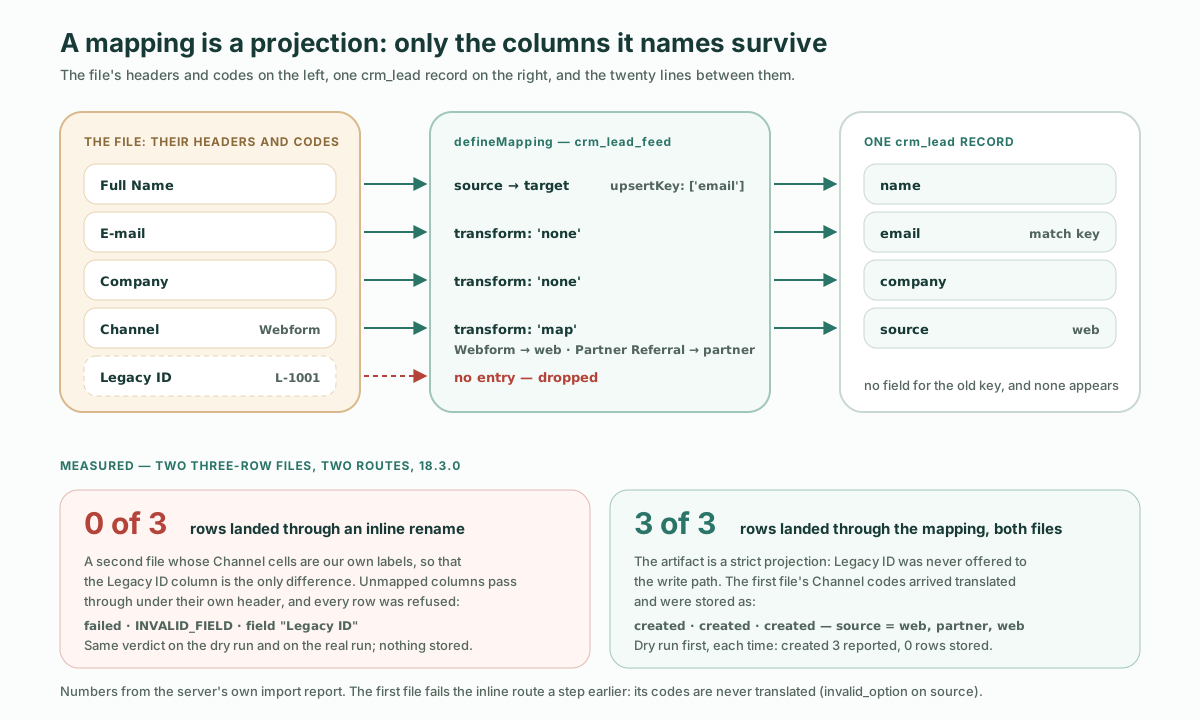
Das Wort, auf das es in der Definition ankommt, ist Projektion. Der Import-Endpunkt akzeptiert zwei Mapping-Mechanismen, und sie unterscheiden sich genau beim dritten Problem oben. Ein Inline-mapping in der Anfrage ist eine Umbenennung: Seine Array-Form kann eine Zelle trimmen, ihre Groß- und Kleinschreibung ändern oder eine leere füllen, hat aber keine Code-Tabelle, und Spalten, die es nicht benennt, „gehen unter ihrem eigenen Spaltenkopf an den Schreibpfad durch“. Ein benanntes Mapping ist das Gegenteil: Nicht gemappte Spalten werden „verworfen. Das Artefakt ist eine strikte Projektion: Nur gemappte Ziele überleben.“
Dieser Unterschied ist messbar, also wurde er gemessen, an einer zweiten dreizeiligen Datei, die so gebaut ist, dass die überflüssige Spalte das Einzige ist, worin sich die beiden Wege unterscheiden können: Ihre Channel-Zellen tragen unsere eigenen Optionsbeschriftungen (Website, Partner), die ohne Mapping aufgelöst werden, und sie führt die Spalte Legacy ID mit. Sie wurde mit einer Inline-Umbenennung der vier bekannten Spalten gesendet, als Dry Run und als echter Lauf, und mit mappingName: "crm_lead_feed" als Dry Run:
| Weg | Gelandete Zeilen | Was der Bericht zu jeder Zeile sagte |
|---|---|---|
Inline-mapping, Dry Run | 0 von 3 | failed, code: "INVALID_FIELD", field: "Legacy ID", “Unknown field ‘Legacy ID’ on object ‘crm_lead’” |
Inline-mapping, echter Lauf | 0 von 3 | Dieselben drei Urteile; nichts gespeichert |
mappingName, Dry Run | 3 von 3 | created |
Der Inline-Weg ist nicht kaputt. Er hat getan, was eine Umbenennung tut: Er hat Legacy ID unter dem eigenen Spaltenkopf durchgereicht, und der Schreibpfad hat ein Feld abgelehnt, das das Objekt nicht deklariert. Das Mapping hat die Spalte nie in die Nähe des Schreibpfads gelassen. Die erste Datei, mit ihren Codes Webform und Partner Referral, scheitert auf dem Inline-Weg einen Schritt früher: Jede Zeile wird mit invalid_option auf source abgelehnt, “Lead Source: ”Webform“ is not a known option”, weil nichts die Codes übersetzt hat. Für eine Datei, die jede Woche aus einem System kommt, das Sie nicht kontrollieren, sind diese beiden Garantien der Grund, die zwanzig Zeilen zu schreiben.
Das Mapping lässt sich auch zur Laufzeit speichern statt im Paket ausgeliefert zu werden: PUT /api/v1/meta/mapping/crm_lead_feed_saved mit derselben Form unter neuem Namen antwortete mit Saved mapping 'crm_lead_feed_saved' (env-wide, state=active) [seq=1], und ein Dry Run, der diesen Namen nannte, meldete created 3. So oder so löst die Import-Anfrage ein Mapping über seinen Namen auf; die Runtime liest gespeicherte Mappings zuerst und fällt auf das paketierte zurück. Der paketierte Name selbst ist gesperrt: dasselbe PUT an crm_lead_feed wurde mit 403 NOT_OVERRIDABLE abgelehnt.
Der Dry Run ist das Review
Die Anfrage, die das Mapping lohnend macht, ist kurz, weil das Artefakt den Schreibmodus und die Match-Felder liefert:
POST /api/v1/data/crm_lead/import
{
  "format": "csv",
  "csv": "Full Name,E-mail,Company,Channel,Legacy ID\nAda Lovelace,...",
  "mappingName": "crm_lead_feed",
  "dryRun": true
}
Der Dry Run kam mit dem ganzen Bericht zurück, Gesamtzähler plus ein Urteil pro Zeile:
{ "object": "crm_lead", "dryRun": true, "writeMode": "upsert",
  "total": 3, "ok": 3, "errors": 0, "created": 3, "updated": 0, "skipped": 0,
  "results": [
    { "row": 1, "ok": true, "action": "created" },
    { "row": 2, "ok": true, "action": "created" },
    { "row": 3, "ok": true, "action": "created" } ] }
Dann wurde die Tabelle gelesen: "total": 0. Nichts war gespeichert. Derselbe Body ohne dryRun antwortete mit "created": 3 und einer id auf jeder Zeile, und die Tabelle las "total": 3, wobei source die übersetzten Codes web, partner und web hielt statt der aus der Datei. Dieselbe Datei ein drittes Mal gesendet antwortete mit "created": 0, "updated": 3, und die Tabelle las weiterhin 3. Das ist das ganze Vorher-nachher, in drei Zahlen:
| Schritt | Bericht | Zeilen in der Tabelle danach |
|---|---|---|
| Dry Run | total 3 · created 3 · updated 0 | 0 |
| Echter Lauf | created 3 | 3 |
| Dieselbe Datei erneut | created 0 · updated 3 | 3 |
Warum das Review nennen und nicht Vorschau? Weil es das Artefakt ist, das ein Reviewer tatsächlich freigeben kann. Die Dokumentation sagt es präzise: "dryRun": true liefert „denselben Bericht, ohne etwas zu persistieren; das Urteil kommt aus der Schreibpfad-Validierung der Engine selbst“. Es ist keine Vermutung darüber, was der Schreibvorgang tun würde; für jede Zeile fragt es den Schreibpfad nach seinem Urteil und hält vor dem Persistieren an. Was eine Fachverantwortliche also freigibt, bevor der Montagsimport läuft, sind zwei kleine Dinge: das Mapping (zwanzig Zeilen typisierter Metadaten, in der Versionskontrolle, als Diff lesbar) und der Dry-Run-Bericht (wie viele Zeilen erstellt, wie viele aktualisiert werden, welche fehlschlagen und in welcher Spalte). Beim Unterschreiben ist noch nichts passiert, und der zweite Lauf ist der Beweis, dass der erste meinte, was er sagte.
Die Vorschau gilt auch für Zeilen, die sie aktualisieren wird. Noch einmal gesendet, nachdem die drei Zeilen existierten, antwortete der Dry Run mit created 0 · updated 3, demselben Urteil, das der echte Lauf danach lieferte. Ein Update wird gegen den gespeicherten Datensatz geprüft, zusammengeführt mit den Zellen der Datei, sodass eine Regel, die ein Feld liest, das die Datei nicht mitbringt, etwa die Prüfung lead_score_range des Lead-Objekts auf lead_score, den Datensatz beurteilt, den der Schreibvorgang tatsächlich speichern würde. Vor 18.0 beurteilte die Vorschau nur die eingehenden Zellen und konnte eine Zeile ablehnen, die der Schreibvorgang dann annahm. Eine Zeile, die der Schreibvorgang trotz eines nur beratenden Befunds zulassen würde, kommt mit ok und einer angehängten warnings-Liste zurück, sodass die Beanstandung im Bericht sichtbar ist statt stumm; keiner der Läufe hier hat eine erzeugt.
Die drei Arten, wie eine Zeile nicht matcht
upsertKey: ['email'] sagt, was „dieselbe Zeile“ bedeutet. Interessant sind die Zeilen, bei denen diese Suche nicht genau einen Datensatz findet. Die Dokumentation ist da deutlich: „Eine Zeile, die nicht matcht“ ist nicht ein Verhalten, sondern drei, gewählt durch writeMode und durch die Zahl der gefundenen Datensätze.
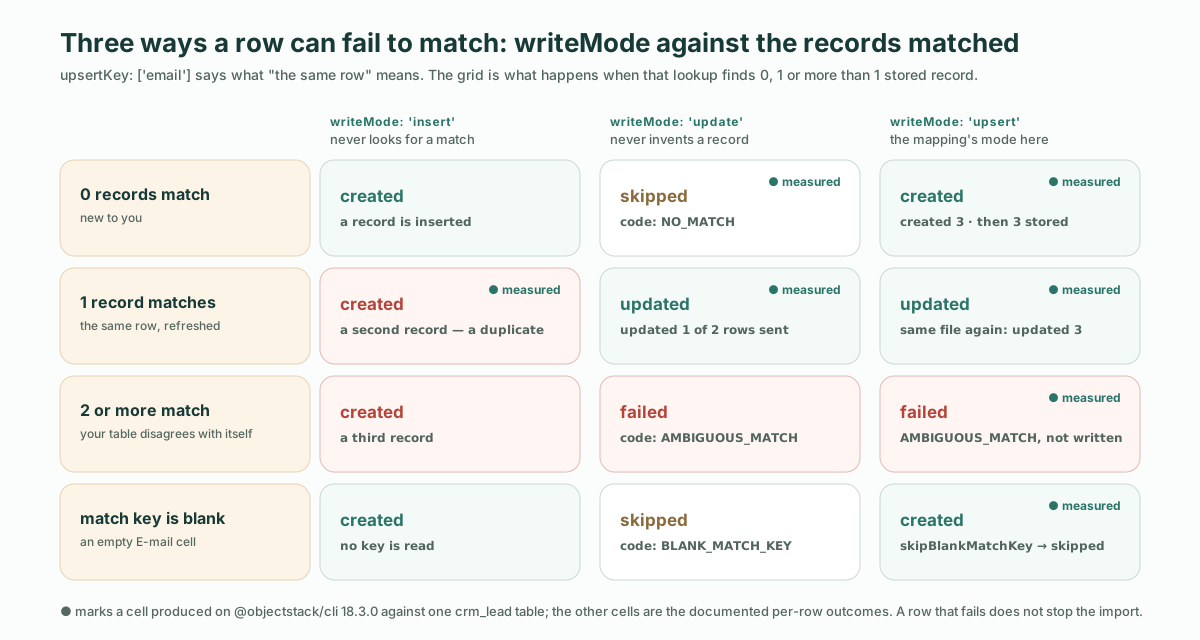
Alle drei wurden gegen dieselbe Tabelle erzeugt, und jede ist eine andere Art von Antwort:
| Gefundene Zeilen | writeMode: 'upsert' | writeMode: 'update' | Was es für die Datei bedeutet |
|---|---|---|---|
| 0 | created | skipped, code: "NO_MATCH" | Neu für Sie. Upsert lässt sie zu; update weigert sich, einen Datensatz zu erfinden |
| 1 | updated | updated | Dieselbe Zeile, aufgefrischt |
| 2 oder mehr | failed, code: "AMBIGUOUS_MATCH" | failed, code: "AMBIGUOUS_MATCH" | Ihre Tabelle widerspricht sich bereits selbst; für diese Zeile wird nichts geschrieben |
Die gemessenen Läufe: Eine zweizeilige Datei mit writeMode: "update" antwortete mit updated 1, skipped 1, wobei die Zeile der unbekannten Person "action": "skipped", "code": "NO_MATCH" las. Dann wurde eine Zeile zweimal mit writeMode: "insert" geladen, das nie nach einem Treffer sucht, sodass die Tabelle zwei Datensätze mit derselben E-Mail hielt, und dieselbe Zeile als Upsert gesendet antwortete mit "action": "failed", "code": "AMBIGUOUS_MATCH" und der Meldung “matchFields matched more than one crm_lead record”. Das Duplikat ist eine Tatsache über die Tabelle, und der Import meldet sie, statt einen auszuwählen.
Es gibt eine vierte Zeile, die man kennen sollte: die, deren Match-Feld leer ist. Eine Zeile mit leerer E-mail-Zelle wurde vom Upsert erstellt, weil Upsert eine solche Zeile standardmäßig erstellt; mit "skipBlankMatchKey": true in der Anfrage kam dieselbe Zeile als "action": "skipped", "code": "BLANK_MATCH_KEY" zurück. Welches der beiden Sie wollen, hängt davon ab, ob ein Lead ohne E-Mail ein Lead oder ein Tippfehler ist, und das ist eine Entscheidung, die die Anfrage trägt, nicht das Mapping.
Mit 18.2 kam ein weiterer Fall hinzu: eine Datei, die sich selbst widerspricht. Tragen zwei Zeilen eines Upserts oder Updates denselben Match-Schlüssel, wird keine von beiden geschrieben, im Dry Run wie im echten Lauf. Eine dreizeilige Datei, die [email protected] zweimal enthielt, antwortete mit ok 1 · errors 2; die dritte Zeile wurde erstellt, und beide Duplikate kamen als "action": "failed", "code": "DUPLICATE_MATCH_KEY" mit dieser Meldung zurück:
Rows 1, 2 of this import have the same match key (email), so none of them was written: keep one row per key and import againDie Korrektur gehört in die Datei: die richtige Zeile behalten und die Datei erneut senden.
Nach dem Mapping muss die Zelle immer noch zulässig sein
Das Mapping entscheidet, welcher Wert in welchem Feld landet. Diesen Wert in etwas zu verwandeln, das der Speicher akzeptiert, ist ein eigener Schritt, der danach aus den Feldmetadaten des Zielobjekts läuft, und die beiden Schritte scheitern unterschiedlich. Eine vierzeilige Datei hat sie in einer Anfrage durchgespielt:
| Die Zelle | Was passierte | Das Urteil der Zeile |
|---|---|---|
Channel = Trade Show, ein Code, den die valueMap nicht kennt | Das map ließ ihn wie dokumentiert unverändert durch; die Auswahlfeld-Umwandlung fand dann keine Option namens Trade Show | failed, field: "source", code: "invalid_option", “Lead Source: ”Trade Show“ is not a known option” |
Channel = Event, nicht in der valueMap, aber die Beschriftung einer existierenden Option | Unverändert durchgelassen; per Beschriftung zum gespeicherten Wert event aufgelöst, ohne Mapping-Eintrag | created |
E-mail = not-an-email | Die Umwandlung des E-Mail-Feldes selbst lehnte sie ab | failed, field: "email", code: "invalid_email" |
E-mail leer | Vom Upsert zugelassen, wie oben | created |
Zwei der vier Zeilen landeten, zwei nicht, und der Bericht las "ok": 2, "errors": 2. Eine Zeile, die fehlschlägt, stoppt den Import nicht; sie bekommt ihre eigene Zeile mit der betroffenen Spalte beim Namen, und das ist die Zeile, die jemand vor dem nächsten Montag in der Tabelle korrigiert.
Der zweite Fall verdient einen Satz, weil er abgrenzt, wofür map da ist. Beschriftungen von Auswahlfeldern lösen sich bereits ohne Mapping zu gespeicherten Werten auf, in der Sprache der App und in ihren Übersetzungen. Die valueMap ist also nicht dazu da, dem Import Ihre Optionsbeschriftungen beizubringen; sie ist für die Codes des anderen Systems, die Schreibweisen, die weder Ihre Werte noch Ihre Beschriftungen sind. Webform braucht das map. Event hat es nie gebraucht.
Abgelehnt, bevor eine Zeile gelesen wird
Manche Anfragen werden als Ganzes abgelehnt, ohne Zeilenbericht, weil eine zeilenweise Antwort einen Fehler in der Anfrage selbst verbergen würde. Drei davon wurden gemessen; der Rest stammt aus der dokumentierten Tabelle.
| Status | code | Ursache |
|---|---|---|
| 404 | MAPPING_NOT_FOUND | Kein Mapping unter diesem Namen registriert. Gemessen: “No mapping artifact named ”crm_lead_feed_nope“ is registered” |
| 400 | CONFLICTING_MAPPING | Sowohl mappingName als auch ein Inline-mapping in einer Anfrage. Gemessen: “Provide either mappingName or an inline mapping, not both” |
| 400 | MAPPING_TARGET_MISMATCH | Das targetObject des Artefakts ist nicht das Objekt in der URL |
| 400 | UNSUPPORTED_TRANSFORM | Ein Eintrag deklariert javascript oder einen Transform, den die Pipeline nicht implementiert |
| 413 | PAYLOAD_TOO_LARGE | Mehr als 5.000 Zeilen auf dem synchronen Weg |
Die Obergrenze ist exakt. Eine Datei mit 5.001 Zeilen wurde abgelehnt mit “Import limit is 5000 rows per request (got 5001). Use an async import job for larger files.” Eine Datei mit 5.000 Zeilen kam als Dry Run in einer Antwort mit "total": 5000, "ok": 5000, "created": 5000 zurück. Darüber parst POST /api/v1/data/:object/import/jobs denselben Body und nimmt bis zu 50.000 Zeilen, mit einer Job-ID zum Abfragen; dieser Weg wurde hier nicht ausgeführt.
Was das nicht löst
Eigener Code im Mapping. TransformType deklariert sieben Werte: none, constant, map, split, join, lookup und javascript. Die ersten fünf laufen Zeile für Zeile, lookup ist ein bewusster Durchlass an die Referenzauflösung des Imports selbst, und javascript wird abgelehnt, weil „es keine serverseitige Sandbox gibt und das stille Überspringen eines deklarierten Transforms Daten beschädigen würde“. Beide Hälften dieser Ablehnung wurden auf 18.3.0 gemessen. Einen Eintrag des paketierten Mappings auf transform: 'javascript' zu ändern ließ objectstack build fehlschlagen mit “Mapping ‘crm_lead_feed’ uses transform ‘javascript’, which the import path does not execute (no server-side sandbox). Use none/constant/map/split/join/lookup, or model the logic as a flow.” Dasselbe zur Laufzeit über PUT /api/v1/meta/mapping/... zu speichern wurde akzeptiert, und der erste Import, der es benannte, wurde mit 400 UNSUPPORTED_TRANSFORM abgelehnt. Für Logik jenseits der fünf Transforms lautet die Antwort der Dokumentation, die Daten vor dem Senden zu transformieren oder sie als Flow auf dem Zielobjekt zu modellieren. Das ist auch für einen Reviewer die richtige Grenze: Ein Mapping, das man ganz lesen kann, ist ein Mapping, das man freigeben kann.
Entscheiden, was die alte Spalte bedeutete. Das Mapping hält die Entscheidung fest, dass Partner Referral partner bedeutet. Es trifft sie nicht. Jemand, der beide Systeme kennt, muss nach wie vor sagen, welcher der sechs source-Werte ein Trade Show-Lead ist und ob ein Lead ohne E-Mail ein Lead ist.
Der Import-Assistent, Automatisierungen und der asynchrone Weg. Der Assistent, der aus den Spaltenentscheidungen eines Nutzers ein Mapping speichert, ist eine Produktoberfläche, die dieser Beitrag nicht abdeckt; alles hier blieb auf dem REST-Weg, den ein Agent oder ein Skript benutzen würde. Die Anfrage akzeptiert einen Schlüssel runAutomations; was die Zeilen auf dem Weg hinein auslösen, ist ein eigenes Thema. Und der Job-Weg für 50.000 Zeilen wurde benannt, nicht ausgeführt.
Wo das in einer Migration steht
Das ist der Ladeschritt, und er ist absichtlich klein. Wenn die Frage lautet, ob das Altsystem überhaupt migriert werden soll, ist der stufenweise Weg weg von einem internen Altsystem die Strategie: nur lesend anbinden, die deklarierten Regeln an der Historie messen, Schreibzugriffe Objekt für Objekt freischalten. Wenn das Altsystem bleibt und Sie KI auf seinen Daten wollen, ohne etwas zu bewegen, ist das Anbinden der Datenbank, die Sie bereits betreiben der Mechanismus, und die Fertigungsvariante zeigt, wo man anfängt, wenn das System ein ERP ist. Import-Mappings sind für den Fall dazwischen: Das System geht weg, oder es hatte nie eine API, und was Sie haben, ist eine Datei.
Gehostet oder auf Ihrer eigenen Infrastruktur
Alles oben lief auf der Open-Source-Runtime, die ein Gerüst installiert. ObjectOS gibt es in drei Editionen: ObjectOS Community, quelloffen und kostenlos selbst gehostet; ObjectOS Cloud, gehostet im Browser ohne Installation; und ObjectOS Enterprise, selbst verwaltet auf Ihrer eigenen Infrastruktur. Ihre Ontologie besteht aus gewöhnlichen ObjectStack-Metadaten. Der Export aus ObjectOS Cloud oder ObjectOS Enterprise zur Ausführung auf der quelloffenen ObjectStack Runtime ist geplant. Das Mapping ist Teil dieser Ontologie: Es reist mit dem Paket.
Mit dem Agentenpfad beginnen
npm create objectstack@latest crm && cd crmGeben Sie dann Ihrem Coding-Agenten die Datei und die Dokumentationsseite zu Import-Mappings (objectstack.ai/docs/data-modeling/import-mappings) und verlangen Sie drei Dinge: das Objekt, zu dem die Zeilen gehören, ein defineMapping, dessen valueMap jeden Code übersetzt, den die Datei verwendet, und einen Dry Run der echten Datei. Was zurückkommt, ist das Review: ein Mapping, das kurz genug ist, um es in einem Zug zu lesen, und ein Bericht, der sagt, wie viele Zeilen erstellt, wie viele aktualisiert werden und welche Zellen jemand korrigieren muss. Geben Sie das frei und starten Sie den Import. Dann starten Sie ihn nächsten Montag erneut und lesen updated, wo Sie es erwarten.