옛 시스템의 스프레드시트를 AI가 만든 앱으로 어떻게 가져오나? 임포트 매핑, 드라이 런, 그리고 한 행이 매칭되지 않는 세 가지 결말
ObjectStack 18.3.0에서 측정: 이름 붙은 임포트 매핑이 낯선 헤더와 코드를 한 객체의 필드로 투영하고, 드라이 런은 아무것도 저장하지 않은 채 행별 전체 보고서를 돌려주며, 매칭되지 않는 행은 생성되거나 건너뛰거나 실패한다.
짧은 결론. 옛 시스템에서 온 스프레드시트는 헤더가 당신의 필드 이름이 아니고, 코드도 당신의 코드가 아니다. 해법은 임포트 매핑이다. 파일의 열에서 한 객체의 필드로 가는, 이름과 버전이 있는 투영으로, map이 상대 시스템의 코드를 번역하고 upsertKey가 “같은 행”이 무엇인지 정한다. 매핑은 엄격해서, 매핑이 이름 짓지 않은 열은 쓰기 경로에 결코 닿지 않는다. dryRun: true는 아무것도 저장하지 않고 행별 전체 보고서를 돌려준다. 공개된 @objectstack/cli 18.3.0에서 측정한 결과: 3행짜리 CSV는 테이블이 아직 0행인 상태에서 드라이 런으로부터 created: 3을 돌려받았고, 실제 실행 뒤 테이블은 3행이 되었으며, 같은 파일을 다시 보내자 updated: 3이라고 답했다. 드라이 런이 곧 리뷰다: 무엇이든 착지하기 전에 당신이 서명하는 전후 개수다.
아래의 모든 것은 설명한 것이 아니라 실행한 것이다. 앱은 18.3.0에서 npm create objectstack@latest로 만든 새 스캐폴드에 ObjectStack 저장소에 함께 실린 CRM 예제의 Lead 객체를 얹은 것이고, 모든 개수는 서버 자신의 보고서에서 인용했다.
매주 월요일에 도착하는 파일
파일은 이렇다. 전체가 한 페이지에 들어가도록 세 행으로 했고, 삼천 행이어도 메커니즘은 같다.
Full Name,E-mail,Company,Channel,Legacy ID
Ada Lovelace,[email protected],Analytical Engines,Webform,L-1001
Alan Turing,[email protected],NPL,Partner Referral,L-1002
Grace Hopper,[email protected],Eckert-Mauchly,Webform,L-1003
그리고 이것이 파일이 착지해야 할 객체다. CRM 예제의 crm_lead는 name, email, company, 그리고 저장값이 web, referral, event, social, cold_outreach, partner인 선택 필드 source를 선언한다.
이 파일에는 세 가지가 잘못되어 있고, 그것은 다른 시스템에서 온 모든 내보내기가 틀리는 바로 그 세 가지다.
- 헤더가 그쪽 것이다.
Full Name은 우리의name이고,E-mail은 우리의email이다. - 코드가 그쪽 것이다. 그쪽의
Webform은 우리의web이고, 그쪽의Partner Referral은 우리의partner다. 두 철자 모두 우리 쪽에는 없다. - 착지해서는 안 되는 열이 있다.
Legacy ID는 옛 시스템의 기본 키다. 여기에는 해당 필드가 없고, 실수로 생겨서도 안 된다.
임포트 마법사의 일회성 이름 바꾸기는 첫 번째 문제만 해결하고 나머지는 아무것도 하지 않는다. 나머지 둘에는 한 번 적어 두고 매주 적용되는 무언가가 필요하다.
임포트 매핑은 이름 바꾸기가 아니라 투영이다
ObjectStack 문서는 이 산출물을 한 문장으로 정의한다. “임포트 매핑은 원본 파일의 열에서 한 객체의 필드로 가는, 이름 붙은 재사용 가능한 투영이다.” 일급 메타데이터 종류이므로 패키지 안에 실려 오거나 런타임에 저장되며, POST /api/v1/data/:object/import가 이름으로 적용한다. 아래 측정에 쓴 것이 이것이며, 앱 소스에 객체들과 나란히 선언되어 있다.
import { defineMapping } from '@objectstack/spec/data';

export const LeadFeedMapping = defineMapping({
  name: 'crm_lead_feed',
  label: 'Lead feed (legacy CRM export)',
  sourceFormat: 'csv',
  targetObject: 'crm_lead',
  fieldMapping: [
    { source: 'Full Name', target: 'name' },
    { source: 'E-mail', target: 'email' },
    { source: 'Company', target: 'company' },
    {
      source: 'Channel',
      target: 'source',
      transform: 'map',
      params: { valueMap: { Webform: 'web', 'Partner Referral': 'partner' } },
    },
  ],
  mode: 'upsert',
  upsertKey: ['email'],
});
이것은 mappings: [LeadFeedMapping]으로 스택에 등록되고, defineStack()은 첫 사용 시점이 아니라 빌드할 때 검증한다. 스택이 정의하지 않은 targetObject는 빌드를 실패시키고, javascript 변환도 마찬가지다(아래에서 다룬다). defineMapping()은 임포트 시점에 설정을 파싱하므로, 철자가 틀린 키는 당신이 그것을 쓴 그 자리에서 정규 철자를 오류에 명시한 채 거부된다. 이것이 매핑을 설정 파일이 아니라 타입이 있는 메타데이터로 만드는 이유다. 검토자는 스무 줄을 읽고, 어떤 행도 읽히기 전에 이 투영이 올바른 형태임을 안다.
| 키 | 무엇을 정하는가 |
|---|---|
fieldMapping[] | 대상 필드마다 한 항목: 어떤 원본 열이 공급하고, 어떤 변환을 거치는가 |
transform: 'map' + valueMap | 원본 시스템의 코드를 당신의 코드로 번역한다. 표에 항목이 없는 값은 그대로 통과한다 |
mode | 요청이 writeMode를 생략하면 대신 채운다: insert, update 또는 upsert |
upsertKey | 요청이 matchFields를 생략하면 대신 채운다: 한 행이 저장된 레코드와 “같은 행”인지 정하는 필드들 |
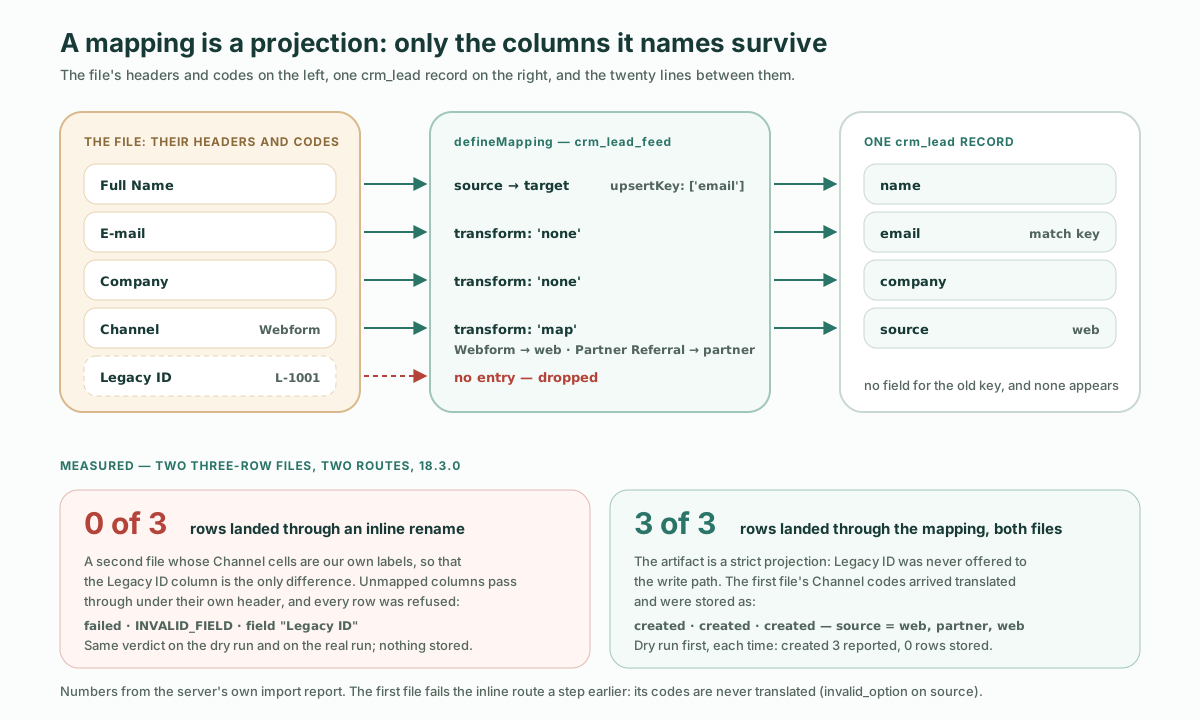
정의에서 중요한 낱말은 투영이다. 임포트 엔드포인트는 두 가지 매핑 메커니즘을 받아들이는데, 둘은 정확히 위의 세 번째 문제에서 갈린다. 요청에 실린 인라인 mapping은 이름 바꾸기다. 그 배열 형식은 셀을 다듬거나 대소문자를 바꾸거나 빈 셀을 채울 수는 있지만 코드표는 없고, 그것이 이름 짓지 않은 열은 “자기 헤더를 단 채 쓰기 경로로 통과한다”. 이름 붙은 매핑은 그 반대다. 매핑되지 않은 열은 “버려진다. 산출물은 엄격한 투영이며, 매핑된 대상만 살아남는다.”
그 차이는 측정할 수 있으므로 측정했다. 쓴 것은 두 번째 3행짜리 파일로, 군더더기 열이 두 경로가 갈릴 수 있는 유일한 지점이 되도록 만들었다. Channel 칸에는 매핑 없이도 해석되는 우리 자신의 옵션 레이블(Website, Partner)이 들어 있고, Legacy ID 열을 싣고 있다. 이것을 알려진 네 열의 인라인 이름 바꾸기로 드라이 런과 실제 실행을 한 번씩, mappingName: "crm_lead_feed"로 드라이 런을 한 번 보냈다.
| 경로 | 착지한 행 | 보고서가 각 행에 대해 말한 것 |
|---|---|---|
인라인 mapping, 드라이 런 | 3행 중 0행 | failed, code: "INVALID_FIELD", field: "Legacy ID", “Unknown field ‘Legacy ID’ on object ‘crm_lead’” |
인라인 mapping, 실제 실행 | 3행 중 0행 | 같은 세 판정. 아무것도 저장되지 않음 |
mappingName, 드라이 런 | 3행 중 3행 | created |
인라인 경로가 고장 난 것은 아니다. 이름 바꾸기가 하는 일을 했을 뿐이다. Legacy ID를 자기 헤더를 단 채 통과시켰고, 쓰기 경로는 객체가 선언하지 않은 필드를 거부했다. 매핑은 그 열을 쓰기 경로 근처에도 보내지 않았다. Webform과 Partner Referral 코드를 실은 첫 번째 파일은 인라인 경로에서 한 단계 앞서 실패한다. 모든 행이 source의 invalid_option으로 거부되며, “Lead Source: ”Webform“ is not a known option”이다. 코드를 번역하는 것이 아무것도 없기 때문이다. 당신이 통제하지 못하는 시스템에서 매주 오는 파일에게, 그 두 가지 보장이야말로 스무 줄을 쓰는 이유다.
매핑은 패키지에 실어 보내는 대신 런타임에 저장할 수도 있다. 같은 형태를 새 이름으로 PUT /api/v1/meta/mapping/crm_lead_feed_saved에 보내자 Saved mapping 'crm_lead_feed_saved' (env-wide, state=active) [seq=1]라고 답했고, 그 이름을 지정한 드라이 런은 created 3을 보고했다. 어느 쪽이든 임포트 요청은 매핑을 이름으로 찾는다. 런타임은 저장된 매핑을 먼저 읽고 패키지에 실린 것으로 되돌아간다. 패키지 쪽 이름 자체는 잠겨 있다. 같은 PUT을 crm_lead_feed에 보내자 403 NOT_OVERRIDABLE로 거부되었다.
드라이 런이 곧 리뷰다
매핑을 가질 가치가 있게 만드는 요청은 짧다. 쓰기 모드와 매칭 필드를 산출물이 공급하기 때문이다.
POST /api/v1/data/crm_lead/import
{
  "format": "csv",
  "csv": "Full Name,E-mail,Company,Channel,Legacy ID\nAda Lovelace,...",
  "mappingName": "crm_lead_feed",
  "dryRun": true
}
드라이 런은 집계 카운터에 행마다 하나의 판정을 더한 전체 보고서를 돌려주었다.
{ "object": "crm_lead", "dryRun": true, "writeMode": "upsert",
  "total": 3, "ok": 3, "errors": 0, "created": 3, "updated": 0, "skipped": 0,
  "results": [
    { "row": 1, "ok": true, "action": "created" },
    { "row": 2, "ok": true, "action": "created" },
    { "row": 3, "ok": true, "action": "created" } ] }
그다음 테이블을 읽었다: "total": 0. 아무것도 저장되지 않았다. dryRun을 뺀 같은 본문은 모든 행에 id를 달아 "created": 3이라고 답했고, 테이블은 "total": 3을 읽었으며, source에는 파일의 코드가 아니라 번역된 web, partner, web이 들어 있었다. 같은 파일을 세 번째로 보내자 "created": 0, "updated": 3이라고 답했고, 테이블은 여전히 3이었다. 그것이 전후의 전부이며, 세 개의 숫자다.
| 단계 | 보고서 | 직후 테이블의 행 수 |
|---|---|---|
| 드라이 런 | total 3 · created 3 · updated 0 | 0 |
| 실제 실행 | created 3 | 3 |
| 같은 파일을 다시 | created 0 · updated 3 | 3 |
왜 미리보기가 아니라 리뷰라고 부르는가? 그것이 검토자가 실제로 서명할 수 있는 산출물이기 때문이다. 문서는 정확히 말한다. "dryRun": true는 “아무것도 영속화하지 않은 같은 보고서를 돌려주며, 판정은 엔진 자신의 쓰기 경로 검증에서 나온다”. 쓰기가 무엇을 할지에 대한 추측이 아니라, 행마다 쓰기 경로에 판정을 묻고 영속화 직전에 멈춘다. 그래서 월요일 임포트가 돌기 전에 업무 책임자가 승인하는 것은 두 개의 작은 물건이다. 매핑(버전 관리 안에 있고 diff로 읽을 수 있는 스무 줄의 타입 있는 메타데이터)과 드라이 런 보고서(몇 행이 생성되고, 몇 행이 갱신되며, 어떤 행이 어느 열에서 실패할지). 서명하는 시점에는 아직 아무 일도 일어나지 않았고, 두 번째 실행이 첫 번째가 말한 그대로였다는 증명이다.
이 미리보기는 갱신될 행에도 그대로 성립한다. 세 행이 존재한 뒤 한 번 더 보내자 드라이 런은 created 0 · updated 3을 답했고, 이어진 실제 실행도 같은 판정을 냈다. 갱신은 저장된 레코드에 파일의 셀을 병합한 것을 대상으로 미리보기되므로, Lead 객체의 lead_score_range 검사가 lead_score를 읽듯 파일에 없는 필드를 읽는 규칙도 쓰기가 실제로 저장할 레코드를 판정한다. 18.0 이전의 미리보기는 들어온 셀만으로 판정해, 쓰기가 받아들이는 행을 거부할 수 있었다. 권고 수준의 지적이 있어도 쓰기가 받아들일 행은 ok인 채로 warnings 목록을 달고 돌아오므로, 그 지적은 묻히지 않고 보고서에 보인다. 여기서의 실행에서는 한 번도 나오지 않았다.
한 행이 매칭되지 않는 세 가지 결말
upsertKey: ['email']가 “같은 행”의 뜻을 말한다. 흥미로운 경우는 그 조회가 정확히 하나의 레코드를 찾지 못하는 행들이다. 문서는 이에 대해 단도직입적이다. “매칭되지 않는 행”은 하나의 동작이 아니라 셋이며, writeMode와 몇 개의 레코드가 매칭되었는지에 따라 정해진다.
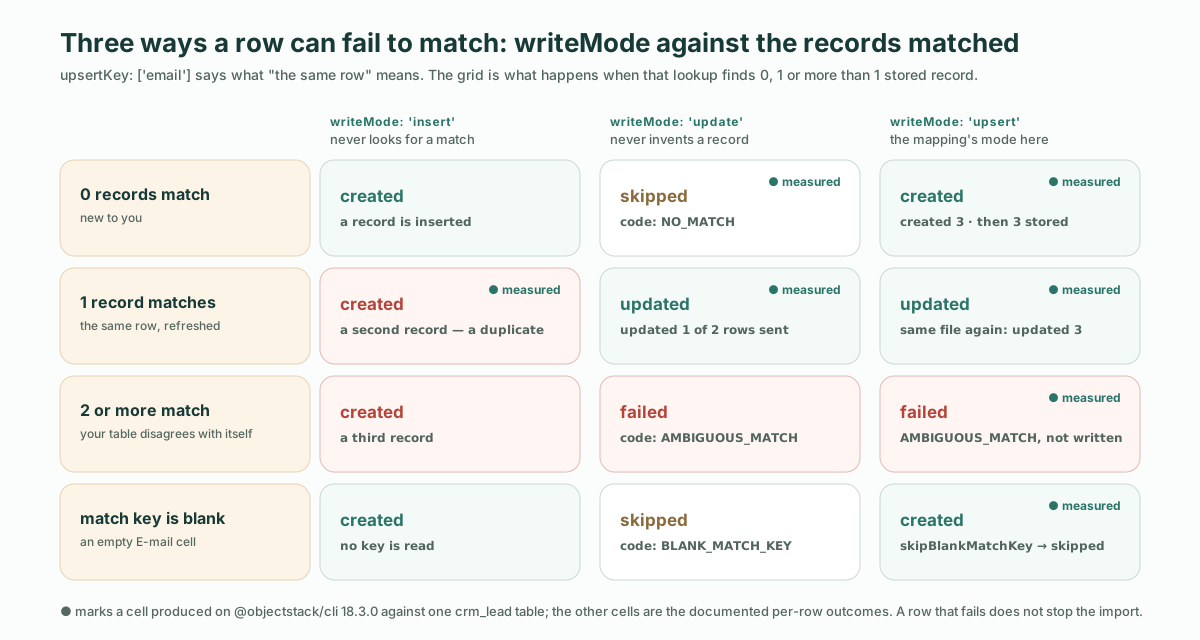
셋 모두 같은 테이블에 대해 만들어 냈고, 각각은 다른 종류의 답이다.
| 매칭된 행 수 | writeMode: 'upsert' | writeMode: 'update' | 파일에게 의미하는 것 |
|---|---|---|---|
| 0 | created | skipped, code: "NO_MATCH" | 당신에게 새로운 행. upsert는 받아들이고, update는 레코드를 지어내기를 거부한다 |
| 1 | updated | updated | 같은 행을 새로 고침 |
| 2 이상 | failed, code: "AMBIGUOUS_MATCH" | failed, code: "AMBIGUOUS_MATCH" | 테이블이 이미 스스로 모순된다. 그 행에는 아무것도 쓰지 않는다 |
측정한 실행: 두 행짜리 파일을 writeMode: "update"로 보내자 updated 1, skipped 1이라고 답했고, 모르는 사람의 행은 "action": "skipped", "code": "NO_MATCH"로 읽혔다. 그다음 한 행을 writeMode: "insert"로 두 번 적재했다. insert는 매칭을 찾지 않으므로 테이블에는 같은 이메일의 레코드가 둘 남았고, 같은 행을 upsert로 보내자 "action": "failed", "code": "AMBIGUOUS_MATCH", 메시지는 “matchFields matched more than one crm_lead record”였다. 중복은 테이블에 관한 사실이고, 임포트는 하나를 고르는 대신 그것을 보고한다.
알아둘 만한 네 번째 행이 있다. 매칭 필드가 비어 있는 행이다. E-mail 칸이 빈 행은 upsert에 의해 생성되었다. upsert는 기본적으로 그런 행을 만들기 때문이다. 요청에 "skipBlankMatchKey": true를 붙이자 같은 행이 "action": "skipped", "code": "BLANK_MATCH_KEY"로 돌아왔다. 둘 중 무엇을 원하는지는 이메일 없는 리드가 리드인지 오타인지에 달려 있고, 그것은 매핑이 아니라 요청이 싣고 가는 결정이다.
18.2에서 경우가 하나 더 생겼다. 파일이 스스로 모순되는 경우다. 한 번의 upsert나 update 안에서 두 행이 같은 매칭 키를 가지면 어느 쪽도 쓰이지 않으며, 드라이 런에서도 실제 실행에서도 같다. [email protected]을 두 번 담은 세 행짜리 파일은 ok 1 · errors 2를 답했다. 세 번째 행은 생성되었고, 중복된 두 행은 "action": "failed", "code": "DUPLICATE_MATCH_KEY"와 다음 메시지로 돌아왔다.
Rows 1, 2 of this import have the same match key (email), so none of them was written: keep one row per key and import again고칠 곳은 스프레드시트다. 맞는 행을 남기고 파일을 다시 보내면 된다.
매핑 뒤에도 셀은 여전히 합법이어야 한다
매핑은 어떤 값이 어떤 필드에 착지할지를 정한다. 그 값을 저장소가 받아들이는 것으로 바꾸는 일은 별개의 단계로, 매핑 뒤에 대상 객체 자신의 필드 메타데이터로부터 실행되며, 두 단계는 다르게 실패한다. 네 행짜리 파일이 한 요청 안에서 그것들을 모두 겪었다.
| 셀 | 일어난 일 | 행의 판정 |
|---|---|---|
Channel = Trade Show, valueMap이 모르는 코드 | map은 문서대로 그대로 통과시켰고, 선택 필드의 변환은 Trade Show라는 옵션을 찾지 못했다 | failed, field: "source", code: "invalid_option", “Lead Source: ”Trade Show“ is not a known option” |
Channel = Event, valueMap에는 없지만 기존 옵션의 레이블 | 그대로 통과했고, 레이블로 저장값 event로 해석되었다. 매핑 항목은 관여하지 않았다 | created |
E-mail = not-an-email | email 필드 자신의 변환이 거부했다 | failed, field: "email", code: "invalid_email" |
E-mail 비어 있음 | 위처럼 upsert가 받아들였다 | created |
네 행 중 둘이 착지하고 둘은 아니었으며, 보고서는 "ok": 2, "errors": 2로 읽혔다. 실패한 행은 임포트를 멈추지 않는다. 문제의 열을 이름 지은 자기 줄을 받으며, 그것이 다음 월요일 전에 누군가가 스프레드시트에서 고치는 줄이다.
두 번째 경우는 map이 무엇을 위한 것인지 경계를 긋기 때문에 한 문장 더 할 가치가 있다. 선택 레이블은 앱 자신의 언어로든 번역으로든, 어떤 매핑도 없이 이미 저장값으로 해석된다. 그러니 valueMap은 임포트에 당신의 옵션 레이블을 가르치기 위한 것이 아니다. 상대 시스템의 코드, 즉 당신의 값도 레이블도 아닌 철자를 위한 것이다. Webform에는 map이 필요하다. Event에는 애초에 필요 없었다.
어떤 행도 읽히기 전에 거부되는 것
어떤 요청은 행별 보고서 없이 통째로 거부되는데, 행마다 답하면 요청 자체의 실수가 가려지기 때문이다. 그중 셋을 측정했고, 나머지는 문서화된 표에서 왔다.
| 상태 | code | 원인 |
|---|---|---|
| 404 | MAPPING_NOT_FOUND | 그 이름으로 등록된 매핑이 없다. 측정: “No mapping artifact named ”crm_lead_feed_nope“ is registered” |
| 400 | CONFLICTING_MAPPING | 한 요청에 mappingName과 인라인 mapping이 모두 있다. 측정: “Provide either mappingName or an inline mapping, not both” |
| 400 | MAPPING_TARGET_MISMATCH | 산출물의 targetObject가 URL의 객체가 아니다 |
| 400 | UNSUPPORTED_TRANSFORM | 어떤 항목이 javascript를, 또는 파이프라인이 구현하지 않은 변환을 선언한다 |
| 413 | PAYLOAD_TOO_LARGE | 동기 경로에서 5,000행 초과 |
상한은 정확하다. 5,001행 파일은 “Import limit is 5000 rows per request (got 5001). Use an async import job for larger files.”로 거부되었다. 5,000행 파일은 드라이 런으로 한 번의 응답에 "total": 5000, "ok": 5000, "created": 5000을 돌려주었다. 그 위로는 POST /api/v1/data/:object/import/jobs가 동일한 본문을 파싱해 최대 50,000행을 받으며 폴링할 작업 id를 돌려준다. 그 경로는 여기서 실행하지 않았다.
이것이 해결하지 못하는 것
매핑 안의 커스텀 코드. TransformType은 일곱 값을 선언한다: none, constant, map, split, join, lookup, javascript. 앞의 다섯은 행마다 실행되고, lookup은 임포트 자신의 참조 해석으로 넘기는 의도된 통과이며, javascript는 거부된다. “서버 쪽 샌드박스가 없고, 선언된 변환을 조용히 건너뛰면 데이터가 손상되기” 때문이다. 이 거부의 양쪽 절반을 18.3.0에서 측정했다. 패키지에 실린 매핑의 한 항목을 transform: 'javascript'로 바꾸자 objectstack build는 “Mapping ‘crm_lead_feed’ uses transform ‘javascript’, which the import path does not execute (no server-side sandbox). Use none/constant/map/split/join/lookup, or model the logic as a flow.”로 실패했다. 같은 것을 PUT /api/v1/meta/mapping/...으로 런타임에 저장하자 저장은 받아들여졌고, 그것을 이름 지어 부른 첫 임포트는 400 UNSUPPORTED_TRANSFORM으로 거부되었다. 다섯 변환을 넘는 로직에 대한 문서의 답은, 보내기 전에 데이터를 변환하거나 대상 객체의 flow로 모델링하라는 것이다. 검토자에게도 그것이 올바른 한계다. 통째로 읽을 수 있는 매핑이 승인할 수 있는 매핑이다.
옛 열이 무엇을 뜻했는지 정하기. 매핑은 Partner Referral이 partner를 뜻한다는 결정을 기록한다. 결정을 내리지는 않는다. 두 시스템을 모두 아는 누군가가 여전히 Trade Show 리드가 여섯 source 값 중 무엇인지, 이메일 없는 리드가 리드인지 말해야 한다.
임포트 마법사, 자동화, 비동기 경로. 사용자가 고른 열로부터 매핑을 저장하는 마법사는 이 글이 다루지 않는 제품 화면이다. 여기의 모든 것은 에이전트나 스크립트가 쓸 REST 경로에 머물렀다. 요청은 runAutomations 키를 받는다. 행이 들어오는 길에 무엇을 트리거하는지는 별개의 주제다. 그리고 50,000행 작업 경로는 이름만 불렀을 뿐 실행하지 않았다.
마이그레이션 안에서 이 글의 자리
이것은 적재 단계이고, 일부러 작다. 옛 시스템을 옮겨야 하는지 자체가 질문이라면, 레거시 내부 시스템에서 단계적으로 벗어나는 길이 전략이다. 읽기 전용으로 연결하고, 선언한 규칙을 이력에 대조해 측정하고, 객체 하나씩 쓰기를 켠다. 옛 시스템이 남고 아무것도 옮기지 않은 채 그 데이터 위에 AI를 올리고 싶다면, 이미 운영 중인 데이터베이스 연결하기가 메커니즘이고, 제조업 버전은 시스템이 ERP일 때 어디서 시작할지 보여준다. 임포트 매핑은 그 사이의 경우를 위한 것이다. 시스템이 사라지거나, 애초에 API가 없었고, 당신 손에 있는 것이 파일뿐일 때.
호스팅으로, 또는 자체 인프라에서
위의 모든 것은 스캐폴드가 설치하는 오픈소스 런타임에서 실행되었다. ObjectOS는 세 가지 에디션으로 제공됩니다. 오픈소스이며 무료로 직접 호스팅하는 ObjectOS Community, 설치 없이 브라우저에서 호스팅되는 ObjectOS Cloud, 자체 인프라에서 직접 운영하는 ObjectOS Enterprise입니다. 온톨로지는 일반적인 ObjectStack 메타데이터입니다. ObjectOS Cloud 또는 ObjectOS Enterprise에서 내보내 오픈소스 ObjectStack 런타임에서 실행하는 기능은 계획 중입니다. 매핑은 그 온톨로지의 일부다. 패키지와 함께 이동한다.
에이전트 경로로 시작하기
npm create objectstack@latest crm && cd crm그다음 코딩 에이전트에게 파일과 임포트 매핑 문서 페이지(objectstack.ai/docs/data-modeling/import-mappings)를 건네고 세 가지를 요청하라. 행들이 속한 객체, 파일이 쓰는 모든 코드를 valueMap이 번역하는 defineMapping, 그리고 실제 파일의 드라이 런. 돌아오는 것이 리뷰다. 한 번에 읽을 수 있을 만큼 짧은 매핑과, 몇 행이 생성되고 몇 행이 갱신되며 어떤 셀을 누군가 고쳐야 하는지 말하는 보고서. 거기에 서명하고 임포트를 실행하라. 그리고 다음 월요일에 다시 실행해, 기대한 자리에서 updated를 읽어라.