¿Cómo importas una hoja de cálculo de un sistema antiguo a una app construida por AI? Mapeos de importación, ensayos y las tres formas en que una fila puede no coincidir
Medido en ObjectStack 18.3.0: un mapeo de importación proyecta cabeceras y códigos ajenos sobre un objeto, un ensayo devuelve el informe fila a fila sin guardar nada, y una fila sin coincidencia se crea, se omite o falla.
La versión corta. La hoja de cálculo del sistema antiguo tiene cabeceras que no son tus nombres de campo y códigos que no son tus códigos. La solución es un mapeo de importación: una proyección con nombre y versión desde las columnas del archivo hacia los campos de un objeto, en la que map traduce los códigos del otro sistema y upsertKey decide qué significa “la misma fila”. El mapeo es estricto, así que una columna que no nombra nunca llega a la ruta de escritura. dryRun: true devuelve el informe completo fila a fila sin guardar nada. Medido en la @objectstack/cli 18.3.0 publicada: un CSV de 3 filas volvió del ensayo con created: 3 mientras la tabla seguía con 0 filas, tenía 3 filas tras la ejecución real y respondió updated: 3 cuando se envió el mismo archivo otra vez. El ensayo es la revisión: un recuento de antes y después que apruebas antes de que nada aterrice.
Todo lo que sigue se ejecutó, no se describió. La app es un andamiaje nuevo de npm create objectstack@latest sobre 18.3.0 con el objeto Lead del ejemplo de CRM que viene en el repositorio de ObjectStack, y cada recuento está citado del propio informe del servidor.
El archivo que llega cada lunes
Este es el archivo. Tiene tres filas para que quepa entero en la página; la mecánica es la misma con tres mil.
Full Name,E-mail,Company,Channel,Legacy ID
Ada Lovelace,[email protected],Analytical Engines,Webform,L-1001
Alan Turing,[email protected],NPL,Partner Referral,L-1002
Grace Hopper,[email protected],Eckert-Mauchly,Webform,L-1003
Y este es el objeto en el que tiene que aterrizar. El crm_lead del ejemplo de CRM declara name, email, company y un campo de selección source cuyos valores almacenados son web, referral, event, social, cold_outreach y partner.
Hay tres cosas mal en el archivo, y son las tres cosas que toda exportación de otro sistema hace mal:
- Las cabeceras son suyas.
Full Namees nuestroname;E-mailes nuestroemail. - Los códigos son suyos. Su
Webformes nuestroweb; suPartner Referrales nuestropartner. Ninguna de las dos grafías existe en nuestro lado. - Hay una columna que no debe aterrizar.
Legacy IDes la clave primaria del sistema antiguo. Aquí no tiene campo, y no debería adquirir uno por accidente.
Un renombrado puntual en un asistente de importación resuelve el primer problema y nada más. Los otros dos necesitan algo que se escriba una vez y se aplique cada semana.
Un mapeo de importación es una proyección, no un renombrado
La documentación de ObjectStack define el artefacto en una frase: “Un mapeo de importación es una proyección con nombre y reutilizable desde las columnas de un archivo de origen hacia los campos de un objeto.” Es un tipo de metadatos de primera clase, así que viaja dentro de un paquete o se guarda en tiempo de ejecución, y POST /api/v1/data/:object/import lo aplica por nombre. Este es el que usaron las mediciones de abajo, declarado en el código de la app junto a los objetos:
import { defineMapping } from '@objectstack/spec/data';

export const LeadFeedMapping = defineMapping({
  name: 'crm_lead_feed',
  label: 'Lead feed (legacy CRM export)',
  sourceFormat: 'csv',
  targetObject: 'crm_lead',
  fieldMapping: [
    { source: 'Full Name', target: 'name' },
    { source: 'E-mail', target: 'email' },
    { source: 'Company', target: 'company' },
    {
      source: 'Channel',
      target: 'source',
      transform: 'map',
      params: { valueMap: { Webform: 'web', 'Partner Referral': 'partner' } },
    },
  ],
  mode: 'upsert',
  upsertKey: ['email'],
});
Se registra en el stack con mappings: [LeadFeedMapping], y defineStack() lo valida mientras construyes y no en el primer uso: un targetObject que el stack no define hace fallar la build, y también lo hace una transformación javascript (más abajo). Como defineMapping() analiza la configuración al importarla, una clave mal escrita se rechaza donde la escribiste, con la grafía canónica indicada en el error. Eso es lo que convierte el mapeo en metadatos tipados y no en un archivo de configuración: un revisor lee veinte líneas y sabe que la proyección está bien formada antes de que se lea una sola fila.
| Clave | Qué decide |
|---|---|
fieldMapping[] | Una entrada por campo destino: qué columna de origen lo alimenta, y a través de qué transformación |
transform: 'map' + valueMap | Traduce los códigos del sistema de origen a los tuyos. Un valor sin entrada en la tabla pasa sin cambios |
mode | Aporta el writeMode de la petición cuando esta lo omite: insert, update o upsert |
upsertKey | Aporta los matchFields de la petición: los campos que deciden si una fila es “la misma fila” que un registro almacenado |
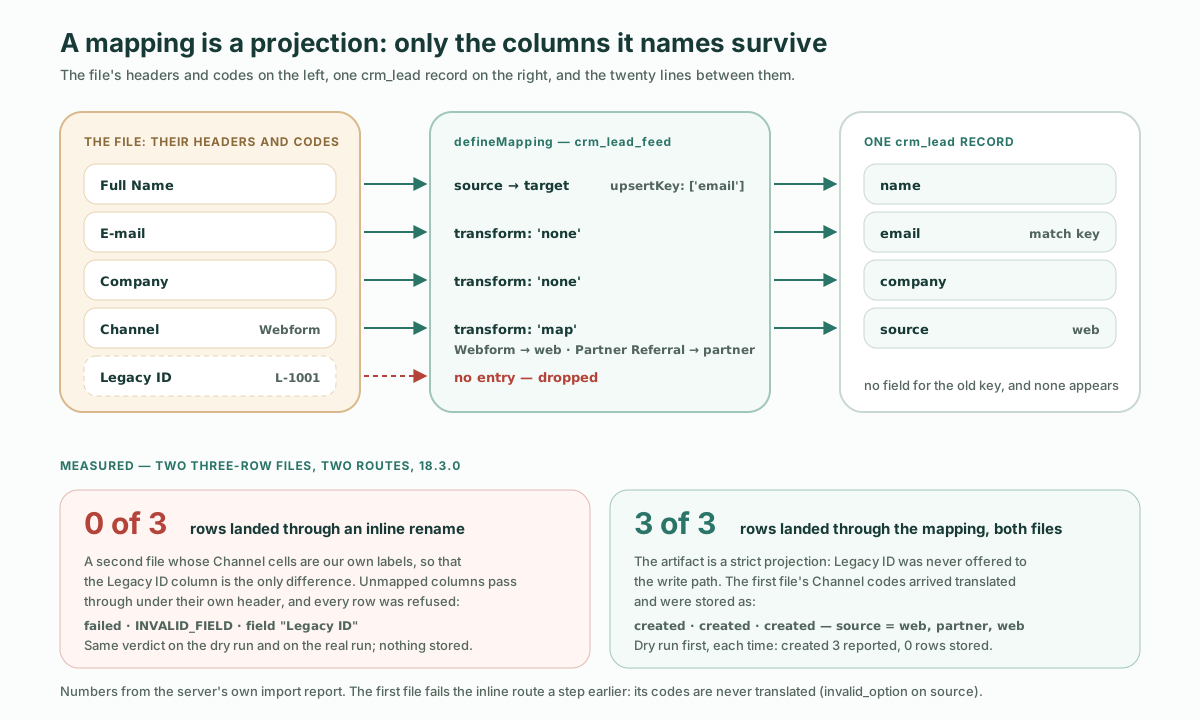
La palabra que importa en la definición es proyección. El endpoint de importación acepta dos mecanismos de mapeo, y difieren exactamente en el tercer problema de arriba. Un mapping en línea en la petición es un renombrado: su forma de array puede recortar una celda, cambiar sus mayúsculas o rellenar una vacía, pero no tiene tabla de códigos, y las columnas que no nombra “pasan a la ruta de escritura bajo su propia cabecera”. Un mapeo con nombre es lo contrario: las columnas sin mapear se “descartan. El artefacto es una proyección estricta: solo sobreviven los destinos mapeados.”
Esa diferencia es medible, así que se midió, con un segundo archivo de tres filas construido para que la columna sobrante sea lo único en lo que las dos rutas pueden discrepar: sus celdas Channel llevan nuestras propias etiquetas de opción (Website, Partner), que se resuelven sin ningún mapeo, y lleva la columna Legacy ID. Se envió con un renombrado en línea de las cuatro columnas conocidas, como ensayo y como ejecución real, y con mappingName: "crm_lead_feed" como ensayo:
| Ruta | Filas que aterrizaron | Qué dijo el informe de cada fila |
|---|---|---|
mapping en línea, ensayo | 0 de 3 | failed, code: "INVALID_FIELD", field: "Legacy ID", “Unknown field ‘Legacy ID’ on object ‘crm_lead’” |
mapping en línea, ejecución real | 0 de 3 | Los mismos tres veredictos; nada guardado |
mappingName, ensayo | 3 de 3 | created |
La ruta en línea no está rota. Hizo lo que hace un renombrado: dejó pasar Legacy ID bajo su propia cabecera, y la ruta de escritura rechazó un campo que el objeto no declara. El mapeo nunca dejó que la columna se acercara a la ruta de escritura. El primer archivo, con sus códigos Webform y Partner Referral, falla en la ruta en línea un paso antes: cada fila se rechaza con invalid_option en source, “Lead Source: ”Webform“ is not a known option”, porque nada tradujo los códigos. Para un archivo que llega cada semana desde un sistema que no controlas, esas dos garantías son la razón para escribir las veinte líneas.
El mapeo también puede guardarse en tiempo de ejecución en lugar de viajar en el paquete: PUT /api/v1/meta/mapping/crm_lead_feed_saved con la misma forma bajo un nombre nuevo respondió Saved mapping 'crm_lead_feed_saved' (env-wide, state=active) [seq=1], y un ensayo que lo nombró informó created 3. En cualquiera de los dos casos la petición de importación resuelve un mapeo por su nombre; el runtime lee primero los mapeos guardados y recurre al empaquetado. El nombre empaquetado está bloqueado: el mismo PUT a crm_lead_feed fue rechazado con 403 NOT_OVERRIDABLE.
El ensayo es la revisión
La petición que hace que el mapeo merezca la pena es corta, porque el artefacto aporta el modo de escritura y los campos de coincidencia:
POST /api/v1/data/crm_lead/import
{
  "format": "csv",
  "csv": "Full Name,E-mail,Company,Channel,Legacy ID\nAda Lovelace,...",
  "mappingName": "crm_lead_feed",
  "dryRun": true
}
El ensayo volvió con el informe completo, contadores agregados más un veredicto por fila:
{ "object": "crm_lead", "dryRun": true, "writeMode": "upsert",
  "total": 3, "ok": 3, "errors": 0, "created": 3, "updated": 0, "skipped": 0,
  "results": [
    { "row": 1, "ok": true, "action": "created" },
    { "row": 2, "ok": true, "action": "created" },
    { "row": 3, "ok": true, "action": "created" } ] }
Después se leyó la tabla: "total": 0. No se guardó nada. El mismo cuerpo sin dryRun respondió "created": 3 con un id en cada fila, y la tabla leyó "total": 3, con source conteniendo web, partner y web, los códigos traducidos y no los del archivo. El mismo archivo enviado por tercera vez respondió "created": 0, "updated": 3, y la tabla seguía leyendo 3. Ese es todo el antes y después, en tres números:
| Paso | Informe | Filas en la tabla después |
|---|---|---|
| Ensayo | total 3 · created 3 · updated 0 | 0 |
| Ejecución real | created 3 | 3 |
| El mismo archivo otra vez | created 0 · updated 3 | 3 |
¿Por qué llamarlo revisión y no vista previa? Porque es el artefacto que un revisor puede aprobar de verdad. La documentación lo dice con precisión: "dryRun": true devuelve “el mismo informe sin persistir nada; el veredicto viene de la propia validación de la ruta de escritura del motor”. No es una suposición sobre lo que haría la escritura; para cada fila pide a la ruta de escritura su veredicto y se detiene antes de persistir. Así que lo que un responsable de negocio aprueba antes de que corra la importación del lunes son dos objetos pequeños: el mapeo (veinte líneas de metadatos tipados, en control de versiones, legibles como un diff) y el informe del ensayo (cuántas filas se crearán, cuántas se actualizarán, cuáles fallarán y en qué columna). Nada ha pasado todavía cuando firman, y la segunda ejecución es la prueba de que la primera quiso decir lo que dijo.
La vista previa también vale para las filas que va a actualizar. Enviado una vez más cuando ya existían las tres filas, el ensayo respondió created 0 · updated 3, el mismo veredicto que dio después la ejecución real. Una actualización se previsualiza contra el registro guardado fusionado con las celdas del archivo, así que una regla que lee un campo que el archivo no trae, como la comprobación lead_score_range del objeto Lead sobre lead_score, juzga el registro que la escritura guardaría de verdad. Antes de 18.0 la vista previa juzgaba solo las celdas entrantes y podía rechazar una fila que la escritura luego aceptaba. Una fila que la escritura admitiría pese a un hallazgo solo consultivo vuelve con ok y una lista warnings adjunta, así que la queja queda visible en el informe en lugar de callada; ninguna de las ejecuciones de aquí produjo una.
Las tres formas en que una fila puede no coincidir
upsertKey: ['email'] dice qué significa “la misma fila”. Los casos interesantes son las filas en las que esa búsqueda no encuentra exactamente un registro. La documentación es directa al respecto: “una fila que no coincide” no es un comportamiento sino tres, elegidos por writeMode y por cuántos registros coincidieron.
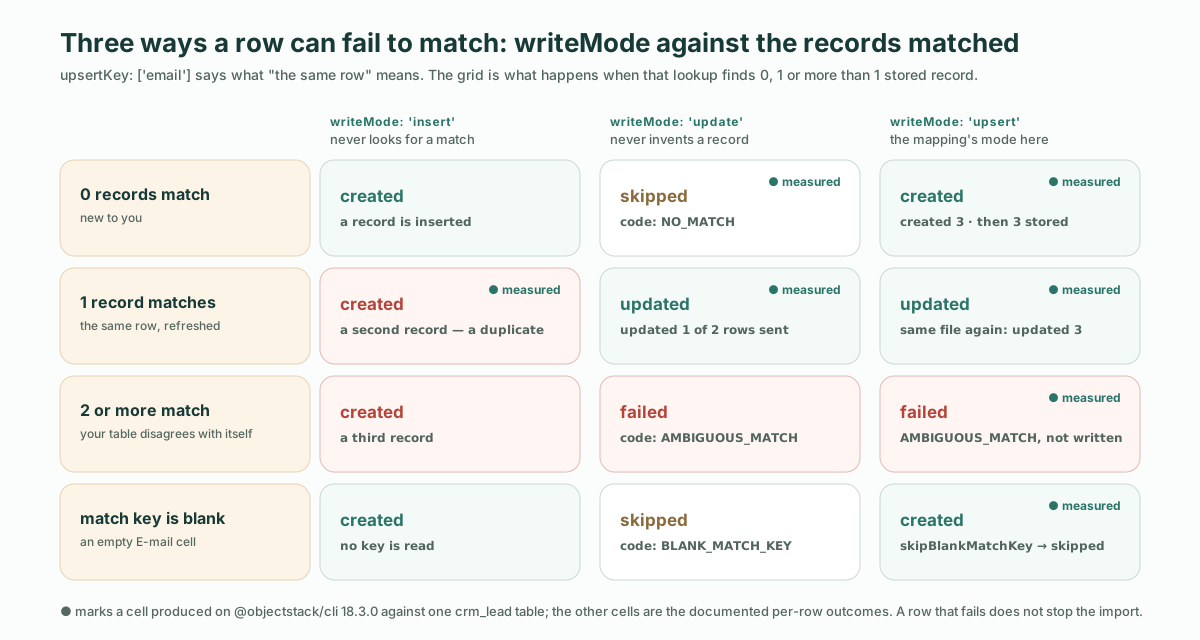
Las tres se produjeron contra la misma tabla, y cada una es un tipo distinto de respuesta:
| Filas coincidentes | writeMode: 'upsert' | writeMode: 'update' | Qué significa para el archivo |
|---|---|---|---|
| 0 | created | skipped, code: "NO_MATCH" | Nueva para ti. Upsert la admite; update se niega a inventar un registro |
| 1 | updated | updated | La misma fila, refrescada |
| 2 o más | failed, code: "AMBIGUOUS_MATCH" | failed, code: "AMBIGUOUS_MATCH" | Tu tabla ya se contradice a sí misma; no se escribe nada para esa fila |
Las ejecuciones medidas: un archivo de dos filas enviado con writeMode: "update" respondió updated 1, skipped 1, con la fila de la persona desconocida leyendo "action": "skipped", "code": "NO_MATCH". Después se cargó una fila dos veces con writeMode: "insert", que nunca busca coincidencia, así que la tabla contenía dos registros con el mismo email, y la misma fila enviada como upsert respondió "action": "failed", "code": "AMBIGUOUS_MATCH", con el mensaje “matchFields matched more than one crm_lead record”. El duplicado es un hecho sobre la tabla, y la importación lo informa en lugar de elegir uno.
Hay una cuarta fila que conviene conocer: aquella cuyo campo de coincidencia está en blanco. Una fila con la celda E-mail vacía fue creada por el upsert, porque upsert crea esas filas por defecto; con "skipBlankMatchKey": true en la petición, la misma fila volvió como "action": "skipped", "code": "BLANK_MATCH_KEY". Cuál de las dos quieres depende de si un lead sin email es un lead o una errata, y esa es una decisión que lleva la petición, no el mapeo.
En 18.2 llegó un caso más: un archivo que se contradice a sí mismo. Cuando dos filas de un mismo upsert o update llevan la misma clave de coincidencia, no se escribe ninguna, ni en el ensayo ni en la ejecución real. Un archivo de tres filas que incluía [email protected] dos veces respondió ok 1 · errors 2; la tercera fila se creó, y los dos duplicados volvieron como "action": "failed", "code": "DUPLICATE_MATCH_KEY" con este mensaje:
Rows 1, 2 of this import have the same match key (email), so none of them was written: keep one row per key and import againEl arreglo va en la hoja de cálculo: conserva la fila correcta y envía el archivo otra vez.
Después del mapeo, la celda sigue teniendo que ser legal
El mapeo decide qué valor aterriza en qué campo. Convertir ese valor en algo que el almacenamiento acepte es un paso aparte, ejecutado después a partir de los propios metadatos de campo del objeto destino, y los dos pasos fallan de forma distinta. Un archivo de cuatro filas los ejercitó en una sola petición:
| La celda | Qué pasó | El veredicto de la fila |
|---|---|---|
Channel = Trade Show, un código que el valueMap no conoce | El map lo dejó pasar sin cambios, como está documentado; la coerción del campo de selección no encontró entonces ninguna opción llamada Trade Show | failed, field: "source", code: "invalid_option", “Lead Source: ”Trade Show“ is not a known option” |
Channel = Event, fuera del valueMap pero etiqueta de una opción existente | Pasó sin cambios; se resolvió al valor almacenado event por etiqueta, sin ninguna entrada del mapeo de por medio | created |
E-mail = not-an-email | La propia coerción del campo email lo rechazó | failed, field: "email", code: "invalid_email" |
E-mail en blanco | Admitida por upsert, como arriba | created |
Dos de las cuatro filas aterrizaron, dos no, y el informe leyó "ok": 2, "errors": 2. Una fila que falla no detiene la importación; recibe su propia línea con la columna problemática nombrada, que es la línea que alguien corrige en la hoja antes del próximo lunes.
El segundo caso merece una frase, porque acota para qué sirve map. Las etiquetas de selección ya se resuelven a valores almacenados sin ningún mapeo, en el idioma de la app y en sus traducciones. Así que el valueMap no sirve para enseñarle a la importación tus etiquetas de opción; sirve para los códigos del otro sistema, las grafías que no son ni tus valores ni tus etiquetas. Webform necesita el map. Event nunca lo necesitó.
Rechazado antes de leer una sola fila
Algunas peticiones se rechazan enteras, sin informe por fila, porque responderlas fila a fila ocultaría un error en la propia petición. Tres de ellas se midieron; el resto viene de la tabla documentada.
| Estado | code | Causa |
|---|---|---|
| 404 | MAPPING_NOT_FOUND | No hay ningún mapeo registrado con ese nombre. Medido: “No mapping artifact named ”crm_lead_feed_nope“ is registered” |
| 400 | CONFLICTING_MAPPING | mappingName y un mapping en línea en la misma petición. Medido: “Provide either mappingName or an inline mapping, not both” |
| 400 | MAPPING_TARGET_MISMATCH | El targetObject del artefacto no es el objeto de la URL |
| 400 | UNSUPPORTED_TRANSFORM | Alguna entrada declara javascript, o una transformación que la canalización no implementa |
| 413 | PAYLOAD_TOO_LARGE | Más de 5.000 filas en la ruta síncrona |
El techo es exacto. Un archivo de 5.001 filas fue rechazado con “Import limit is 5000 rows per request (got 5001). Use an async import job for larger files.” Un archivo de 5.000 filas, como ensayo, volvió con "total": 5000, "ok": 5000, "created": 5000 en una sola respuesta. Por encima de eso, POST /api/v1/data/:object/import/jobs analiza el mismo cuerpo y admite hasta 50.000 filas, devolviendo un id de trabajo para consultar; esa ruta no se ejercitó aquí.
Lo que esto no resuelve
Código propio en el mapeo. TransformType declara siete valores: none, constant, map, split, join, lookup y javascript. Los cinco primeros se ejecutan fila a fila, lookup es un paso directo deliberado hacia la resolución de referencias de la propia importación, y javascript se rechaza, porque “no hay sandbox en el servidor, y saltarse en silencio una transformación declarada corrompería los datos”. Las dos mitades de ese rechazo se midieron en 18.3.0. Cambiar una entrada del mapeo empaquetado a transform: 'javascript' hizo fallar objectstack build con “Mapping ‘crm_lead_feed’ uses transform ‘javascript’, which the import path does not execute (no server-side sandbox). Use none/constant/map/split/join/lookup, or model the logic as a flow.” Guardar lo mismo en tiempo de ejecución a través de PUT /api/v1/meta/mapping/... fue aceptado, y la primera importación que lo nombró fue rechazada con 400 UNSUPPORTED_TRANSFORM. Para lógica más allá de las cinco transformaciones, la respuesta de la documentación es transformar los datos antes de enviarlos o modelarla como un flow sobre el objeto destino. Ese es también el límite correcto para un revisor: un mapeo que puedes leer entero es un mapeo que puedes aprobar.
Decidir qué significaba la columna antigua. El mapeo registra la decisión de que Partner Referral significa partner. No la toma. Alguien que conozca ambos sistemas sigue teniendo que decir cuál de los seis valores de source es un lead de Trade Show, y si un lead sin email es un lead.
El asistente de importación, las automatizaciones y la ruta asíncrona. El asistente que guarda un mapeo a partir de las columnas que elige un usuario es una superficie de producto que este artículo no cubre; todo lo de aquí se quedó en la ruta REST que usaría un agente o un script. La petición acepta una clave runAutomations; lo que las filas disparan al entrar es un tema aparte. Y la ruta de trabajos de 50.000 filas se nombró, no se ejecutó.
Dónde encaja esto en una migración
Este es el paso de carga, y es deliberadamente pequeño. Si la pregunta es si mover el sistema antiguo en absoluto, el camino por etapas para salir de un sistema interno heredado es la estrategia: conectar en solo lectura, medir tus reglas declaradas contra el historial, habilitar escrituras objeto a objeto. Si el sistema antiguo se queda y quieres AI sobre sus datos sin mover nada, conectar la base de datos que ya ejecutas es el mecanismo, y la versión para fabricación muestra por dónde empezar cuando el sistema es un ERP. Los mapeos de importación son para el caso intermedio: el sistema desaparece, o nunca tuvo API, y lo que tienes es un archivo.
Alojado, o en tu propia infraestructura
Todo lo anterior corrió en el runtime open source que instala un andamiaje. ObjectOS se ofrece en tres ediciones: ObjectOS Community, open source y gratuita para autoalojar; ObjectOS Cloud, alojada en el navegador sin instalar nada; y ObjectOS Enterprise, autogestionada en tu propia infraestructura. Tu ontología son metadatos ordinarios de ObjectStack. La exportación desde ObjectOS Cloud u ObjectOS Enterprise para ejecutarla en el runtime open source de ObjectStack está prevista. El mapeo forma parte de esa ontología: viaja con el paquete.
Empieza por la ruta del agente
npm create objectstack@latest crm && cd crmDespués entrega a tu agente de programación el archivo y la página de documentación de los mapeos de importación (objectstack.ai/docs/data-modeling/import-mappings), y pídele tres cosas: el objeto al que pertenecen las filas, un defineMapping cuyo valueMap traduzca cada código que usa el archivo, y un ensayo del archivo real. Lo que vuelve es la revisión: un mapeo lo bastante corto como para leerlo de una sentada, y un informe que dice cuántas filas se crearán, cuántas se actualizarán y qué celdas tiene que corregir alguien. Firma eso y ejecuta la importación. Después ejecútala otra vez el próximo lunes y lee updated donde lo esperas.