¿Cuándo no deberías usar una ontología de negocio ejecutable?
Cinco cargas de trabajo donde una ontología de negocio ejecutable es hoy la herramienta equivocada, qué usar en su lugar, el coste de elegir mal y una tabla de decisión con fuente en cada fila.
Respuesta corta: no para cinco cargas de trabajo, y la propia documentación de ObjectStack las nombra. Sustituir el ERP o el sistema financiero central de una gran empresa. Trabajo cuyo valor está en integrar muchos sistemas existentes. Analítica sobre data lakes. Dominios con mucho algoritmo, como pricing o planificación, salvo que el algoritmo se envuelva en una acción. Y cualquier cosa que deba ejecutarse en una plataforma certificada. Para cada caso hay una herramienta mejor, y este artículo dice cuál, por qué es la decisión correcta y qué cuesta equivocarse. Al final: una tabla de decisión con una fuente en cada fila y una autoevaluación de diez preguntas que puedes aplicar a tu propio caso antes de instalar nada.
Una lista honesta de dónde un producto es la herramienta equivocada es lo más útil que un proveedor puede publicar, porque es lo único que un comprador no obtiene de la presentación comercial. El posicionamiento en una línea de ObjectStack es: «Una ontología de negocio ejecutable. La AI la escribe, el runtime la ejecuta, los agentes la operan, tú la posees.» Todo lo que sigue trata de los bordes de esa frase, tomados de la propia página when-to-use del proyecto y de su página de comparación en la etiqueta @objectstack/[email protected], leída el 2026-10-28, y del archivo fuente donde el límite es una línea de código. La página de comparación de este sitio ya enumera las cinco cargas de trabajo y las cinco preguntas en una línea cada una; este artículo es la versión larga: un escenario para cada caso, la alternativa y su justificación, el coste y el hecho decisivo.
La prueba de las seis clases
Una sola prueba cubre los cinco casos, así que conviene enunciarla primero. La página de conceptos define el núcleo de una ontología de negocio ejecutable como seis clases de cosas: objetos y campos, relaciones, acciones, permisos, flujos, y definiciones de agentes y herramientas. El runtime deriva la base de datos, la API, la UI y las herramientas de agente a partir de esas seis, y las hace cumplir en cada llamada. El código no desaparece, pero se traslada al runtime, como hooks, cuerpos de acciones, CEL y JSX restringido, dentro del cercado que definen las seis clases.
Así que pregunta de cualquier carga de trabajo: ¿la parte difícil es una de las seis clases? Si la parte difícil, valiosa y arriesgada del trabajo es decidir qué existe, cómo se relaciona, qué puede hacerse, quién puede hacerlo y qué ocurre cuándo, la ontología es la herramienta, y un agente puede escribirla. Si la parte difícil es otra cosa, un cálculo legal, una conexión con cuarenta sistemas, un escaneo sobre un petabyte, un solver, el certificado de un auditor, entonces esa parte no es expresable como definición, y la ontología en el mejor de los casos la envuelve y en el peor la imita. Llamémoslo la prueba de las seis clases. Cada una de las cinco cargas de trabajo de abajo la suspende por una razón distinta, y por eso necesitan cinco alternativas distintas en lugar de una.
1. El ERP o el sistema financiero central de una gran empresa
El escenario. Un fabricante con cuatro mil personas lleva doce años con su libro mayor, su consolidación y su nómina en un ERP empaquetado. Un agente de programación, al que se le muestra el plan de cuentas, se ofrece a redeclararlo como objetos, con reglas de asiento como flujos e impuestos como fórmulas. La demo convence: diarios, un balance de comprobación, una aprobación en cada asiento.
Qué usar en su lugar, y por qué es lo correcto. El sistema empaquetado, y construir alrededor de él. La página when-to-use: “A general ledger, consolidation, tax and payroll carry regulation and edge cases that packaged systems already encode. Build around that core, not instead of it.” (Un libro mayor, la consolidación, los impuestos y la nómina llevan regulación y casos límite que los sistemas empaquetados ya codifican. Construye alrededor de ese núcleo, no en su lugar.) En ese mercado la regulación es el producto. Un motor de nómina es una biblioteca de jurisdicciones, calendarios de presentación y correcciones retroactivas, mantenida por personas cuyo único trabajo es mantenerla al día; un motor de consolidación son años de eliminaciones intercompañía y de casos límite de conversión de divisas. Nada de eso es «qué existe y quién puede hacer qué». Es cálculo, y cambia cuando un gobierno lo cambia, no cuando lo hace tu negocio.
El coste de elegir mal. Un segundo libro mayor. Cada regla que recodificaste es ahora tu diff que mantener, tu auditoría que superar y tu defecto cuando cambia el ejercicio fiscal, mientras el sistema empaquetado que conservaste para la información legal discrepa un poco más de tu copia cada trimestre. El agente que escribió las reglas en un día no puede leer un código tributario por ti.
El hecho decisivo. La tabla de capacidades del README enumera doce cosas que el runtime proporciona: objetos y campos, permisos, automatización, aprobaciones, vistas, paneles e informes, acciones, APIs y SDK, herramientas de AI, traducciones, datos semilla, fuentes de datos. Un libro mayor, un motor fiscal y un proceso de nómina no están en ella, y el proyecto no dice que vayan a llegar.
Lo que sí encaja, según la misma página, es la larga cola alrededor de ese núcleo: “vendor onboarding, inspections, internal requests” (alta de proveedores, inspecciones, solicitudes internas), las hojas de cálculo y formularios que registran lo que el ERP no cubre. Cada uno se convierte en una definición tipada en lugar de un archivo que circula por correo, y cada uno puede leer los datos del ERP sin poseerlos, que es el siguiente caso.
2. Cargas de trabajo cuyo valor está en integrar muchos sistemas existentes
El escenario. Un banco quiere que sus agentes respondan a la pregunta de un cliente desde el core bancario, el CRM, la plataforma de tarjetas y el sistema de tickets a la vez, y que escriban un estado en dos de ellos. Ninguno de esos sistemas se va a mover. El trabajo es hacerlos legibles para un agente y actuar a través de ellos.
Qué usar en su lugar, y por qué. Una capa sobre los sistemas: una capa semántica o de contexto para la lectura, una ontología operativa al estilo de Palantir cuando hay escritura de vuelta que gobernar. La página de comparación lo reconoce sin rodeos: “When the data already lives in a warehouse, a lakehouse and a dozen operational systems, these start where you are.” (Cuando los datos ya viven en un warehouse, un lakehouse y una docena de sistemas operativos, estas empiezan donde tú estás.) Esos productos están construidos sobre el supuesto de que el sistema de registro se queda donde está; su modelo de objetos es una vista, sus escrituras son writeback, y su valor crece con el número de sistemas que hay debajo. ObjectStack está construido sobre el supuesto contrario: que la ontología es el sistema y la base de datos se deriva de ella.
El coste de elegir mal. Este es el caso en que más se falla, porque la primera semana va bien. ObjectStack puede federar una base de datos externa como fuente de datos con schemaMode: 'external', y un modelo de lectura sobre una tabla heredada es una tarde corta. Luego llegan las escrituras. Las escrituras federadas están apagadas por defecto dos veces: la fuente de datos debe declarar external.allowWrites: true y el objeto debe declarar external.writable: true, y “with either gate off, insert/update/delete on the federated object is rejected.” (con cualquiera de las dos puertas cerrada, insert/update/delete sobre el objeto federado se rechaza.) La puerta no es consultiva: assertWriteAllowed se ejecuta al principio de insert y update del motor, antes de valores por defecto, hooks y validación. Abre ambas puertas objeto por objeto y ahora posees la semántica de escritura contra un esquema que no controlas, y schemaMode: 'external' hace fallar el arranque ante una discrepancia de esquema, así que un renombrado de columna aguas arriba tumba tu aplicación. O construyes trabajos de sincronización en su lugar, y para entonces has construido la capa de integración que intentabas no comprar, dentro de una herramienta cuya propia documentación llama a su federación “early” (temprana).
El hecho decisivo. Dos opt-ins, ambos apagados por defecto: allowWrites en la fuente de datos y writable en el objeto (content/docs/data-modeling/external-datasources.mdx, la sección sobre escrituras), aplicados por assertWriteAllowed en packages/objectql/src/engine.ts.
El camino honesto existe, y es estrecho: conectar en solo lectura, medir, habilitar escrituras un objeto a la vez, migrar objeto por objeto. How to move an internal system to metadata lo recorre, incluidos los casos en los que la respuesta correcta es no migrar en absoluto. Ese camino es para un sistema que pretendes sustituir. Si pretendes conservar cuarenta sistemas y leer a través de ellos, es la carretera equivocada.
3. Analítica sobre data lakes
El escenario. Un minorista tiene tres años de eventos de clickstream y de punto de venta en almacenamiento de objetos, como tablas Parquet e Iceberg, y el equipo de merchandising quiere paneles. Alguien nota que la plataforma tiene paneles, informes y una capa de datasets que su documentación llama semántica, y propone apuntarla al lake.
Qué usar en su lugar, y por qué. La pila de warehouse: un motor de consulta construido para escaneos columnares, una capa de métricas o semántica sobre él y una herramienta de BI encima. La capa analítica de ObjectStack es una capa de métricas para las filas propias de la aplicación. Su documentación define un dataset como “a base object, the relationships to include, and the declared dimensions and measures” (un objeto base, las relaciones a incluir y las dimensiones y medidas declaradas), con joins derivados del grafo de objetos; el esquema lo hace literal, describiendo el object de un dataset como “Base object name” (nombre del objeto base). La página when-to-use lo dice en una frase: la capa analítica “defines metrics over the app’s own objects for its reports and dashboards. It is not built to query a lake.” (define métricas sobre los propios objetos de la app para sus informes y paneles. No está construida para consultar un lake.) Una capa semántica de warehouse hace el mismo trabajo sobre un lake, y la página de comparación de este sitio dice que una empresa que hace BI en serio seguirá queriendo una.
El coste de elegir mal. Una de dos copias. O cargas el lake en objetos de la app, y ahora tienes una segunda copia de tres años de eventos con su propia frescura y su propia factura, en un almacén de filas derivado de una definición de negocio en lugar de diseñado para escaneos; o federas una tabla de warehouse y descubres que estás enviando preguntas analíticas a través de un motor construido para responder consultas a nivel de fila para una aplicación, con pushdown de filtros y nada que conozca un archivo columnar. Los paneles se renderizarán. No serán los paneles que pidió el equipo de merchandising.
El hecho decisivo. Las fuentes de datos que enumera el README son PostgreSQL, MySQL, SQLite, MongoDB y en memoria; el directorio de paquetes, que el README ahora delega en CONTRIBUTING.md, añade Turso y SQLite en WebAssembly. No hay formato de lake, ni motor columnar, ni driver de almacenamiento de objetos, y la capa de datasets se vincula a un objeto, no a una tabla en un lake.
4. Dominios con mucho algoritmo, como pricing o planificación
El escenario. El producto de una empresa logística es un optimizador de rutas: un solver que toma los pedidos de un día y una flota y produce un plan, con un tablero de despacho donde los planificadores arrastran paradas entre vehículos y ven cómo el plan se vuelve a resolver. Los pedidos, vehículos, conductores y planes son claramente objetos; la empresa pregunta si todo el conjunto podría ser una ontología ejecutable.
Qué usar en su lugar, y por qué. Código, para el solver y para el tablero, y aquí la propia documentación de la ontología es el mejor argumento a favor de la alternativa. La página when-to-use: la ontología “declares what can be done; it does not express an optimiser.” (declara qué puede hacerse; no expresa un optimizador.) El type de una acción es uno de script, url, modal, flow, api o form, y el handler de una acción script es código que se ejecuta con toda la autoridad de datos de la app. La definición posee la puerta, el permiso de la puerta y la auditoría de quién la cruzó. El algoritmo tras la puerta es tuyo, en el lenguaje que lo resuelva. La interfaz es la misma historia en la otra dirección: la página de comparación dice que la Console es “server-driven from metadata, and an interface unlike any business app is easier to build directly.” (dirigida por el servidor a partir de metadatos, y una interfaz que no se parece a ninguna aplicación de negocio es más fácil de construir directamente.)
El coste de elegir mal. Construir la parte que importa en el lugar con menos libertad. Un solver puede vivir detrás de una acción, y para una ejecución de planificación lanzada desde un registro eso es exactamente lo correcto. Un tablero de despacho no puede: el JSX restringido en las páginas “is parsed into a server-driven UI tree, never executed as code” (se parsea en un árbol de UI dirigido por el servidor, nunca se ejecuta como código), por diseño, así que cada interacción que los planificadores necesitan se convierte en una negociación con un renderizador construido para listas, formularios y tableros. Seis meses después, la ontología es un envoltorio fino alrededor de lo que realmente vendes.
El hecho decisivo. ActionType en packages/spec/src/ui/action.zod.ts es el conjunto cerrado script | url | modal | flow | api | form. El algoritmo nunca es uno de ellos, solo la ruta hacia él.
La división que funciona: la mitad de negocio, pedidos, vehículos, conductores, quién puede aprobar un plan, qué ocurre cuando se publica un plan, como ontología, donde un agente puede escribirla y operarla; el solver como código detrás de una acción script, de modo que permisos, auditoría y acceso de agentes se le aplican como a cualquier otra acción; el tablero de los planificadores como su propia aplicación. Si el tablero es el producto, empieza por ahí.
5. Cargas de trabajo que requieren una plataforma certificada
El escenario. Un grupo hospitalario quiere un flujo de admisión, y su área de compras exige que la plataforma en la que se ejecute posea una certificación concreta. Una licitación pública hace la misma pregunta sobre un certificado ISO. La carga de trabajo en sí, formularios, enrutamiento, aprobaciones y una pista de auditoría, encaja de manual.
Qué usar en su lugar, y por qué. O bien una plataforma que posea el certificado, o bien un despliegue que certifiques tú mismo, y la decisión es el calendario del comprador, no la hoja de ruta del proveedor. La página when-to-use: “ObjectStack is open-source software you deploy and operate, and it carries no compliance certification of its own. Where a workload must run on a certified platform, certifying your deployment is work you own.” (ObjectStack es software de código abierto que tú despliegas y operas, y no lleva ninguna certificación de cumplimiento propia. Donde una carga de trabajo deba ejecutarse en una plataforma certificada, certificar tu despliegue es trabajo que te pertenece.) Eso no es evasión; así funciona la certificación. Una certificación cubre un entorno en ejecución, sus controles y sus operadores, y un repositorio Apache-2.0 no es ninguna de esas cosas. La página de seguridad de este sitio dice lo mismo de la edición comercial: “Certification depends on your running deployment, not a binary alone.” (La certificación depende de tu despliegue en ejecución, no de un binario por sí solo.)
El coste de elegir mal. Descubrirlo en la fase de compras en lugar de en el diseño, cuando el calendario ya daba por hecho que la plataforma traía su certificado. La auditoría cae entonces sobre tu plan, sin presupuesto, justo antes de la puesta en marcha.
El hecho decisivo. El glosario del proyecto lista incluso su propio kit de conformidad del protocolo como “planned” (planificado), con “no TCK program or certification mechanism in the codebase today” (ningún programa TCK ni mecanismo de certificación en el código hoy). No hay nada que mostrar a un auditor salvo tu despliegue.
La carga de trabajo sigue encajando; la cuestión es el anfitrión. La secuencia honesta es poner precio primero al trabajo de certificación y luego decidir.
Dos lugares más donde otra categoría sale con ventaja
La página de comparación añade dos concesiones que no están en la lista de lo que no encaja, porque tratan de un tipo de problema y no de un tipo de carga de trabajo. Ambas pasan por la prueba de las seis clases de la misma manera.
Razonar sobre datos heterogéneos. Si la pregunta es «qué se deduce de todo lo que sabemos», con jerarquías de clases, hechos derivados y comprobaciones de consistencia entre vocabularios, ese es el trabajo de una ontología de conocimiento, y ObjectStack tiene “no object inheritance, no axioms and no reasoner” (sin herencia de objetos, sin axiomas y sin razonador). La clave abstract se eliminó de la especificación en lugar de dejarla como promesa. La definición se valida y luego se ejecuta; nada se infiere en tiempo de ejecución. El artículo de la definición trata esta negación a fondo.
Madurez del ecosistema. Salesforce, Odoo y ERPNext “bring years of production use, packaged applications, app marketplaces and implementation partners. ObjectStack is younger; expect to build more of it yourself.” (aportan años de uso en producción, aplicaciones empaquetadas, mercados de apps y socios de implementación. ObjectStack es más joven; espera construir más por tu cuenta.) Si necesitas una app empaquetada este trimestre y un socio de implementación en tu ciudad, una plataforma más joven es la apuesta equivocada, se escriban como se escriban sus definiciones.
La tabla de decisión
Cada fila: la carga de trabajo, si encaja hoy y qué usar en su lugar, y el único hecho que lo decide, con su fuente. «Hoy» es una fecha: las fuentes son objectstack en la etiqueta @objectstack/[email protected], la versión que npm view @objectstack/cli dist-tags reportó como latest el 2026-10-28, leída ese día. Las fuentes se nombran por archivo: when-to-use, compare y ontology son content/docs/concepts/*.mdx; external-datasources y analytics están bajo content/docs/data-modeling/; glossary está bajo content/docs/getting-started/; engine.ts es packages/objectql/src/engine.ts; dataset.zod.ts y action.zod.ts están bajo packages/spec/src/ui/; README y CONTRIBUTING.md están en la raíz del repositorio.
| Carga de trabajo | ¿Encaja hoy? Qué usar en su lugar | El hecho decisivo (fuente) |
|---|---|---|
| ERP o finanzas centrales de una gran empresa | No. El sistema empaquetado; construir alrededor | La regulación y los casos límite son el producto; las doce capacidades del runtime no incluyen motor de libro mayor, fiscal ni de nómina (when-to-use; tabla de capacidades del README) |
| Integrar muchos sistemas existentes | No. Una capa semántica o de contexto; una ontología operativa donde hay writeback | La federación es de solo lectura por defecto, dos veces: allowWrites en la fuente de datos y writable en el objeto (external-datasources; assertWriteAllowed en engine.ts) |
| Analítica sobre un data lake | No. Un motor de consulta de warehouse, una capa de métricas, BI | Un dataset se vincula a un objeto base; los drivers son almacenes de filas, sin formato de lake (analytics; dataset.zod.ts; fuentes de datos del README; drivers de CONTRIBUTING.md) |
| Dominio con mucho algoritmo | No para el algoritmo. Código; detrás de una acción script cuando el resto es una app de negocio | ActionType es script, url, modal, flow, api, form; el solver nunca es un tipo (action.zod.ts; when-to-use) |
| Debe ejecutarse en una plataforma certificada | No sin trabajo que te pertenece. Una plataforma certificada, o certificar tu despliegue | Sin certificación de cumplimiento propia; incluso el kit de conformidad está «planificado» (when-to-use; glossary) |
| Razonar sobre datos heterogéneos | No. Una ontología de conocimiento con razonador | Sin herencia, sin axiomas, sin razonador; abstract eliminado bajo ADR-0049 (ontology; compare) |
| Necesita un ecosistema maduro ya | Todavía no. Una plataforma de metadatos con apps empaquetadas y socios | «ObjectStack es más joven; espera construir más por tu cuenta» (compare) |
| Una nueva app de negocio: CRM, tickets, aprobaciones, operaciones, herramientas internas | Sí. | Objetos, relaciones, acciones, permisos y flujos son la mayor parte de lo que son estas apps (when-to-use) |
| La larga cola alrededor de un ERP central | Sí. | Pequeña, específica, cambia a menudo; una definición tipada por app, que lee el ERP sin poseerlo (when-to-use) |
| Un back office operado por agentes desde el primer día | Sí. | Cada despliegue es un servidor MCP, activado por defecto, bajo los permisos del usuario (when-to-use; README) |
Haz la autoevaluación
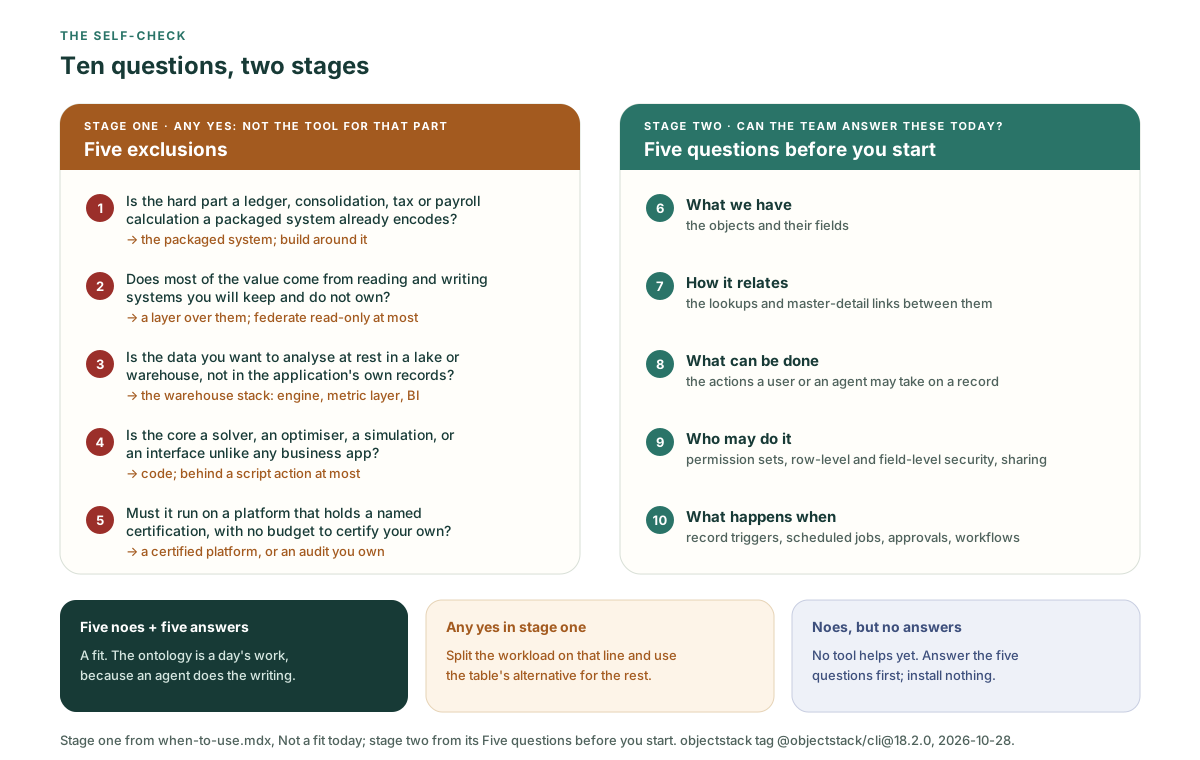
Diez preguntas, dos etapas, diez minutos. La etapa uno es la lista de exclusión; la etapa dos son las “Five questions before you start” (Cinco preguntas antes de empezar) de la página when-to-use, citadas tal como las imprime.
Etapa uno. Cualquier sí significa que la ontología no es la herramienta para esa parte.
- ¿La parte difícil de esta carga de trabajo es un cálculo regulado que un sistema empaquetado ya codifica: libro mayor, consolidación, impuestos, nómina?
- ¿La mayor parte del valor proviene de leer y escribir sistemas que conservarás y no posees?
- ¿Los datos que quieres analizar están en reposo en un lake o un warehouse en lugar de en los registros propios de la aplicación?
- ¿El núcleo del producto es un solver, un optimizador o una simulación, o una interfaz que no se parece a ninguna app de negocio?
- ¿Debe la carga de trabajo ejecutarse en una plataforma que posea una certificación concreta, sin presupuesto para certificar un despliegue propio?
Etapa dos. ¿Puede tu equipo responder a esto para el negocio, hoy?
- “What we have — the objects and their fields.” (Qué tenemos: los objetos y sus campos.)
- “How it relates — the lookups and master-detail links between them.” (Cómo se relaciona: los lookups y los enlaces maestro-detalle entre ellos.)
- “What can be done — the actions a user or an agent may take on a record.” (Qué puede hacerse: las acciones que un usuario o un agente puede ejecutar sobre un registro.)
- “Who may do it — permission sets, row-level and field-level security, sharing.” (Quién puede hacerlo: conjuntos de permisos, seguridad a nivel de fila y de campo, compartición.)
- “What happens when — record triggers, scheduled jobs, approvals, workflows.” (Qué ocurre cuándo: disparadores de registro, trabajos programados, aprobaciones, flujos de trabajo.)
Cinco noes y cinco respuestas: la ontología es, en palabras de la página, “a day’s work, because an agent does the writing.” (un día de trabajo, porque un agente hace la escritura.) Cinco noes y ninguna respuesta: “no tool helps yet, this one included. The first investment is answering these five questions, not installing anything.” (ninguna herramienta ayuda todavía, esta incluida. La primera inversión es responder a estas cinco preguntas, no instalar nada.) Un sí en la etapa uno: divide la carga de trabajo por esa línea, conserva la parte que pasó y usa la alternativa de la tabla para el resto.
Lo que esta lista no dice
No dice que estos límites sean permanentes. La página se titula «not a fit today» (no encaja hoy), la federación se llama «early» (temprana), y la tabla de arriba lleva fecha; léela contra la página actual antes de decidir.
No dice que las alternativas sean mejores en general. Una capa semántica es la herramienta correcta para leer a través de cuarenta sistemas y la equivocada para operar un servicio de tickets, por las razones que la segunda sección da en la otra dirección. La alternativa de cada fila es correcta para esa fila.
Y no dice que suspender una fila suspenda la carga de trabajo. La mayoría de los casos reales se dividen: el flujo de admisión encaja y el anfitrión es una cuestión de compras; el dominio de despacho encaja y el solver es código; las apps departamentales alrededor del ERP encajan y el libro mayor se queda donde está. La prueba de las seis clases se aplica a la parte difícil, no al nombre del proyecto.
Dónde se sitúa ObjectOS en esta lista
Nada de lo anterior cambia con la edición. ObjectOS se ofrece en tres ediciones: ObjectOS Community, open source y gratuita para autoalojar; ObjectOS Cloud, alojada en el navegador sin instalar nada; y ObjectOS Enterprise, autogestionada en tu propia infraestructura. Tu ontología son metadatos ordinarios de ObjectStack. La exportación desde ObjectOS Cloud u ObjectOS Enterprise para ejecutarla en el runtime open source de ObjectStack está prevista. Las cinco cargas de trabajo tratan de lo que una ontología ejecutable puede expresar, no de dónde se ejecuta, así que la lista se lee igual en cualquier anfitrión. La única pregunta que trata del anfitrión, la certificación, la responde la página de seguridad para ObjectOS en los mismos términos que la página de código abierto: depende del despliegue en ejecución.
Si tu caso pasó la prueba
Entonces el siguiente paso más rápido y honesto no es una demo; es una definición. Apunta tu agente de programación a ObjectStack, con el archivo de reglas, el paquete de skills y el servidor de herramientas que cubre how to point your agent at ObjectStack, y pídele el primer objeto: unos pocos campos, una relación, una acción, un conjunto de permisos y un disparador. Ejecuta npm run validate y lee el diff antes de leer la Console. Si puedes leer todo el diff y dice lo que hace tu negocio, la prueba de las seis clases ha pasado en la práctica, y qué es la definición es la siguiente página que entregar al agente. Si no puedes, nada en este artículo iba a ayudarte, y acabas de ahorrarte un proyecto.