Quand ne pas utiliser une ontologie métier exécutable ?
Cinq charges de travail pour lesquelles une ontologie métier exécutable est aujourd’hui le mauvais outil, quoi utiliser à la place, le coût d’un mauvais choix, et une table de décision avec une source par ligne.
Réponse courte : pas pour cinq charges de travail, et la documentation d’ObjectStack les nomme elle-même. Remplacer l’ERP ou le système financier central d’une grande entreprise. Un travail dont la valeur tient à l’intégration de nombreux systèmes existants. L’analytique sur des data lakes. Les domaines à forte composante algorithmique comme le pricing ou l’ordonnancement, sauf si l’algorithme est encapsulé dans une action. Et tout ce qui doit tourner sur une plateforme certifiée. Pour chacun il existe un meilleur outil, et cet article dit lequel, pourquoi c’est le bon choix, et ce que coûte un mauvais choix. À la fin : une table de décision avec une source sur chaque ligne, et une auto-évaluation en dix questions que vous pouvez appliquer à votre propre cas avant d’installer quoi que ce soit.
Une liste honnête des cas où un produit est le mauvais outil est la chose la plus utile qu’un éditeur puisse publier, parce que c’est la seule qu’un acheteur ne trouve pas dans la présentation commerciale. Le positionnement en une ligne d’ObjectStack est : « Une ontologie métier exécutable. L’AI l’écrit, le runtime l’exécute, les agents l’opèrent, vous la possédez. » Tout ce qui suit porte sur les bords de cette phrase, tirés de la page when-to-use et de la page de comparaison du projet au tag @objectstack/[email protected], lues le 2026-10-28, et du fichier source lorsque la limite est une ligne de code. La page de comparaison de ce site liste déjà les cinq charges de travail et les cinq questions en une ligne chacune ; cet article est la version longue : un scénario pour chacune, l’alternative et ses raisons, le coût, et le fait décisif.
Le test des six sortes
Un seul test couvre les cinq cas, il vaut donc la peine de l’énoncer d’abord. La page de concepts définit le cœur d’une ontologie métier exécutable comme six sortes de choses : objets et champs, relations, actions, permissions, flux, et définitions d’agents et d’outils. Le runtime dérive de ces six la base de données, l’API, l’UI et les outils d’agent, et les fait respecter à chaque appel. Le code ne disparaît pas, mais il se déplace dans le runtime, sous forme de hooks, de corps d’actions, de CEL et de JSX contraint, à l’intérieur de l’enclos que définissent les six sortes.
Demandez donc de toute charge de travail : la partie difficile est-elle l’une des six sortes ? Si la partie difficile, précieuse et risquée du travail consiste à décider ce qui existe, comment cela se relie, ce qui peut être fait, par qui, et ce qui se passe quand, l’ontologie est l’outil, et un agent peut l’écrire. Si la partie difficile est autre chose, un calcul réglementaire, une connexion à quarante systèmes, un balayage d’un pétaoctet, un solveur, le certificat d’un auditeur, alors cette partie n’est pas exprimable comme définition, et l’ontologie au mieux l’enveloppe et au pire l’imite. Appelons cela le test des six sortes. Chacune des cinq charges de travail ci-dessous l’échoue pour une raison différente, et c’est pourquoi elles ont besoin de cinq alternatives différentes plutôt que d’une seule.
1. L’ERP ou le système financier central d’une grande entreprise
Le scénario. Un industriel de quatre mille personnes fait tourner depuis douze ans son grand livre, sa consolidation et sa paie sur un ERP progiciel. Un agent de codage, à qui l’on montre le plan comptable, propose de le redéclarer en objets, avec les règles d’écriture comme flux et la fiscalité comme formules. La démo est convaincante : journaux, balance, une approbation sur chaque écriture.
Quoi utiliser à la place, et pourquoi c’est juste. Le progiciel, et construire autour. La page when-to-use : “A general ledger, consolidation, tax and payroll carry regulation and edge cases that packaged systems already encode. Build around that core, not instead of it.” (Un grand livre, la consolidation, la fiscalité et la paie portent une réglementation et des cas limites que les progiciels encodent déjà. Construisez autour de ce cœur, pas à sa place.) Sur ce marché, la réglementation est le produit. Un moteur de paie est une bibliothèque de juridictions, de calendriers déclaratifs et de corrections rétroactives, maintenue par des gens dont le seul métier est de la tenir à jour ; un moteur de consolidation, ce sont des années d’éliminations intragroupe et de cas limites de conversion de devises. Rien de cela n’est « ce qui existe et qui peut faire quoi ». C’est du calcul, et il change quand un gouvernement le change, pas quand votre entreprise change.
Le coût d’un mauvais choix. Un second grand livre. Chaque règle que vous avez réencodée est désormais votre diff à maintenir, votre audit à passer et votre défaut quand l’exercice fiscal bascule, tandis que le progiciel que vous avez gardé pour les déclarations légales s’écarte un peu plus de votre copie chaque trimestre. L’agent qui a écrit les règles en une journée ne peut pas lire un code des impôts pour vous.
Le fait décisif. La table des capacités du README liste douze choses que le runtime fournit : objets et champs, permissions, automatisation, approbations, vues, tableaux de bord et rapports, actions, API et SDK, outils AI, traductions, données d’amorçage, sources de données. Un grand livre, un moteur fiscal et un traitement de paie n’y figurent pas, et le projet ne dit pas qu’ils arrivent.
Ce qui convient, selon la même page, c’est la longue traîne autour de ce cœur : “vendor onboarding, inspections, internal requests” (intégration de fournisseurs, inspections, demandes internes), les tableurs et formulaires qui suivent ce que l’ERP ne couvre pas. Chacun devient une définition typée au lieu d’un fichier qui circule par e-mail, et chacun peut lire les données de l’ERP sans les posséder, ce qui est le cas suivant.
2. Les charges de travail dont la valeur tient à l’intégration de nombreux systèmes existants
Le scénario. Une banque veut que ses agents répondent à la question d’un client depuis le core banking, le CRM, la plateforme cartes et le système de tickets à la fois, et écrivent un statut en retour dans deux d’entre eux. Aucun de ces systèmes ne bouge. Le travail consiste à les rendre lisibles pour un agent et à agir à travers eux.
Quoi utiliser à la place, et pourquoi. Une couche au-dessus des systèmes : une couche sémantique ou de contexte pour la lecture, une ontologie opérationnelle à la manière de Palantir lorsqu’il y a une écriture en retour à gouverner. La page de comparaison le concède sans détour : “When the data already lives in a warehouse, a lakehouse and a dozen operational systems, these start where you are.” (Quand les données vivent déjà dans un entrepôt, un lakehouse et une douzaine de systèmes opérationnels, celles-ci partent de là où vous êtes.) Ces produits sont construits sur l’hypothèse que le système de référence reste en place ; leur modèle d’objets est une vue, leurs écritures sont du writeback, et leur valeur croît avec le nombre de systèmes en dessous. ObjectStack est construit sur l’hypothèse inverse : l’ontologie est le système et la base de données en est dérivée.
Le coût d’un mauvais choix. C’est le cas le plus souvent mal jugé, parce que la première semaine se passe bien. ObjectStack peut fédérer une base de données externe comme source de données avec schemaMode: 'external', et un modèle de lecture sur une table héritée est l’affaire d’un court après-midi. Puis viennent les écritures. Les écritures fédérées sont désactivées par défaut deux fois : la source de données doit déclarer external.allowWrites: true et l’objet doit déclarer external.writable: true, et “with either gate off, insert/update/delete on the federated object is rejected.” (si l’une ou l’autre porte est fermée, insert/update/delete sur l’objet fédéré est rejeté.) La porte n’est pas consultative : assertWriteAllowed s’exécute en tête de insert et update du moteur, avant les valeurs par défaut, les hooks et la validation. Ouvrez les deux portes objet par objet et vous possédez désormais une sémantique d’écriture contre un schéma que vous ne contrôlez pas, et schemaMode: 'external' fait échouer le démarrage en cas de divergence de schéma, de sorte qu’un renommage de colonne en amont met votre application hors service. Ou bien vous construisez des tâches de synchronisation à la place, et vous avez alors construit la couche d’intégration que vous essayiez de ne pas acheter, à l’intérieur d’un outil dont la propre documentation qualifie sa fédération d’“early” (précoce).
Le fait décisif. Deux opt-ins, tous deux désactivés par défaut : allowWrites sur la source de données et writable sur l’objet (content/docs/data-modeling/external-datasources.mdx, la section sur les écritures), appliqués par assertWriteAllowed dans packages/objectql/src/engine.ts.
Le chemin honnête existe, et il est étroit : connecter en lecture seule, mesurer, activer les écritures un objet à la fois, basculer objet par objet. How to move an internal system to metadata le parcourt, y compris les cas où la bonne réponse est de ne pas migrer du tout. Ce chemin est pour un système que vous comptez remplacer. Si vous comptez garder quarante systèmes et lire à travers eux, c’est la mauvaise route.
3. L’analytique sur des data lakes
Le scénario. Un distributeur a trois ans d’événements de clickstream et de points de vente dans un stockage objet, en tables Parquet et Iceberg, et l’équipe merchandising veut des tableaux de bord. Quelqu’un remarque que la plateforme a des tableaux de bord, des rapports et une couche de datasets que sa documentation qualifie de sémantique, et propose de la pointer vers le lake.
Quoi utiliser à la place, et pourquoi. La pile entrepôt : un moteur de requête conçu pour les balayages en colonnes, une couche de métriques ou sémantique par-dessus, et un outil de BI au sommet. La couche analytique d’ObjectStack est une couche de métriques pour les lignes propres de l’application. Sa documentation définit un dataset comme “a base object, the relationships to include, and the declared dimensions and measures” (un objet de base, les relations à inclure, et les dimensions et mesures déclarées), avec des jointures dérivées du graphe d’objets ; le schéma le rend littéral en décrivant l’object d’un dataset comme “Base object name” (nom de l’objet de base). La page when-to-use le dit en une phrase : la couche analytique “defines metrics over the app’s own objects for its reports and dashboards. It is not built to query a lake.” (définit des métriques sur les propres objets de l’application pour ses rapports et tableaux de bord. Elle n’est pas conçue pour interroger un lake.) Une couche sémantique d’entrepôt fait le même travail sur un lake, et la page de comparaison de ce site dit qu’une entreprise qui fait de la BI sérieuse en voudra toujours une.
Le coût d’un mauvais choix. L’une de deux copies. Soit vous chargez le lake dans des objets applicatifs, et vous avez maintenant une seconde copie de trois ans d’événements avec sa propre fraîcheur et sa propre facture, dans un magasin en lignes dérivé d’une définition métier plutôt que conçu pour les balayages ; soit vous fédérez une table d’entrepôt et découvrez que vous envoyez des questions analytiques à travers un moteur conçu pour répondre à des requêtes au niveau de la ligne pour une application, avec un pushdown des filtres et rien qui connaisse un fichier en colonnes. Les tableaux de bord s’afficheront. Ce ne seront pas ceux que l’équipe merchandising a demandés.
Le fait décisif. Les sources de données que liste le README sont PostgreSQL, MySQL, SQLite, MongoDB et en mémoire ; le répertoire des paquets, que le README confie désormais à CONTRIBUTING.md, ajoute Turso et SQLite en WebAssembly. Il n’y a ni format de lake, ni moteur en colonnes, ni pilote de stockage objet, et la couche de datasets se lie à un objet, pas à une table dans un lake.
4. Les domaines à forte composante algorithmique, comme le pricing ou l’ordonnancement
Le scénario. Le produit d’une entreprise de logistique est un optimiseur de tournées : un solveur qui prend les commandes d’une journée et une flotte et produit un plan, avec un tableau de dispatch où les planificateurs glissent des arrêts d’un véhicule à l’autre et regardent le plan se recalculer. Les commandes, véhicules, chauffeurs et plans sont manifestement des objets ; l’entreprise demande si l’ensemble pourrait être une ontologie exécutable.
Quoi utiliser à la place, et pourquoi. Du code, pour le solveur et pour le tableau, et ici la propre documentation de l’ontologie est le meilleur argument en faveur de l’alternative. La page when-to-use : l’ontologie “declares what can be done; it does not express an optimiser.” (déclare ce qui peut être fait ; elle n’exprime pas un optimiseur.) Le type d’une action est l’un de script, url, modal, flow, api ou form, et le handler d’une action script est du code qui s’exécute avec toute l’autorité de l’application sur les données. La définition possède la porte, la permission sur la porte et l’audit de qui l’a franchie. L’algorithme derrière la porte est le vôtre, dans le langage qui le résout. L’interface est la même histoire dans l’autre sens : la page de comparaison dit que la Console est “server-driven from metadata, and an interface unlike any business app is easier to build directly.” (pilotée par le serveur à partir des métadonnées, et une interface qui ne ressemble à aucune application métier est plus facile à construire directement.)
Le coût d’un mauvais choix. Construire la partie qui compte à l’endroit qui a le moins de liberté. Un solveur peut vivre derrière une action, et pour un calcul d’ordonnancement déclenché depuis un enregistrement, c’est exactement ce qu’il faut. Un tableau de dispatch ne le peut pas : le JSX contraint dans les pages “is parsed into a server-driven UI tree, never executed as code” (est analysé en un arbre d’UI piloté par le serveur, jamais exécuté comme du code), par conception, de sorte que chaque interaction dont les planificateurs ont besoin devient une négociation avec un moteur de rendu conçu pour des listes, des formulaires et des tableaux. Six mois plus tard, l’ontologie est une fine enveloppe autour de ce que vous vendez réellement.
Le fait décisif. ActionType dans packages/spec/src/ui/action.zod.ts est l’ensemble fermé script | url | modal | flow | api | form. L’algorithme n’en fait jamais partie, seulement le chemin vers lui.
Le découpage qui fonctionne : la moitié métier, commandes, véhicules, chauffeurs, qui peut approuver un plan, ce qui se passe quand un plan est publié, en ontologie, où un agent peut l’écrire et l’opérer ; le solveur en code derrière une action script, de sorte que permissions, audit et accès des agents s’y appliquent comme à toute autre action ; le tableau des planificateurs comme application à part entière. Si le tableau est le produit, commencez par là.
5. Les charges de travail qui exigent une plateforme certifiée
Le scénario. Un groupe hospitalier veut un parcours d’admission, et ses achats exigent que la plateforme sur laquelle il tourne détienne une attestation nommée. Un appel d’offres public pose la même question à propos d’un certificat ISO. La charge de travail elle-même, formulaires, routage, approbations et piste d’audit, convient comme dans un manuel.
Quoi utiliser à la place, et pourquoi. Soit une plateforme qui détient le certificat, soit un déploiement que vous certifiez vous-même, et la décision relève du calendrier de l’acheteur, pas de la feuille de route de l’éditeur. La page when-to-use : “ObjectStack is open-source software you deploy and operate, and it carries no compliance certification of its own. Where a workload must run on a certified platform, certifying your deployment is work you own.” (ObjectStack est un logiciel open source que vous déployez et exploitez, et il ne porte aucune certification de conformité propre. Lorsqu’une charge de travail doit tourner sur une plateforme certifiée, certifier votre déploiement est un travail qui vous appartient.) Ce n’est pas une esquive ; c’est ainsi que fonctionne la certification. Une attestation couvre un environnement en exploitation, ses contrôles et ses opérateurs, et un dépôt Apache-2.0 n’est rien de tout cela. La page sécurité de ce site dit la même chose de l’édition commerciale : “Certification depends on your running deployment, not a binary alone.” (La certification dépend de votre déploiement en exploitation, pas d’un binaire seul.)
Le coût d’un mauvais choix. Le découvrir au moment des achats plutôt qu’à la conception, quand le calendrier supposait déjà que la plateforme apportait son certificat. L’audit tombe alors sur votre plan, sans budget, juste avant la mise en production.
Le fait décisif. Le glossaire du projet liste même son propre kit de conformité au protocole comme “planned” (planifié), avec “no TCK program or certification mechanism in the codebase today” (aucun programme TCK ni mécanisme de certification dans le code aujourd’hui). Il n’y a rien à montrer à un auditeur sinon votre déploiement.
La charge de travail convient toujours ; l’hôte est la question. La séquence honnête est de chiffrer d’abord le travail de certification, puis de décider.
Deux autres endroits où une autre catégorie part devant
La page de comparaison ajoute deux concessions qui ne figurent pas dans la liste de ce qui ne convient pas, parce qu’elles portent sur un type de problème plutôt que sur un type de charge de travail. Les deux passent par le test des six sortes de la même manière.
Raisonner sur des données hétérogènes. Si la question est « qu’est-ce qui découle de tout ce que nous savons », avec des hiérarchies de classes, des faits dérivés et des vérifications de cohérence entre vocabulaires, c’est le travail d’une ontologie de connaissances, et ObjectStack n’a “no object inheritance, no axioms and no reasoner” (pas d’héritage d’objets, pas d’axiomes et pas de raisonneur). La clé abstract a été retirée de la spécification plutôt que laissée comme une promesse. La définition est validée, puis exécutée ; rien n’est inféré à l’exécution. L’article de définition traite pleinement cette négation.
Maturité de l’écosystème. Salesforce, Odoo et ERPNext “bring years of production use, packaged applications, app marketplaces and implementation partners. ObjectStack is younger; expect to build more of it yourself.” (apportent des années d’usage en production, des applications packagées, des places de marché et des partenaires d’intégration. ObjectStack est plus jeune ; attendez-vous à en construire davantage vous-même.) Si vous avez besoin d’une application packagée ce trimestre et d’un partenaire d’intégration dans votre ville, une plateforme plus jeune est le mauvais pari, quelle que soit la manière dont ses définitions sont écrites.
La table de décision
Chaque ligne : la charge de travail, si elle convient aujourd’hui et quoi utiliser à la place, et le seul fait qui tranche, avec sa source. « Aujourd’hui » est une date : les sources sont objectstack au tag @objectstack/[email protected], la version que npm view @objectstack/cli dist-tags a signalée comme latest le 2026-10-28, lue ce jour-là. Les sources sont nommées par fichier : when-to-use, compare et ontology sont content/docs/concepts/*.mdx ; external-datasources et analytics sont sous content/docs/data-modeling/ ; glossary est sous content/docs/getting-started/ ; engine.ts est packages/objectql/src/engine.ts ; dataset.zod.ts et action.zod.ts sont sous packages/spec/src/ui/ ; README et CONTRIBUTING.md sont à la racine du dépôt.
| Charge de travail | Convient aujourd’hui ? Quoi utiliser à la place | Le fait décisif (source) |
|---|---|---|
| ERP ou finance centrale d’une grande entreprise | Non. Le progiciel ; construire autour | La réglementation et les cas limites sont le produit ; les douze capacités du runtime n’incluent aucun moteur de grand livre, fiscal ou de paie (when-to-use ; table des capacités du README) |
| Intégrer de nombreux systèmes existants | Non. Une couche sémantique ou de contexte ; une ontologie opérationnelle là où il y a du writeback | La fédération est en lecture seule par défaut, deux fois : allowWrites sur la source de données et writable sur l’objet (external-datasources ; assertWriteAllowed dans engine.ts) |
| Analytique sur un data lake | Non. Un moteur de requête d’entrepôt, une couche de métriques, de la BI | Un dataset se lie à un objet de base ; les pilotes sont des magasins en lignes, sans format de lake (analytics ; dataset.zod.ts ; sources de données du README ; pilotes de CONTRIBUTING.md) |
| Domaine à forte composante algorithmique | Pas pour l’algorithme. Du code ; derrière une action script quand le reste est une application métier | ActionType est script, url, modal, flow, api, form ; le solveur n’est jamais un type (action.zod.ts ; when-to-use) |
| Doit tourner sur une plateforme certifiée | Pas sans un travail qui vous appartient. Une plateforme certifiée, ou certifier votre déploiement | Aucune certification de conformité propre ; même le kit de conformité est « planifié » (when-to-use ; glossary) |
| Raisonner sur des données hétérogènes | Non. Une ontologie de connaissances avec un raisonneur | Pas d’héritage, pas d’axiomes, pas de raisonneur ; abstract retiré sous ADR-0049 (ontology ; compare) |
| A besoin d’un écosystème mûr maintenant | Pas encore. Une plateforme de métadonnées avec applications packagées et partenaires | « ObjectStack est plus jeune ; attendez-vous à en construire davantage vous-même » (compare) |
| Une nouvelle application métier : CRM, tickets, approbations, opérations, outils internes | Oui. | Objets, relations, actions, permissions et flux sont l’essentiel de ce que sont ces applications (when-to-use) |
| La longue traîne autour d’un ERP central | Oui. | Petite, spécifique, change souvent ; une définition typée par application, qui lit l’ERP sans le posséder (when-to-use) |
| Un back-office opéré par des agents dès le premier jour | Oui. | Chaque déploiement est un serveur MCP, activé par défaut, sous les permissions de l’utilisateur (when-to-use ; README) |
Faites l’auto-évaluation
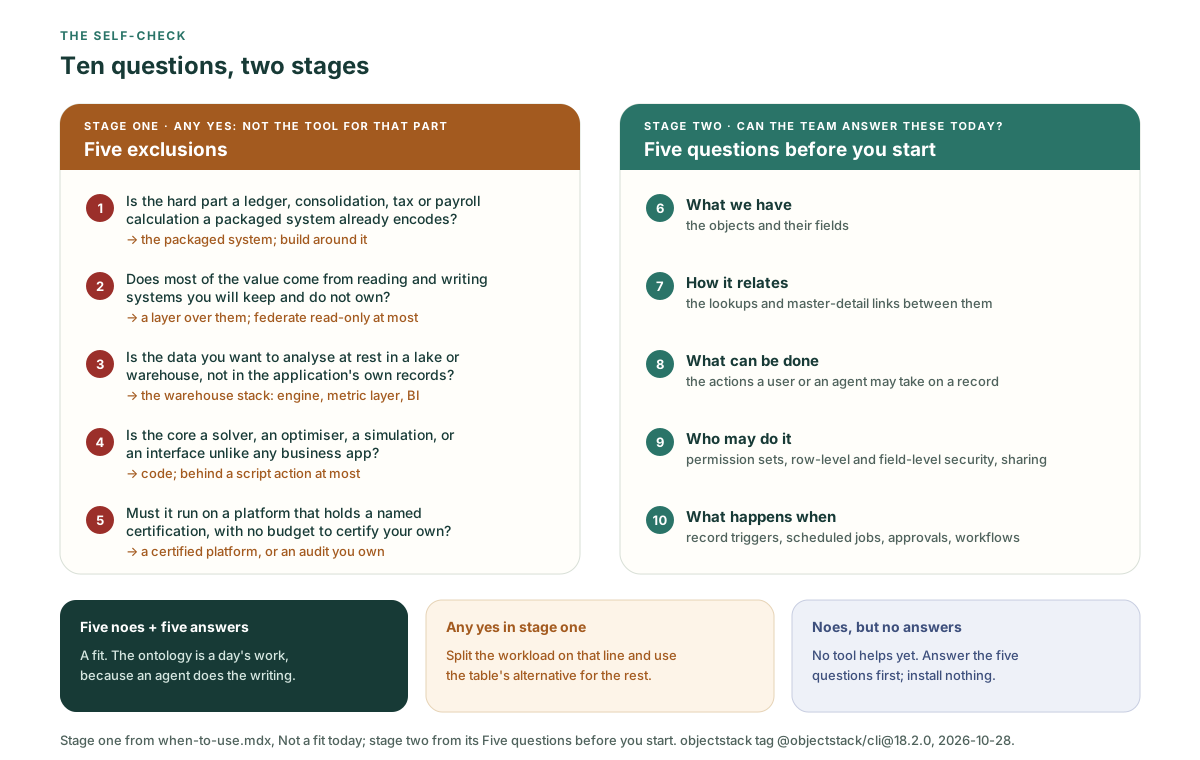
Dix questions, deux étapes, dix minutes. L’étape un est la liste d’exclusion ; l’étape deux reprend les “Five questions before you start” (Cinq questions avant de commencer) de la page when-to-use, citées telles qu’elle les imprime.
Étape un. Tout oui signifie que l’ontologie n’est pas l’outil pour cette partie.
- La partie difficile de cette charge de travail est-elle un calcul réglementé qu’un progiciel encode déjà : grand livre, consolidation, fiscalité, paie ?
- L’essentiel de la valeur vient-il de la lecture et de l’écriture de systèmes que vous garderez et ne possédez pas ?
- Les données que vous voulez analyser sont-elles au repos dans un lake ou un entrepôt plutôt que dans les propres enregistrements de l’application ?
- Le cœur du produit est-il un solveur, un optimiseur ou une simulation, ou une interface qui ne ressemble à aucune application métier ?
- La charge de travail doit-elle tourner sur une plateforme qui détient une certification nommée, sans budget pour certifier un déploiement à vous ?
Étape deux. Votre équipe peut-elle y répondre pour l’entreprise, aujourd’hui ?
- “What we have — the objects and their fields.” (Ce que nous avons : les objets et leurs champs.)
- “How it relates — the lookups and master-detail links between them.” (Comment cela se relie : les lookups et les liens maître-détail entre eux.)
- “What can be done — the actions a user or an agent may take on a record.” (Ce qui peut être fait : les actions qu’un utilisateur ou un agent peut exécuter sur un enregistrement.)
- “Who may do it — permission sets, row-level and field-level security, sharing.” (Qui peut le faire : jeux de permissions, sécurité au niveau des lignes et des champs, partage.)
- “What happens when — record triggers, scheduled jobs, approvals, workflows.” (Ce qui se passe quand : déclencheurs d’enregistrement, tâches planifiées, approbations, workflows.)
Cinq non et cinq réponses : l’ontologie est, selon les mots de la page, “a day’s work, because an agent does the writing.” (une journée de travail, parce qu’un agent fait l’écriture.) Cinq non et aucune réponse : “no tool helps yet, this one included. The first investment is answering these five questions, not installing anything.” (aucun outil n’aide encore, celui-ci compris. Le premier investissement est de répondre à ces cinq questions, pas d’installer quoi que ce soit.) Un oui à l’étape un : découpez la charge de travail selon cette ligne, gardez la partie qui a passé, et utilisez l’alternative de la table pour le reste.
Ce que cette liste ne dit pas
Elle ne dit pas que ces limites sont permanentes. La page s’intitule « not a fit today » (ne convient pas aujourd’hui), la fédération est qualifiée d’« early » (précoce), et la table ci-dessus porte une date ; relisez-la face à la page actuelle avant de décider.
Elle ne dit pas que les alternatives sont meilleures en général. Une couche sémantique est le bon outil pour lire à travers quarante systèmes et le mauvais pour faire tourner un centre de tickets, pour les raisons que la deuxième section donne dans l’autre sens. L’alternative de chaque ligne est juste pour cette ligne.
Et elle ne dit pas qu’échouer une ligne fait échouer la charge de travail. La plupart des cas réels se découpent : le parcours d’admission convient et l’hôte est une question d’achats ; le domaine du dispatch convient et le solveur est du code ; les applications départementales autour de l’ERP conviennent et le grand livre reste où il est. Le test des six sortes s’applique à la partie difficile, pas au nom du projet.
Où se situe ObjectOS dans cette liste
Rien de ce qui précède ne change avec l’édition. ObjectOS existe en trois éditions : ObjectOS Community, open source et gratuite à auto-héberger ; ObjectOS Cloud, hébergée dans le navigateur, sans rien installer ; et ObjectOS Enterprise, autogérée sur votre propre infrastructure. Votre ontologie est faite de métadonnées ObjectStack ordinaires. Son export depuis ObjectOS Cloud ou ObjectOS Enterprise, pour l’exécuter sur le runtime open source ObjectStack, est prévu. Les cinq charges de travail portent sur ce qu’une ontologie exécutable peut exprimer, pas sur l’endroit où elle tourne, donc la liste se lit de la même façon sur tout hôte. La seule question qui porte sur l’hôte, la certification, la page sécurité y répond pour ObjectOS dans les mêmes termes que la page open source : cela dépend du déploiement en exploitation.
Si votre cas a passé le test
Alors la prochaine étape la plus rapide et la plus honnête n’est pas une démo ; c’est une définition. Pointez votre agent de codage vers ObjectStack, avec le fichier de règles, le bundle de skills et le serveur d’outils couverts dans how to point your agent at ObjectStack, et demandez-lui le premier objet : quelques champs, une relation, une action, un jeu de permissions et un déclencheur. Lancez npm run validate, et lisez le diff avant de lire la Console. Si vous pouvez lire tout le diff et qu’il dit ce que fait votre entreprise, le test des six sortes a passé en pratique, et ce qu’est la définition est la page suivante à donner à l’agent. Si vous ne le pouvez pas, rien dans cet article n’allait vous aider, et vous venez d’économiser un projet.