Que signifie « L’ontologie est le logiciel » ? Une ontologie métier exécutable, définie
La phrase est le positionnement d’ObjectStack ; voici sa définition : un noyau de six sortes, quatre projections, trois choses qu’elle n’est pas, et un test pour distinguer le noyau de la projection.
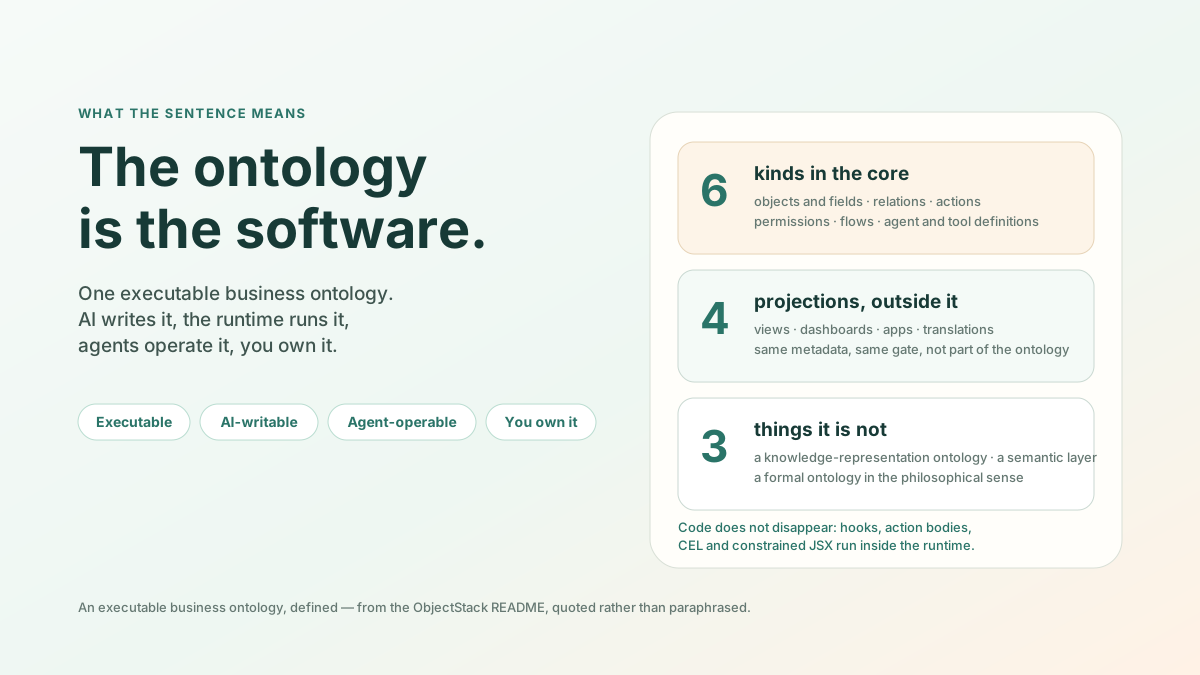
En bref. « L’ontologie est le logiciel. » est la première phrase du README d’ObjectStack, et la ligne en dessous en est la définition : « Une ontologie métier exécutable. L’AI l’écrit, le runtime l’exécute, les agents l’opèrent, vous la possédez. » Une ontologie métier exécutable est la définition de votre métier qu’un runtime exécute directement. Son noyau est fait de six sortes de choses — objets et champs, relations, actions, permissions, flux, et définitions d’agents et d’outils — compilées en un artefact, dont dérivent la base de données, l’API, l’UI et les outils d’agent. Les vues, les tableaux de bord, les apps et les traductions en sont des projections, pas des parties. Ce n’est pas une ontologie de représentation des connaissances, pas une couche sémantique posée sur vos systèmes existants, et pas une ontologie formelle au sens philosophique. Le code ne disparaît pas ; il se déplace dans le runtime, sous forme de hooks, de corps d’action, de CEL et de JSX contraint.
C’est toute l’affirmation. La suite de ce billet la démonte : pourquoi la phrase dit est et non décrit, les six sortes, les projections et un test pour les distinguer, les trois négations, où va le code, et les quatre promesses auxquelles la ligne se réduit. Les sources sont le README et la page de concepts qu’il lie, citées plutôt que paraphrasées, ainsi que l’exemple de CRM livré dans le même dépôt, mesuré plutôt que décrit.
Pourquoi la phrase dit « est »
La plupart des ontologies d’entreprise décrivent du logiciel. Elles se tiennent à côté des systèmes qui font réellement tourner le métier — un modèle du client, un graphe de ce qui se relie à quoi, une définition gouvernée de ce que signifie le chiffre d’affaires — et les systèmes continuent dessous, sans le savoir. La description est utile, et elle est aussi facultative : supprimez-la et rien ne s’arrête.
La phrase d’ObjectStack est formulée comme une identité parce que la relation est inversée. La définition est la chose qui tourne. Supprimez l’ontologie et il ne reste aucune application : pas de tables, pas d’endpoints, pas d’écrans, pas d’outils qu’un agent puisse appeler. La page de concepts met le pipeline sur une ligne :
objectstack.config.ts -> objectstack.json -> ObjectStack runtime -> database · REST / realtime API · UI · MCP serverVous rédigez des métadonnées typées dans objectstack.config.ts ; elles se compilent en l’artefact objectstack.json ; le runtime lit l’artefact et dérive le reste. La légende du README pour la même image est plus courte encore : « Une définition typée → base de données · REST API · SDK client · UI · outils MCP. » Il n’y a pas de second artefact qui soit le logiciel pendant que l’ontologie se contente d’en parler. Voilà ce que « est » veut dire ici, et tout ce qui suit en découle.
Le noyau de six sortes
La page de concepts définit le noyau comme six sortes de choses. Le tableau ci-dessous garde sa formulation dans la colonne centrale et, dans la colonne de droite, indique où chaque sorte vit dans l’exemple de CRM livré (examples/app-crm dans le dépôt ObjectStack), pour que la définition puisse être vérifiée contre une définition réelle plutôt que contre un slogan.
| Noyau | Ce qu’elle déclare | Dans l’exemple de CRM livré |
|---|---|---|
| Objets et champs | Les entités du métier et leurs attributs typés — validation, formules, valeurs par défaut, fichiers | src/objects/ : compte, contact, lead, opportunité, ligne d’opportunité, activité |
| Relations | Les lookups et les liens maître-détail entre objets | Field.lookup('crm_account', …) sur l’opportunité ; la ligne en est l’enfant maître-détail |
| Actions | Les opérations qu’un utilisateur ou un agent peut invoquer sur un enregistrement, et les conditions sous lesquelles elles apparaissent | src/actions/convert-lead.action.ts, visible seulement tant que le lead n’est pas encore converti |
| Permissions | Qui peut lire, créer, modifier et supprimer quoi — RBAC, sécurité au niveau ligne et champ, partage | src/security/sales-positions.ts : un ensemble crm_sales_user, et un profil invité qui ne peut qu’insérer des leads |
| Flux | Les processus métier — flux DAG, déclencheurs d’enregistrement, tâches planifiées, approbations, workflows | src/flows/convert-lead.flow.ts, un flux d’écran qui crée le compte et l’opportunité, puis marque le lead comme converti |
| Définitions d’agents et d’outils | Les agents d’AI livrés avec l’app, les outils qu’ils peuvent appeler, et les skills qui les façonnent | Aucune déclarée dans cet exemple. Chaque objet est déjà un outil MCP ; les actions s’inscrivent avec ai: { exposed: true } |
Une mesure, prise avec la commande que le README imprime lui-même sous « measure it yourself » : au commit 9f9510f2, la définition de l’exemple de CRM fait 1 917 lignes de TypeScript réparties sur 31 fichiers. Ces fichiers contiennent six objets, trois vues, un tableau de bord, une app, un flux de conversion de lead, une action, un hook, deux ensembles de permissions, trois positions, un paquet de traduction, une page et les données d’amorçage — l’application entière, sous forme d’un diff que vous pouvez lire. L’intérêt du nombre n’est pas qu’il soit petit dans l’absolu. C’est qu’un agent peut tenir toute la définition d’un coup et répondre « qu’est-ce qui casse si je change ceci ? » à partir de la définition elle-même, ce que le README appelle des apps assez petites pour que l’AI les tienne entières.
Le noyau est aussi, par construction, la partie qui est à vous. La page de concepts : « C’est une seule définition, ouverte et versionnée. Elle vit dans votre dépôt comme du TypeScript ordinaire, se relit comme un diff, et est spécifiée et licenciée sous Apache-2.0 — pas un graphe détenu dans le système d’un fournisseur et accessible uniquement par la console de ce fournisseur. »
Les projections, et le test de suppression
Les vues, les tableaux de bord, les apps et les traductions sont rédigés dans les mêmes métadonnées et validés par la même porte, mais ils ne font pas partie de l’ontologie. La page de concepts les appelle des projections et explique chacune en une proposition : « Une vue liste projette les champs et les permissions d’un objet sur une grille ; un tableau de bord projette des requêtes sur des objets en graphiques ; une app regroupe des objets, des vues et des actions en un produit navigable ; une traduction projette chaque libellé dans une langue. »
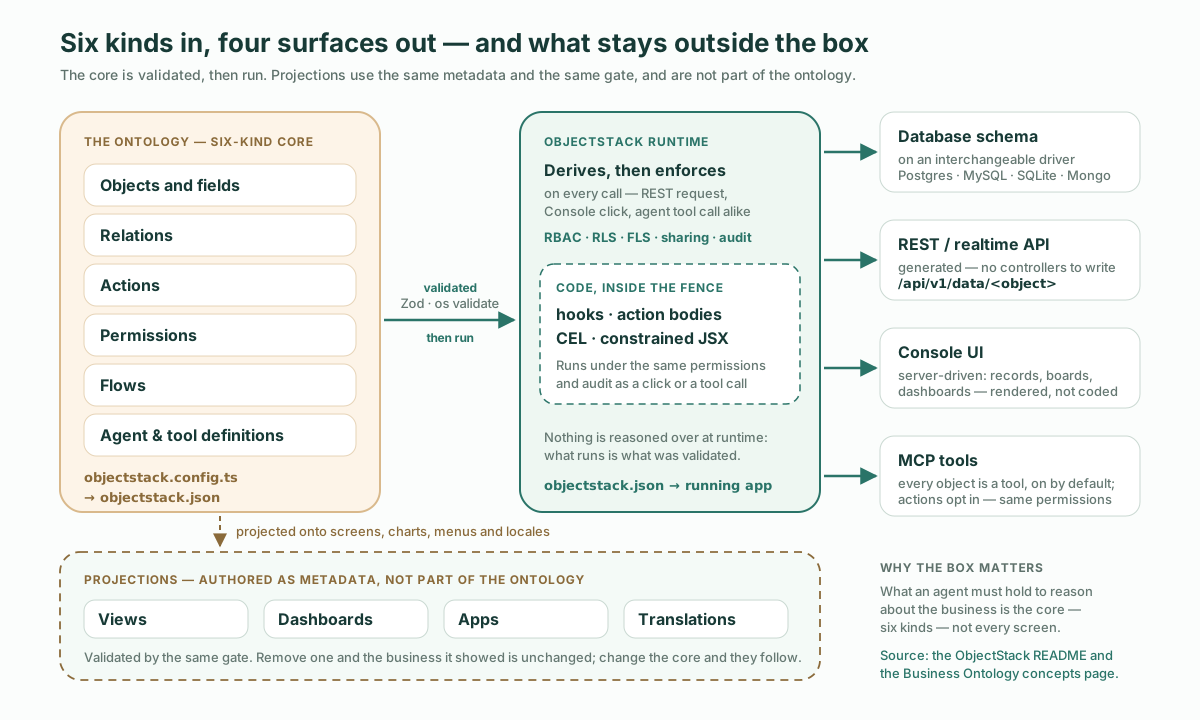
La phrase qui rend la distinction opérationnelle est celle-ci : « Changez le noyau et les projections suivent ; retirez une projection et le métier qu’elle montrait est inchangé. » Transformez-la en test et vous pourrez classer n’importe quelle définition d’un projet en un seul geste. Appelons-le le test de suppression :
Supprimez la définition. Si le schéma de base de données, l’API, ou ce qu’un utilisateur ou un agent peut faire a changé, c’était du noyau. Si seul un écran, un graphique, un menu ou un libellé a disparu, c’était une projection.
Lisez-le contre l’exemple de CRM. Supprimez src/views/opportunity.view.ts et l’objet opportunité, ses champs, ses lookups et son ensemble de permissions sont tous encore là ; l’endpoint REST répond toujours ; l’outil MCP existe toujours. Supprimez src/objects/opportunity.object.ts et la vue n’a plus rien à projeter, le flux n’a plus rien à créer, et l’ensemble de permissions nomme un objet qui n’existe plus. L’un était une projection ; l’autre était le logiciel.
Pourquoi la distinction mérite un nom est dit sur la même page : « La distinction borne ce qu’un agent doit tenir pour raisonner sur le métier : le noyau, pas chaque écran. » Un agent qui relit une modification d’un seuil d’approbation a besoin d’avoir devant lui les objets, les permissions et le flux. Il n’a pas besoin de chaque tableau de bord qui se trouve représenter le résultat.
Trois choses qu’elle n’est pas
Le mot ontologie porte des décennies de sens venus d’autres domaines, et le README consacre une bonne part de sa définition à dire lesquels de ces sens ne s’appliquent pas. Il y a trois négations, et elles sont différentes.
| Elle n’est pas | Ce qu’est cette chose | Pourquoi c’est différent ici |
|---|---|---|
| Une ontologie de représentation des connaissances | OWL, RDF et les graphes de connaissances décrivent un domaine, portent l’héritage de classes et des axiomes, et sont raisonnés par un moteur d’inférence | Pas d’héritage d’objets, pas d’axiomes, pas de raisonneur. La définition est validée — par des schémas Zod et os validate — puis exécutée. La clé abstract a été retirée de la spécification exactement pour cette raison (ADR-0049) |
| Une couche sémantique sur vos systèmes existants | Une correspondance en lecture seule au-dessus de systèmes que vous exploitez déjà : elle décrit le métier mais ne l’exécute pas | L’ontologie est le système : la base de données, l’API, l’UI et les outils d’agent en dérivent. Fédérer une source de données externe est possible, en lecture seule par défaut, et encore précoce |
| Une ontologie formelle au sens philosophique | Une affirmation sur ce qui existe en général | Elle ne fait aucune affirmation de ce genre. C’est l’application d’un seul métier, définie assez précisément pour tourner |
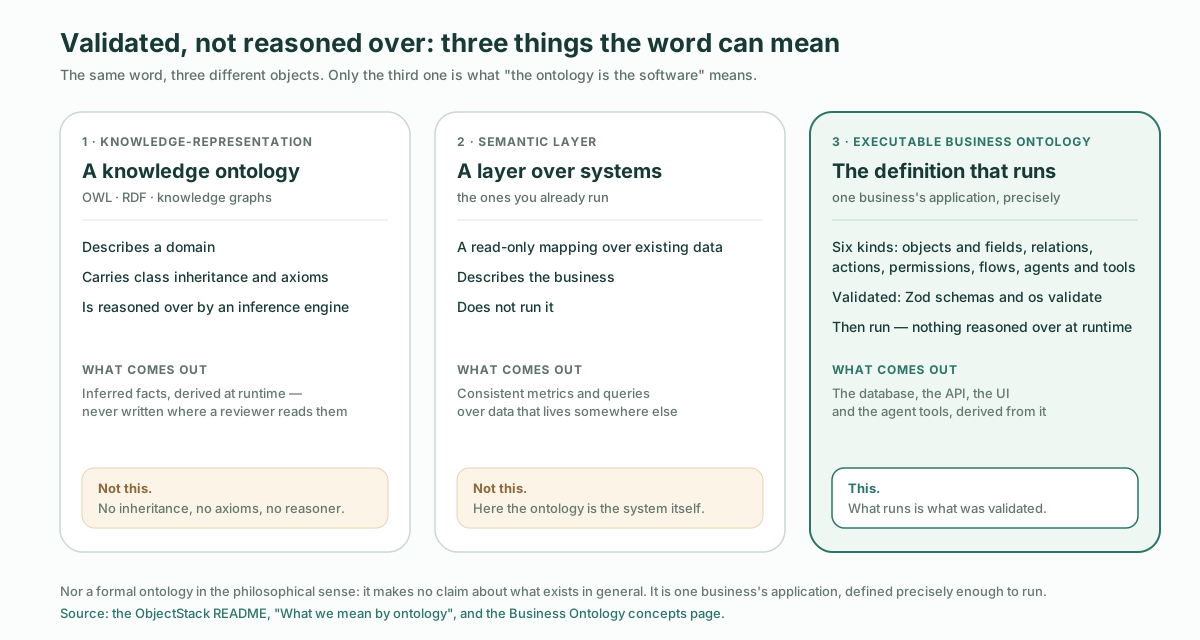
La première négation est celle qu’on manque le plus souvent, parce que c’est un choix de conception et non une limite. Un moteur d’inférence est une seconde source de vérité : les faits qu’il dérive à l’exécution n’ont jamais été écrits nulle part où un relecteur pourrait les lire. La règle d’ObjectStack, sur la page de concepts, est l’inverse : « Rien n’est raisonné à l’exécution : ce qui tourne est ce qui a été validé. » Si une permission n’est pas dans le diff, elle n’est pas dans le système.
La seconde négation compte pour quiconque évalue des plateformes, parce que le terme couche sémantique sert à désigner deux choses différentes dans les mêmes conversations. Une couche sémantique peut être une excellente définition de ce que signifie un nombre — la comparaison avec les graphes de connaissances la défend loyalement. C’est une couche de noms. Une ontologie métier exécutable porte les verbes : des actions, des permissions et des flux qui décident ce qui peut être fait, par qui, et ce qui se passe ensuite. La documentation note aussi qu’elle emploie couche sémantique dans un sens plus étroit, pour la couche de datasets analytiques à laquelle rapports et tableaux de bord se lient ; ce sens étroit concerne le reporting, et ce n’est pas ce que la phrase veut dire.
La troisième négation est la plus courte et la plus honnête. Le format ne prétend rien sur le monde. Il affirme que l’application d’un seul métier peut être énoncée assez précisément pour qu’un runtime l’exécute et qu’un relecteur la lise en entier.
Où va le code
Une définition qui est exécutée plutôt que raisonnée doit encore exprimer des choses qu’aucun schéma n’exprime : une probabilité qui passe à 100 % quand une affaire est conclue, un bouton qui disparaît une fois un lead converti, une page d’accueil avec une mise en page. La phrase du README est « le code ne disparaît pas : il se déplace dans le runtime, sous forme de hooks, de corps d’action, de CEL et de JSX contraint », et la page de concepts en donne la raison : les quatre « s’exécutent à l’intérieur de la clôture de permissions et d’audit du runtime », et « rien de tout cela n’est dispersé dans une base de code que l’ontologie devrait ensuite décrire. »
Un hook, tiré de l’exemple de CRM, est une fonction attachée au cycle de vie d’un objet :
export const OpportunityStageHook = defineHook({
  name: 'opportunity_stage_probability',
  object: 'crm_opportunity',
  events: ['beforeInsert', 'beforeUpdate'],
  priority: 100,
  handler: async (ctx: HookContext) => {
    const input = ctx.input as { stage?: string; probability?: number };
    if (input.stage === 'closed_won') input.probability = 100;
    if (input.stage === 'closed_lost') input.probability = 0;
  },
});
CEL est le langage d’expressions des formules, des prédicats et des politiques. Le même exemple l’utilise pour un champ calculé et pour la visibilité d’une action :
expected_revenue: Field.formula({
  label: 'Expected Revenue',
  expression: cel`(record.amount == null ? 0 : record.amount) * (record.probability == null ? 0 : record.probability) / 100`,
}),visible: 'has(record.status) && record.status != "converted"',Le JSX contraint est la façon d’écrire une page personnalisée, et la contrainte est tout l’enjeu : il « est analysé en un arbre d’UI piloté par le serveur, jamais exécuté comme du code. » Le paquet qui s’en charge est listé dans le README comme un compilateur qui analyse et n’exécute jamais. Les corps d’action sont le quatrième lieu, pour le travail côté serveur qu’une action effectue quand elle est invoquée.
Le motif, pour les quatre, est le même. Le code est permis ; le code n’est pas là où vit le métier. Le métier vit dans les six sortes, et le code s’exécute à l’intérieur de la clôture que ces six sortes définissent, sous les mêmes permissions et le même audit qu’un clic ou un appel d’outil.
Validée, puis exécutée
Deux verbes décrivent ce que le runtime fait de l’artefact, et la page de concepts les emploie tous deux à dessein. Il dérive : « le schéma de base de données sur un pilote interchangeable, une API REST et temps réel générée, une UI pilotée par le serveur pour la Console, et un serveur MCP ». Et il applique : « RBAC, sécurité au niveau ligne et champ, partage et audit s’appliquent de la même façon à une requête REST, à un clic dans la Console et à l’appel d’outil d’un agent. »
Le README montre le premier verbe avec un seul objet. Déclarez un ticket :
import { ObjectSchema, Field } from '@objectstack/spec/data';

export const Ticket = ObjectSchema.create({
  name: 'support_desk_ticket',
  label: 'Ticket',
  sharingModel: 'private',            // org-wide default — the security gate requires it
  fields: {
    subject: Field.text({ label: 'Subject', required: true, searchable: true }),
    status: Field.select({
      label: 'Status',
      required: true,
      options: [
        { label: 'Open', value: 'open', color: '#3B82F6', default: true },
        { label: 'Resolved', value: 'resolved', color: '#10B981' },
      ],
    }),
    due_date: Field.date({ label: 'Due Date' }),
  },
});
et « l’API REST existe dès l’instant où l’objet existe — aucun contrôleur à écrire » :
curl http://localhost:3000/api/v1/data/support_desk_ticketRemarquez sharingModel: 'private' et son commentaire. La posture de sécurité fait partie de l’objet, et la porte l’exige : os validate « rejette les métadonnées qui passent la vérification de types mais échoueraient silencieusement à l’exécution : liaisons pendantes, prédicats CEL erronés, posture de sécurité manquante. » C’est la moitié validée. La moitié exécutée, c’est que chaque surface dérivée de l’objet — la table, l’endpoint, la grille de la Console, l’outil MCP — est vérifiée contre les mêmes permissions à chaque appel, de sorte qu’un agent qui atteint le ticket par MCP voit exactement ce qu’un humain avec les mêmes permissions verrait.
Les quatre promesses, menées par « Exécutable »
Le README réduit la ligne à quatre mots : « Exécutable · Rédigeable par l’AI · Opérable par les agents · Vous la possédez ». Chacun est une affirmation avec un mécanisme derrière, et l’ordre n’est pas décoratif — le premier est ce sur quoi les trois autres reposent.
Exécutable. La définition est la chose qui tourne. Tout ce qui précède dans les deux sections ci-dessus est cette promesse : un artefact, des surfaces dérivées, l’application à chaque appel, rien de raisonné à l’exécution. Sans elle, « rédigeable par l’AI » voudrait dire une AI qui rédige de la documentation.
Rédigeable par l’AI. « L’agent écrit des métadonnées typées — pas une base de code. La porte rejette ce qui échouerait silencieusement à l’exécution, et l’agent le corrige avant même que vous le voyiez. » Le scaffolder « installe le paquet de skills d’AI et écrit un AGENTS.md, de sorte que votre agent démarre avec les règles du protocole déjà chargées ». Les quatre portes du README — typée, validée, relue, gouvernée — sont la raison pour laquelle les erreurs de l’agent ne sont pas livrées, et la raison énoncée pour laquelle cela fonctionne tout court : « les erreurs d’un agent deviennent un texte localisé et correctif qu’il peut lire et corriger lui-même ».
Opérable par les agents. « Les objets sont des outils, les actions sont des outils, les permissions décident ce qu’un agent peut appeler, et l’audit enregistre ce qu’il a fait. » L’app en cours d’exécution « la sert comme serveur MCP sur /api/v1/mcp — activé par défaut », et un agent l’opère « sous les mêmes permissions et la même RLS qu’un humain ». La même ontologie qu’un agent a écrite est ensuite utilisée par un agent, à travers la même clôture.
Vous la possédez. « Tout dans ce dépôt est la pile ouverte — protocole, micro-noyau, SDK, CLI et le runtime de production, sous Apache-2.0 sans astérisque open-core. » Et la définition elle-même « vit dans votre dépôt comme du TypeScript ordinaire, versionnée dans votre VCS et relisible comme un diff — pas un graphe détenu dans le système d’un fournisseur. » L’ontologie est un fichier que vous tenez, pas une location que vous payez.
Ce que cela ne résout pas
Un billet de définition devrait dire où la définition s’arrête.
Elle ne rend pas la modélisation facile. Décider ce qu’est une opportunité, qui peut la conclure et ce qu’exige une remise au-delà de 30 % reste le travail lent, disputé et humain que cela a toujours été ; le format décide seulement si le résultat est assez petit pour être lu en entier et assez strict pour rejeter les erreurs au moment de la rédaction.
Elle ne raisonne pas. Si votre problème a réellement besoin d’inférence sur un modèle de domaine — hiérarchies de classes, faits dérivés, un moteur qui découvre des conséquences — c’est l’ontologie de représentation des connaissances que celle-ci n’est explicitement pas. Choisissez cet outil-là, et n’attendez pas de celui-ci qu’il se dote d’un raisonneur.
Elle n’est pas une couche sur ce que vous exploitez déjà. Fédérer une source de données externe est en lecture seule par défaut et décrit comme précoce, si bien qu’une ontologie exécutable sur une base héritée commence comme un modèle de lecture et gagne les écritures objet par objet. Migrer un système interne vers des métadonnées est la version honnête de ce chemin, y compris les cas où la réponse est de ne pas migrer du tout.
Et la logique inédite reste du code. Les hooks et les corps d’action sont son lieu, à l’intérieur de la clôture, et c’est encore du code qu’un humain doit relire. L’ontologie rend ce code plus petit et borné ; elle ne le fait pas disparaître, et le README le dit en ces termes.
Hébergée, ou sur votre propre infrastructure
Le README décrit la boucle ci-dessus — un agent de code écrit les métadonnées dans votre dépôt et opère l’app en cours d’exécution via MCP — puis dit : « Vous voulez la même boucle, hébergée, dans le navigateur, sans rien installer ? C’est ObjectOS, l’environnement d’exécution commercial construit sur ObjectStack. » ObjectOS fonctionne hébergé dans le navigateur, sans rien installer (ObjectOS Cloud), ou autogéré sur votre propre infrastructure (ObjectOS Enterprise) ; dans les deux éditions, vous pouvez exporter votre ontologie et l’exécuter sur le runtime open source ObjectStack. C’est la quatrième promesse, énoncée comme une frontière de produit : l’ontologie est à vous sur chaque hôte où elle tourne.
Commencez par le chemin de l’agent
Rien de ce qui précède ne vous demande de prendre la définition sur parole ; le chemin de cinq minutes du README lui-même en produit une que vous pouvez lire.
npm create objectstack@latest my-app && cd my-appOuvrez le projet dans votre agent de code et décrivez le besoin. L’exemple du README est un centre de support : un objet ticket avec un sujet, une description, un sélecteur de priorité et un sélecteur de statut ; une action Resolve qui n’apparaît que sur les tickets pas encore résolus ; une vue liste « Open tickets » et un groupe de navigation Support ; npm run validate quand c’est terminé. Puis prévisualisez le résultat :
npx os dev --ui # → http://localhost:3000/_console/Regardez le diff produit par l’agent avant de regarder la Console. L’objet, l’action et son prédicat de visibilité, la vue — vous pourrez classer chaque ligne en noyau ou projection avec le test de suppression, et la porte aura déjà refusé les lignes qui ne tourneraient pas. Si l’agent a besoin d’être guidé, comment le configurer pour ObjectStack couvre le fichier de règles, le paquet de skills et le serveur d’outils. La définition qu’il écrit est le logiciel, et elle est dans votre dépôt.