Ontologie exécutable vs ontologie de connaissances : pourquoi « sans héritage, sans axiomes, sans raisonneur » est tout l’enjeu
Une ontologie de connaissances est faite pour être raisonnée ; une ontologie métier exécutable, pour être validée et exécutée. La preuve : une clé, abstract, qui promettait l’héritage, ne faisait rien et a été retirée, pas gardée.
Une ontologie de connaissances est faite pour qu’on raisonne dessus. Une ontologie métier exécutable est faite pour être validée, relue et exécutée. Le README d’ObjectStack formule la différence en trois refus — « no inheritance, no axioms, no reasoner » (sans héritage, sans axiomes, sans raisonneur) — et ces refus ne sont pas un trou dans une feuille de route. Ils sont ce qui rend chaque définition vérifiable et chaque diff relisible : une clé que vous pouvez écrire a un lecteur dans le runtime, ou bien elle est retirée. Cet article défend cet argument en entier, et la preuve tient en une clé.
Voici la clé. Un objet marqué abstract, comme peut l’être une classe dans une ontologie de connaissances :
export const Party = ObjectSchema.create({
  name: 'crm_party',
  label: 'Party',
  abstract: true,
  sharingModel: 'private',
  fields: { name: Field.text({ label: 'Name', required: true }) },
});
Sur @objectstack/[email protected], publiée le 2026-07-17, cette définition est parsée et abstract revient à true. Sur @objectstack/[email protected], la version actuelle, elle est refusée :
Unrecognized key(s) on this object: `abstract`.
  • `abstract` was removed from the spec (ADR-0049) — object inheritance/abstraction is not implemented, so an abstract object still got a table and was instantiable. Remove the key.
Rien n’a été construit entre-temps. Aucun héritage n’est arrivé. Ce qui a changé, c’est qu’une clé que le runtime n’a jamais lue a été retirée de la spec, avec un message qui dit pourquoi. Tout ce qui suit est l’argument de pourquoi c’est le bon geste pour une sorte d’ontologie et serait le mauvais pour l’autre, tiré du README, de la page de concepts Business Ontology, de l’enregistrement de décision qui régit le retrait et des paquets publiés — mesuré plutôt que décrit.
Deux ontologies, deux métiers
Le mot ontologie désigne deux objets différents dans les mêmes conversations, et l’article pilier l’avait listé comme la première des trois choses qu’une ontologie métier exécutable n’est pas. Le paragraphe du README sur le sujet est assez court pour être cité en entier :
Your app’s definition — objects and fields, relations, actions, permissions, flows, and agent and tool definitions — is a business ontology: open, versioned, and yours, not code scattered across a framework. It is executable, not a knowledge-representation ontology: no inheritance, no axioms, no reasoner — validated rather than reasoned over — and it is not a semantic layer over your existing systems (federating an external datasource is read-only by default and early).
— objectstack README.md, “What we mean by ontology”
(En substance : la définition de votre app — objets et champs, relations, actions, permissions, flux, et définitions d’agents et d’outils — est une ontologie métier : ouverte, versionnée et à vous, pas du code éparpillé dans un framework. Elle est exécutable, pas une ontologie de représentation des connaissances : sans héritage, sans axiomes, sans raisonneur — validée plutôt que raisonnée — et ce n’est pas une couche sémantique au-dessus de vos systèmes existants ; fédérer une source de données externe est en lecture seule par défaut et encore à ses débuts.)
Prenons les deux sortes l’une après l’autre, et prenons la première au sérieux, car c’est la plus ancienne et la plus rigoureuse des deux.
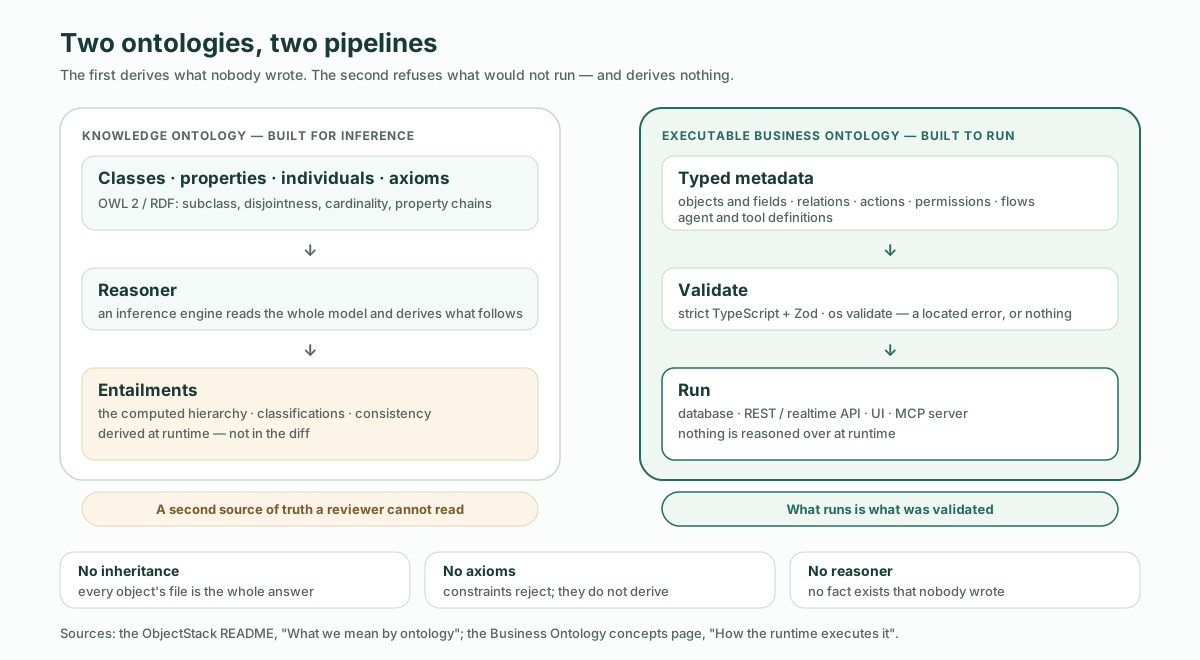
Une ontologie de connaissances est faite pour l’inférence. Dans OWL 2 du W3C et la pile RDF en dessous, vous écrivez des classes, des propriétés et des axiomes : cette classe est une sous-classe de celle-là ; ces deux classes sont disjointes ; cette propriété a au plus une valeur ; cette chaîne de propriétés implique cette autre propriété. Puis un raisonneur lit le modèle entier et dérive ce qui en découle. La hiérarchie de classes est calculée, pas seulement déclarée. Un individu est classé d’après ce qu’on sait de lui, pas d’après la classe que quelqu’un a tapée. Les contradictions entre axiomes sont détectées. Et le tout fonctionne sous l’hypothèse du monde ouvert : un fait absent est inconnu, pas faux. C’est exactement la bonne conception quand les données viennent de nombreuses sources, que le vocabulaire doit être partagé entre institutions et que la question est « que découle-t-il de tout ce que nous savons ? ». La comparaison avec les couches sémantiques et les graphes de connaissances rend justice à cette tradition ; cet article n’a besoin que de sa silhouette.
Une ontologie métier exécutable est faite pour que du logiciel puisse être généré, validé, relu et exécuté. La page de concepts donne le pipeline en une ligne :
objectstack.config.ts -> objectstack.json -> ObjectStack runtime -> database · REST / realtime API · UI · MCP serveret la règle qui le régit en une autre : « Nothing is reasoned over at runtime: what runs is what was validated. » (Rien n’est raisonné à l’exécution : ce qui tourne est ce qui a été validé.) La définition est l’application d’une entreprise, rédigée en métadonnées typées, vérifiée par des schémas Zod et par os validate, puis exécutée. Il n’y a pas de second artefact de faits dérivés. Le monde est clos par construction : ce que la définition dit est ce que le système fait, et ce qu’elle ne dit pas, le système ne le fait pas.
| Ontologie de connaissances | Ontologie métier exécutable | |
|---|---|---|
| Faite pour | L’inférence sur un domaine décrit | Générer, valider, relire et exécuter une application |
| Unité de définition | Classes, propriétés, individus, axiomes | Objets et champs, relations, actions, permissions, flux, définitions d’agents et d’outils |
| Ce qui lit une définition | Un raisonneur, qui dérive des conséquences du modèle entier | Un lecteur runtime nommé par clé — le driver de base de données, l’API, l’évaluateur de permissions, la Console, le serveur MCP |
| Ce qui existe à l’exécution sans que personne l’ait écrit | Des faits inférés : la hiérarchie calculée, les classifications, les conséquences | Rien. « Ce qui tourne est ce qui a été validé. » |
| Comment une définition fausse échoue | Une incohérence que le raisonneur signale, ou une conséquence que personne n’attendait | Une erreur localisée au moment de la rédaction, avant que quoi que ce soit ne tourne |
| Où regarder pour savoir ce que fait le système | Le modèle et ce qu’il implique | Le diff |
Les deux colonnes ne sont pas un classement. Ce sont deux réponses à deux questions, et la seconde — un relecteur peut-il dire ce que fait ce changement, et un runtime peut-il refuser une définition qui ne fonctionnerait pas — est celle à laquelle une application doit répondre.
Les trois refus, un par un
Chaque refus retire quelque chose qu’une ontologie de connaissances a raison d’avoir. Chacun est là à cause de ce qu’il coûterait à un relecteur et à une porte de validation.
Sans héritage
Dans une hiérarchie de classes, un enfant hérite des restrictions de son parent, et c’est un raisonneur qui vous dit l’ensemble complet avec lequel une classe donnée finit. Pour un vocabulaire, c’est une fonctionnalité : déclarer le cas général une fois et laisser le moteur le propager. Pour une définition d’application, c’est un coût payé par le lecteur. Un changement d’une ligne sur un parent change le comportement de chaque enfant, dont aucun n’apparaît dans le diff, et la question « qu’est-ce que cet objet impose réellement ? » ne peut pas trouver de réponse dans le fichier de l’objet lui-même.
Les objets d’ObjectStack n’héritent pas. La page de concepts liste comme seuls types de lien entre objets « Lookups and master-detail links between objects » (des lookups et des liens maître-détail entre objets) — des relations entre enregistrements, déclarées sur l’objet qui les porte. La table, les champs, les permissions et la posture de sécurité de chaque objet sont énoncés sur cet objet, donc le fichier est toute la réponse et le diff est tout le changement.
Sans axiomes
Un axiome est une contrainte que le raisonneur utilise pour dériver : de « chaque commande a exactement un client » et d’une commande qui en a deux, il conclut que les deux clients sont le même individu, ou que le modèle est incohérent. Une ontologie exécutable a aussi des contraintes — champs obligatoires, options de sélection, cibles de lookup, prédicats CEL, la posture de sécurité que chaque objet doit déclarer — mais elles servent à refuser, pas à dériver. La seconde porte du README est cette phrase : os validate « rejects metadata that type-checks but would fail silently at runtime: dangling bindings, bad CEL predicates, missing security posture » (refuse les métadonnées qui passent le typage mais échoueraient silencieusement à l’exécution : liaisons pendantes, prédicats CEL erronés, posture de sécurité manquante). Une définition qui viole une contrainte n’acquiert pas une conséquence. Elle acquiert une erreur, avec un emplacement.
Sans raisonneur
C’est le refus que les deux autres servent. Un moteur d’inférence est une seconde source de vérité : les faits qu’il dérive à l’exécution n’ont jamais été écrits nulle part où un relecteur pourrait les lire. « Nothing is reasoned over at runtime: what runs is what was validated » est la règle de la page de concepts, et sa forme pratique est celle que l’article pilier a donnée : si une permission n’est pas dans le diff, elle n’est pas dans le système. Le runtime dérive des surfaces à partir de l’artefact — le schéma, l’API, l’UI, les outils MCP — et impose la définition à chaque appel. Il ne conclut rien que la définition n’ait pas dit.
La preuve : une clé qui promettait l’héritage et ne faisait rien
Refuser un raisonneur est facile à dire et coûteux à tenir, parce que la chose la plus simple à faire d’une clé qui ressemble à une fonctionnalité est de la laisser dans le schéma et de laisser quelque chose, plus tard, lui donner un sens. abstract est à quoi cela ressemble, et à quoi ressemble le contraire.
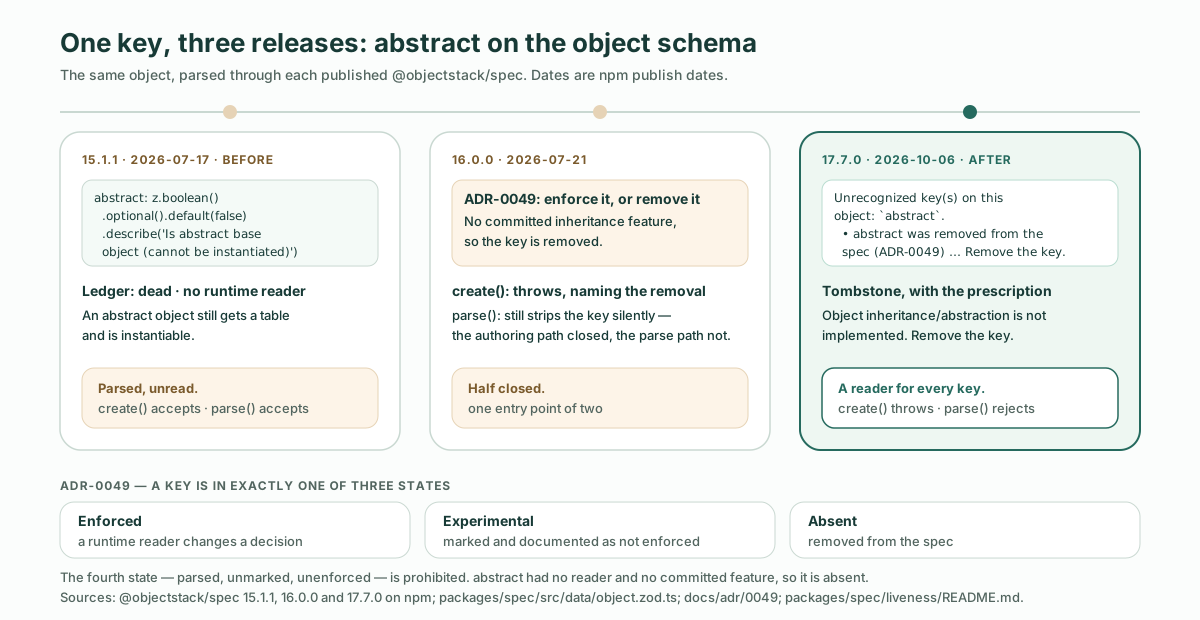
Avant : déclarée, parsée, non lue
Dans @objectstack/[email protected], le schéma d’objet déclarait la clé, avec une description qui est la définition d’école d’une classe abstraite :
abstract: z.boolean().optional().default(false).describe("Is abstract base object (cannot be instantiated)")Le formulaire d’objet du Studio la listait comme champ booléen, avec le texte d’aide « Abstract base (cannot be instantiated) ». Et le registre de vitalité (liveness ledger) du même paquet — le fichier que le projet tient pour dire, clé par clé, si un lecteur runtime existe — disait ceci à son sujet :
"abstract": {
  "status": "dead",
  "evidence": "no runtime reader",
  "authorWarn": true,
  "authorHint": "No runtime reader — an abstract object still gets a table and is instantiable. Object inheritance/abstraction is not implemented."
}
Donc en 15.1.1, la clé était parsée, le formulaire la proposait, la sortie parsée portait abstract: true, et — selon les mots du registre — un objet abstrait « still gets a table and is instantiable » (obtient quand même une table et reste instanciable), exactement comme si la ligne n’était pas là. Dans une ontologie de connaissances, une classe abstraite est un énoncé que le raisonneur honore. Ici, c’était un énoncé que rien n’honorait : une syntaxe valide, une ligne plausible dans un diff, et aucun lecteur.
La règle : imposée, expérimentale ou absente
L’enregistrement de décision qui régit cela est ADR-0049. Il a été écrit à propos des propriétés de sécurité, après un audit qui « found that roughly half of all spec properties are dead » (a constaté qu’environ la moitié de toutes les propriétés de la spec sont mortes), et il énonce la règle en trois états :
- Enforced — a runtime consumer reads it and changes a decision (
file:line).
experimental — explicitly marked and documented as not yet enforced, so authoring it is a known no-op (roadmapped, not a promise).- Absent — removed from the spec.
Shipping a security property in a fourth state — parsed, unmarked, unenforced — is prohibited. This is the enforce-or-remove gate.
(En substance : Imposée — un consommateur runtime la lit et change une décision (file:line). experimental — explicitement marquée et documentée comme pas encore imposée, de sorte que l’écrire est une non-opération connue (sur la feuille de route, pas une promesse). Absente — retirée de la spec. Livrer une propriété de sécurité dans un quatrième état — parsée, non marquée, non imposée — est interdit. C’est la porte « imposer ou retirer ».)
Sa raison est celle qui compte pour n’importe quelle clé, pas seulement une clé de sécurité : « A security property that parses but does nothing is worse than absent: it produces a false sense of compliance. » (Une propriété de sécurité qui est parsée mais ne fait rien est pire qu’absente : elle produit un faux sentiment de conformité.) Et sa valeur par défaut, là où aucune fonctionnalité n’est engagée, est le retrait : « Removal is preferred over marking when there is no committed roadmap for the property — a smaller spec surface is the stronger default pre-MVP. » (Le retrait est préféré au marquage quand il n’y a pas de feuille de route engagée pour la propriété — une surface de spec plus petite est la valeur par défaut la plus solide avant le MVP.) abstract n’est pas une clé de sécurité ; la note de portée de l’ADR lui-même consigne que le dépôt « cites this ADR as the enforce-or-remove policy for spec-property retirement generally » (cite cet ADR comme la politique « imposer ou retirer » pour le retrait des propriétés de spec en général), et l’ordre de travail qui l’a retirée, #2377, dit pourquoi cette généralité est délibérée : « Authoring them is a false affordance — especially dangerous for AI-authored metadata. » (Les écrire est une fausse affordance — particulièrement dangereuse pour des métadonnées écrites par l’AI.)
Après : une pierre tombale qui vous dit quoi faire
Le retrait a été livré en 16.0.0. Le changelog du paquet le consigne en une phrase : « object tags/active/abstract: ObjectSchema.create() now throws a located error naming the removal. None gated anything at runtime — remove them. » (ObjectSchema.create() lève désormais une erreur localisée qui nomme le retrait. Aucune ne gardait quoi que ce soit à l’exécution — retirez-les.) Aujourd’hui, la clé est une pierre tombale dans les indications de clés inconnues du schéma d’objet, et le message que verra tout auteur qui l’écrit est celui du début de cet article, tiré de object.zod.ts :
abstract:
  '`abstract` was removed from the spec (ADR-0049) — object ' +
  'inheritance/abstraction is not implemented, so an abstract object still ' +
  'got a table and was instantiable. Remove the key.',
La ligne objet du registre de vitalité garde la trace : « tags/active/abstract REMOVED (#2377) — tombstoned in UNKNOWN_KEY_GUIDANCE ». L’avant et l’après ont été mesurés sur les paquets publiés, en parsant l’objet Party ci-dessus à travers chacun d’eux :
@objectstack/spec | ObjectSchema.create() | ObjectSchema.safeParse() |
|---|---|---|
| 15.1.1 (2026-07-17) | Accepte ; abstract: true conservé | Accepte ; abstract: true conservé |
| 16.0.0 (2026-07-21) | Lève une erreur nommant le retrait | Accepte ; abstract retiré silencieusement |
| 17.7.0 (2026-10-06) | Lève une erreur nommant le retrait | Refuse : unrecognized_keys, avec la prescription |
La ligne du milieu mérite une phrase. En 16.0.0, le chemin de rédaction était fermé et le chemin de parsing ne l’était pas — parse() laissait encore tomber la clé sans un mot, le comportement que les commentaires du schéma lui-même font remonter au .strip() par défaut de Zod et à #1535, où un workflows: [...] au niveau objet « vanished with no error, no warning, and a green tsc » (a disparu sans erreur, sans avertissement, et avec un tsc au vert). Le message de 17.x le dit lui-même, dans sa dernière phrase : « Until this shape was closed these were dropped silently on the PARSE path — ObjectSchema.create() has rejected them, but defineStack({ objects }), /api/v1/meta/types/object and the Studio form all go through parse(), which did not. » (Jusqu’à ce que cette forme soit fermée, elles étaient abandonnées silencieusement sur le chemin de PARSE — ObjectSchema.create() les a refusées, mais defineStack({ objects }), /api/v1/meta/types/object et le formulaire du Studio passent tous par parse(), qui ne le faisait pas.) Fermer une clé n’est pas une décision ; c’est une décision par point d’entrée, et une porte complète sur l’un et muette sur l’autre est le quatrième état sous un autre manteau.
Pourquoi c’est tout l’enjeu
Au moment où le registre disait « no runtime reader », il y avait deux gestes honnêtes. Construire l’héritage d’objets, pour que abstract: true ait un lecteur et un sens. Ou retirer la clé. L’habitude de l’ontologie de connaissances — et c’est une habitude, pas une erreur, dans la tradition dont elle vient — est de garder la déclaration, parce que dans cette tradition le sens vit dans le modèle et le moteur l’honorera. L’habitude exécutable est l’inverse : l’ensemble des clés que vous pouvez écrire est l’ensemble des choses que fait le runtime, et une clé sans lecteur n’est pas une fonctionnalité en attente, c’est la fausse croyance d’un relecteur en attente.
Appelons cela un lecteur pour chaque clé. C’est la forme concrète de « validée plutôt que raisonnée ». Un validateur ne peut être complet que sur un vocabulaire où chaque terme a un consommateur ; dès qu’un terme est parsé sans être lu, « valide » cesse de vouloir dire « fera ce qu’il dit ». Le retrait d’abstract n’a pas rendu l’ontologie plus petite pour le plaisir. Il a tenu la promesse qu’une définition qui passe la porte est une définition que le runtime imposera.
Ce qu’obtient un relecteur, et ce qu’obtient un agent
Pour l’humain qui relit un changement, le bénéfice est que le diff est le comportement. Pas de parent à ouvrir, pas de conséquence à calculer, pas de clé dont l’effet dépend d’une fonctionnalité qui existe peut-être, ou peut-être pas. Si sharingModel: 'private' est dans le diff, les enregistrements sont privés ; si une permission n’est pas dans le diff, personne ne l’a. À la question « que fait cette ligne ? » répond le lecteur runtime que cette ligne possède, et une ligne sans lecteur ne peut pas du tout être dans le diff.
Pour l’agent qui écrit le changement, le bénéfice est le même fait vu de l’autre côté. L’affirmation du README sur la raison pour laquelle les métadonnées écrites par l’AI fonctionnent est que « an agent’s errors become located, corrective text it can read and fix itself » (les erreurs d’un agent deviennent un texte localisé et correctif qu’il peut lire et corriger lui-même). Une fausse affordance défait exactement cela : un agent qui apprend un format à partir de ses exemples ne peut pas distinguer une clé imposée d’une clé parsée, parce que les deux valident, les deux ont l’air faisant autorité, et les deux apparaissent dans les échantillons — l’échec que l’entrée déclaré vs imposé décrit comme des déclarations valides, plausibles et inertes. Retirer la clé, et laisser une pierre tombale qui se termine par « Remove the key. », transforme cet échec en une correction d’une ligne que l’agent peut effectuer sans qu’un humain remarque qu’il y a eu un problème.
Pour la défense du raisonneur : ce que cela ne fait pas
Une version honnête de cet argument doit dire ce à quoi l’ontologie exécutable renonce, parce qu’elle renonce à des choses réelles.
Elle ne raisonne pas. Pas de conséquences dérivées, pas de classification par description, pas de vérification de cohérence sur un modèle. Si un fait dérivé est le produit dont vous avez besoin — « lequel de ces dix mille enregistrements est, d’après ce que nous en savons, une instance de contrepartie à haut risque ? » — un raisonneur y répond et un validateur non.
Elle ne fait pas d’inférence en monde ouvert. Le monde clos est tout l’intérêt de la conception, et c’est la mauvaise hypothèse pour des données partielles par nature : un vocabulaire partagé entre organisations, un enregistrement qui est vrai alors que votre système n’a jamais vu le fait qui le rend vrai. Une ontologie de connaissances est faite pour ce cas, et celle-ci non.
Elle ne fait pas d’héritage au niveau du schéma. Il n’y a pas d’objet de base. Un champ que six objets partagent est déclaré sur six objets, ou modélisé explicitement comme un lookup vers un objet partagé. La répétition est délibérée — c’est ce qui fait du fichier de chaque objet toute la réponse — et cela reste une répétition, avec le coût de maintenance qu’a la répétition.
Elle ne décide pas que deux choses sont la même chose. Que le « client » d’un système et le « compte » d’un autre soient une seule entité est une déclaration que quelqu’un doit faire, pas une inférence que tire le runtime ; l’article sur l’ontologie d’entreprise explique pourquoi cet alignement reste du travail dans n’importe quel modèle.
Et une limite appartient à la discipline elle-même plutôt qu’au format : « validé » n’est vrai qu’autant que le sont les validateurs. L’audit derrière ADR-0049 a trouvé la moitié des propriétés de la spec mortes avant que la règle n’existe ; le registre de vitalité et les portes qui le lisent sont ce qui garde la règle vraie ensuite, et c’est une maintenance permanente, pas un état atteint une fois pour toutes. L’histoire d’abstract est la preuve que la discipline est pratiquée, pas qu’elle est achevée.
Hébergé, ou sur votre propre infrastructure
Le README décrit cette boucle — un agent écrit des métadonnées typées dans votre dépôt, la porte refuse ce qui ne tournerait pas, le runtime exécute ce qui est passé — puis dit : « Pour l’exécuter, le dépôt ObjectStack fournit ObjectOS Community — l’image ghcr.io/objectstack-ai/objectstack, os start et la Console, gratuite et auto-hébergée — tandis qu’ObjectOS Cloud est l’édition hébergée et ObjectOS Enterprise l’édition autogérée, sous licence. » Votre ontologie est faite de métadonnées ObjectStack ordinaires. Son export depuis ObjectOS Cloud ou ObjectOS Enterprise, pour l’exécuter sur le runtime open source ObjectStack, est prévu. La porte est la même sur chaque hôte, et l’ontologie qu’elle garde aussi.
Essayez le refus vous-même
Le chemin agent du README produit l’artefact dont parle cet article en quelques minutes, et le refus est la partie qui vaut d’être vue.
npm create objectstack@latest my-app && cd my-appOuvrez le projet dans votre agent de code et décrivez un objet métier — un client, un ticket, un ordre de travail. Puis demandez la ligne par laquelle cet article a commencé : ajoutez-lui abstract: true, parce qu’il va servir de base à d’autres objets. Quelle que soit la porte qui l’atteint en premier, celle du typage dans l’éditeur ou ObjectSchema.create() au build, elle le refuse avec le message cité plus haut, et le message se termine par la correction. Laissez l’agent appliquer la correction, puis prévisualisez le résultat :
npx os dev --ui # → http://localhost:3000/_console/Ce que vous trouverez dans le diff, c’est un objet sans base, sans rien d’hérité, et sans aucune clé que le runtime ne lit pas — autrement dit, une définition assez petite pour être relue et assez stricte pour être exécutée. Si l’agent a besoin d’être guidé, comment le pointer vers ObjectStack couvre le fichier de règles, le bundle de skills et le serveur d’outils. Les trois refus du README ne sont pas ce qui manque au format. Ils sont ce qu’il impose.